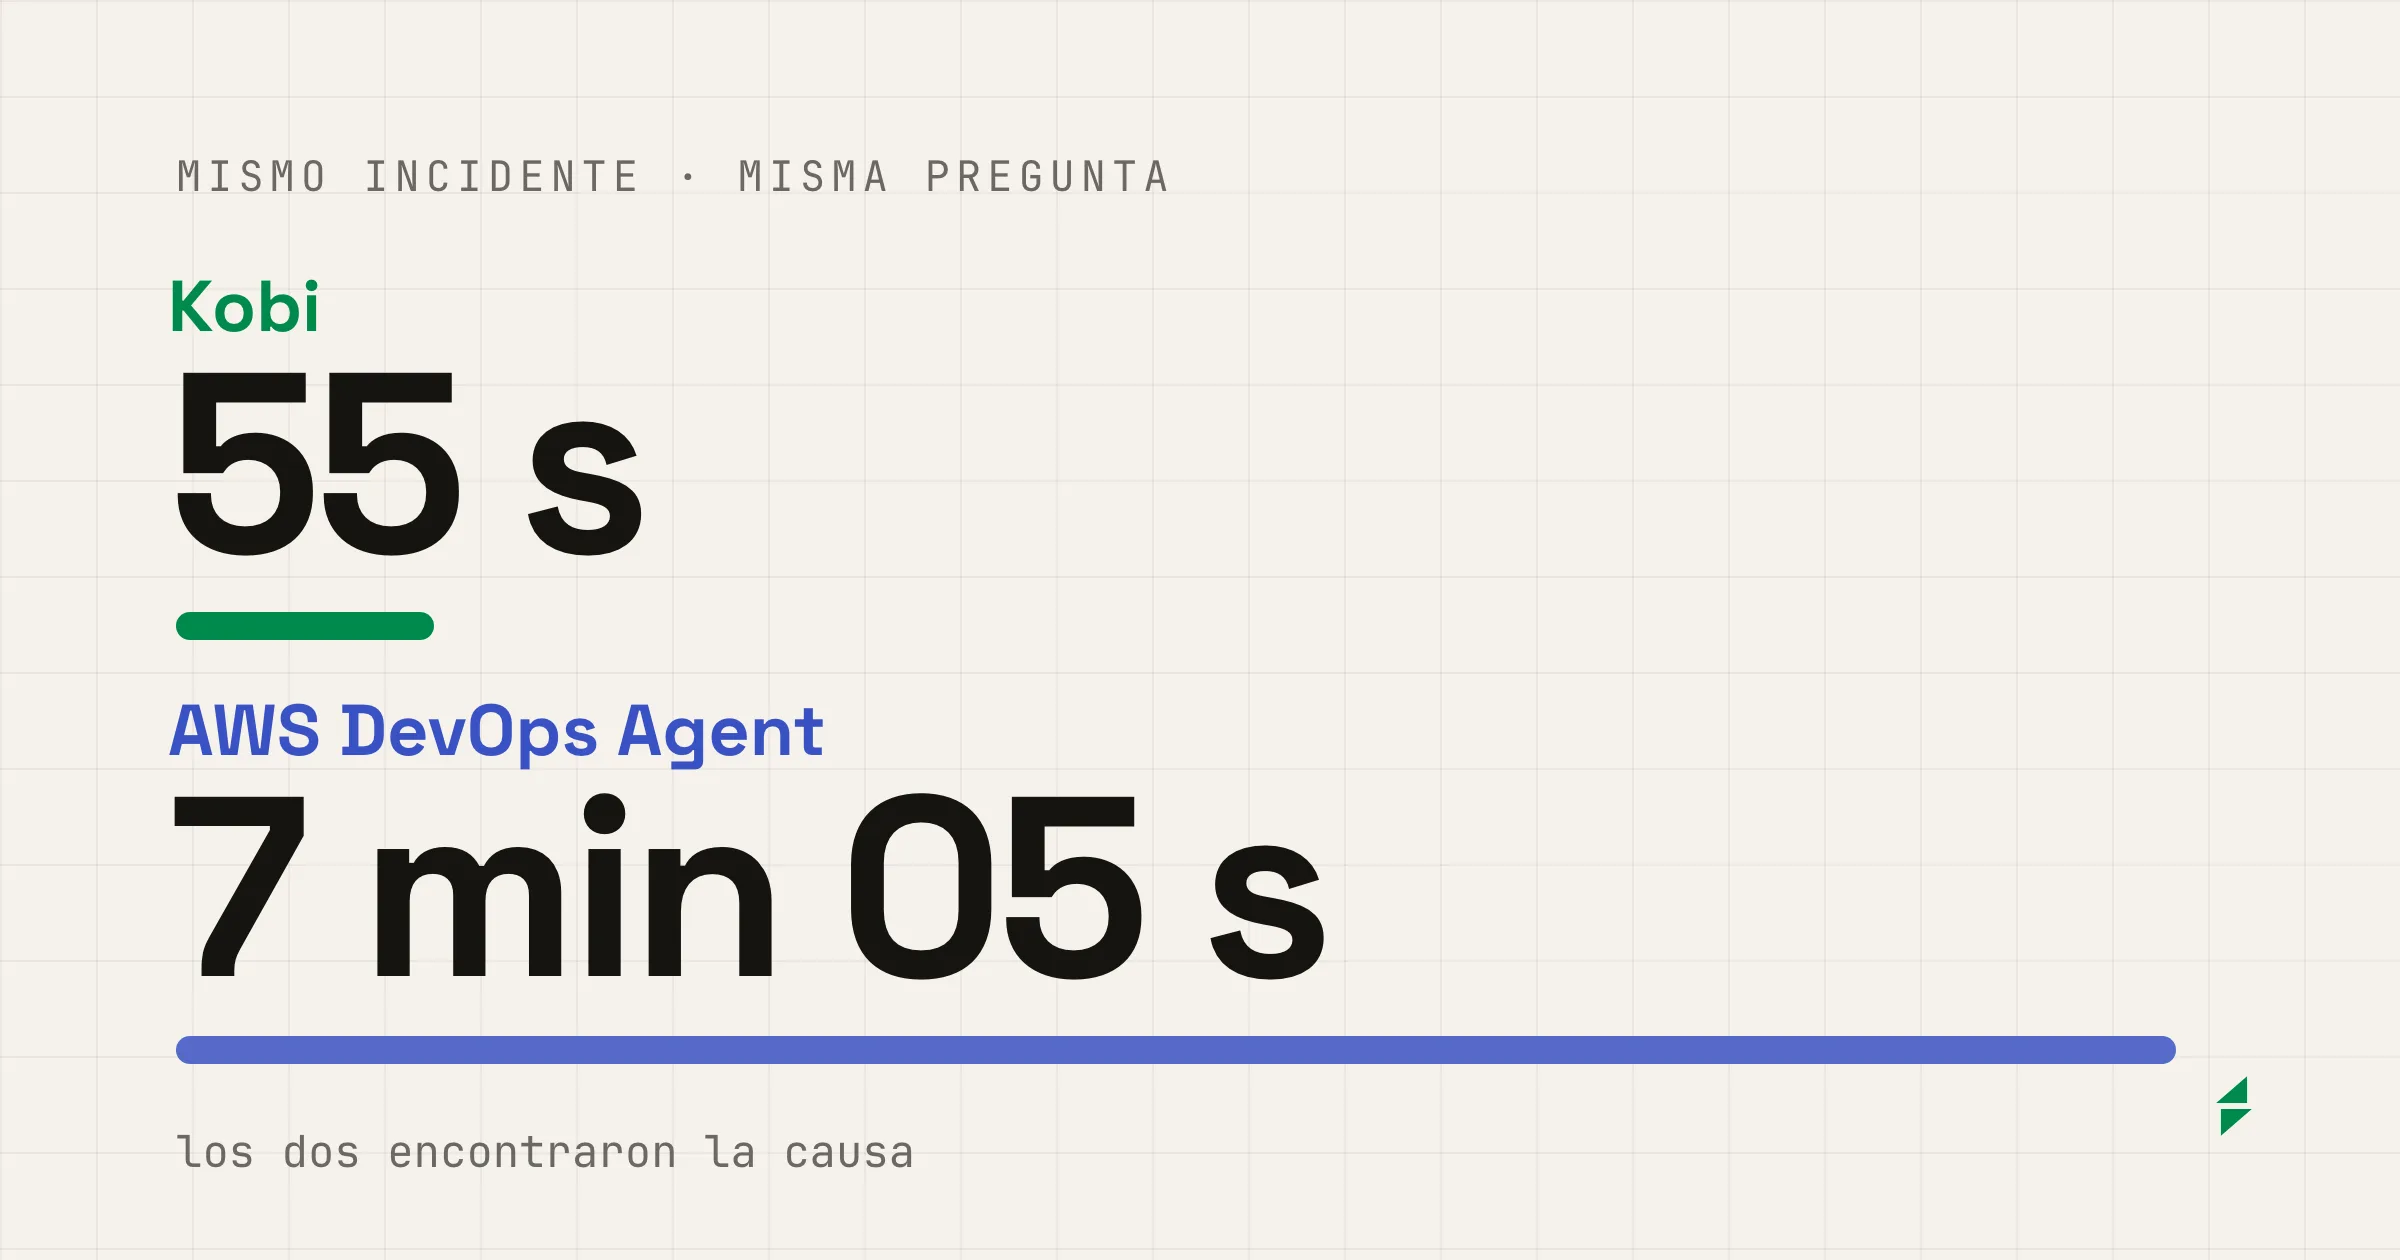
AWS tiene su propio agente para investigar incidentes, DevOps Agent. Quería ver cómo trabaja al lado de Kobi con el mismo incidente, la misma pregunta y los mismos permisos de solo lectura. Así que lo monté en mi laboratorio de AWS: borré una regla de red de la base de datos y les pregunté a los dos qué estaba pasando.
Los dos encontraron la causa y a quién la provocó. La diferencia está en por dónde empieza cada uno. Kobi empieza dentro del clúster, donde está el síntoma, y sale a AWS cuando lo necesita. DevOps Agent empieza en la cuenta y la revisa en paralelo. Ese punto de partida explica casi todo lo demás: el tiempo, el coste y lo que entrega cada uno.
Lo que hay debajo, en cinco líneas:
- Una regla borrada en el security group de la base de datos tumba la tienda. Los dos agentes encuentran la causa, quién y cuándo, solo con permisos de lectura.
- Kobi respondió en 55 segundos. DevOps Agent publicó la causa raíz a los 7 min 05 s, aunque tenía la prueba a los 2 min 15 s.
- Kobi costó menos de 0,50 USD y DevOps Agent, unos 3,50 USD estimados.
- DevOps Agent entregó el informe más completo, y también cometió el error más serio de la prueba.
- Es una sola ejecución en el incidente más sencillo del laboratorio, y al final cuento cómo leerla.
El incidente
El laboratorio es una tienda en EKS, en us-east-2: la web, catalog-api y orders-api, con un PostgreSQL en RDS fuera del clúster. Alguien borra la regla del security group de la base que dejaba entrar a los pods. La base sigue disponible, pero las conexiones expiran, la readiness de los dos backends falla y sus pods salen de rotación.
- Cambio
RevokeSecurityGroupIngresssobre el security group de la RDSkubeshop-lab-pg- Regla borrada
- TCP 5432 desde
10.42.64.0/18, «pods and nodes (private subnets)» - Quién
user/kubeshop-lab-operator, con aws-cli- Cuándo
- 22:16:05, hora de Madrid (21:16:05 UTC)
- Efecto
catalog-apiyorders-apicon 0 de 2 réplicas listas desde las 22:16:10. La tienda devuelve errores 5xx.- Reparación
- La regla vuelve a las 22:38:21 y los cuatro pods están Ready a las 22:38:26.
- Pregunta
- «La tienda está devolviendo errores desde hace unos minutos, ¿qué está pasando?»
Lo que respondió cada uno
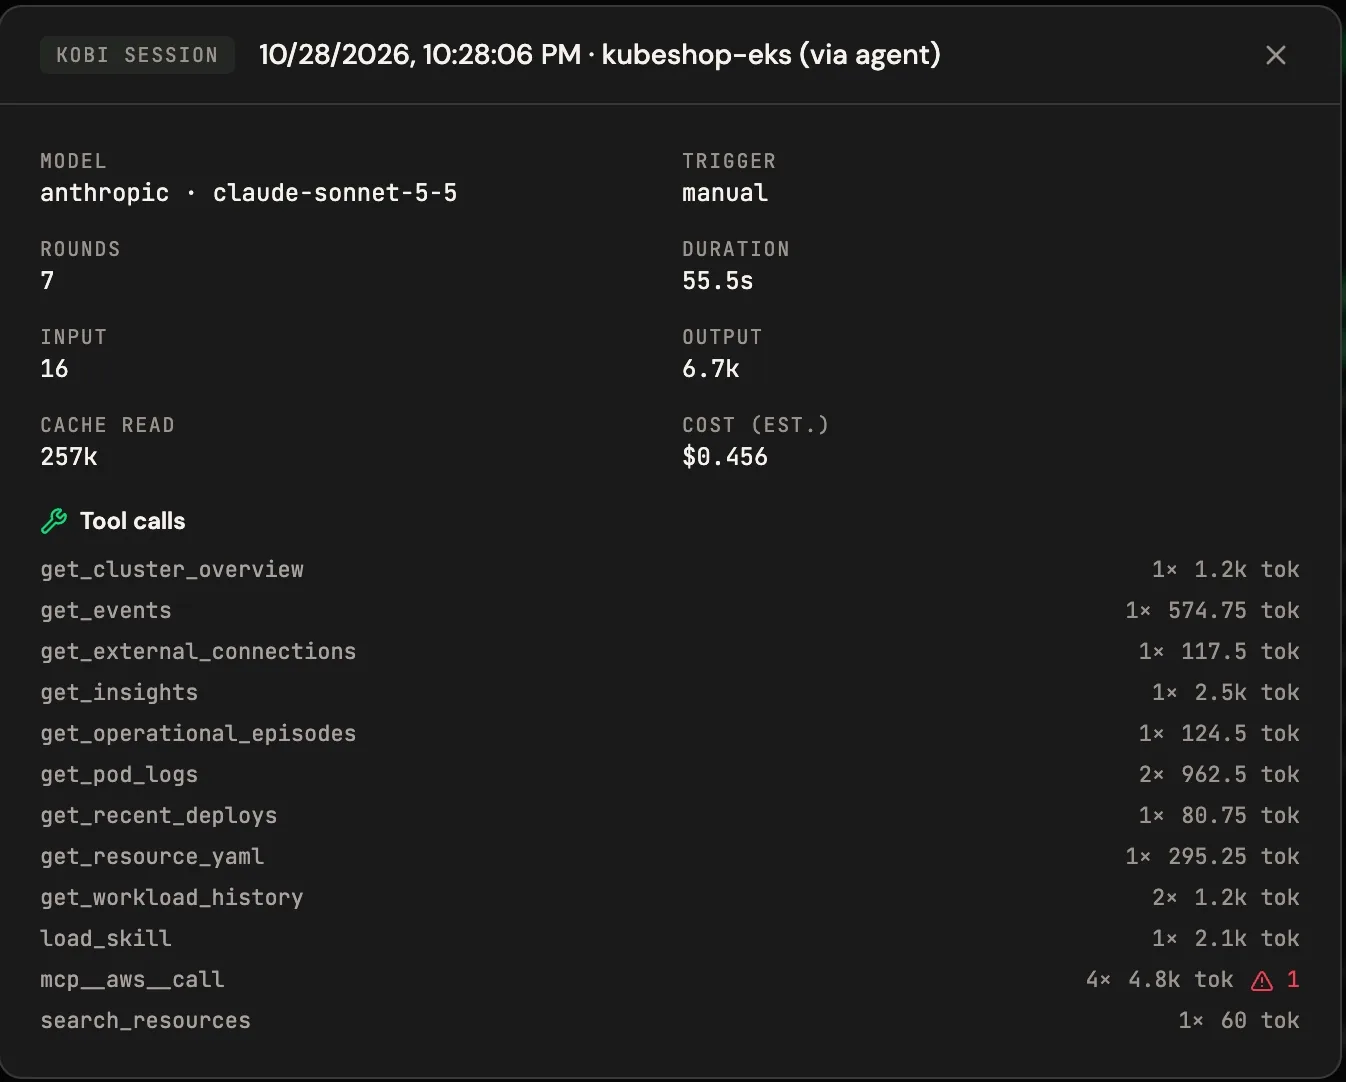
Kobi
KubeBolt · Haiku 5.5, que pasa a Sonnet 5.5
- Pregunta
- 22:27:11, a los 11 min 06 s del corte
- Lecturas
- 12 del clúster y 4 de AWS (una denegada, Route 53)
- Mensajes tuyos
- 1
- Coste
- 0,456 USD según el panel · ~0,20 por modelo
AWS DevOps Agent
Agent Space en us-east-1, con el rol limitado a us-east-2
- Pregunta
- 22:18:36, a los 2 min 31 s del corte
- Lecturas
- Unas 20 llamadas a AWS, Route 53 denegado y 12 accesos a Kubernetes
- Mensajes tuyos
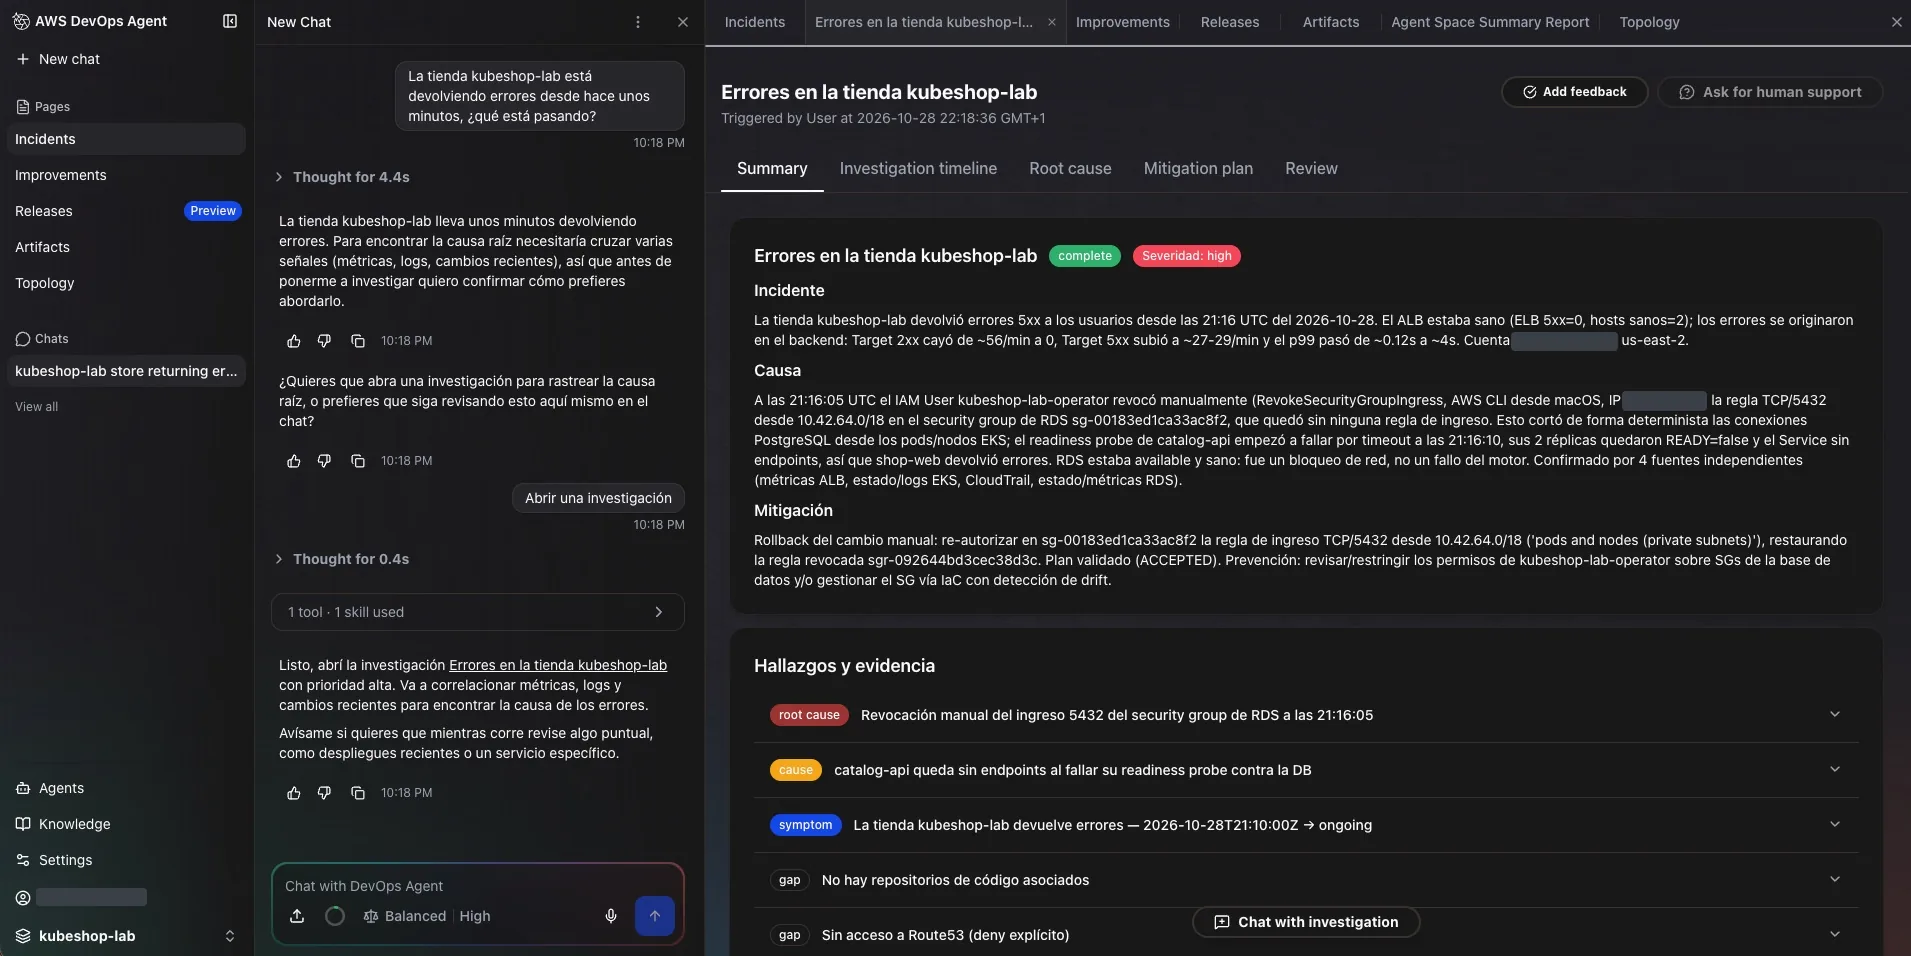
- 2: la pregunta y «Abrir una investigación»
- Coste
- ~3,53 USD estimados
Kobi respondió casi ocho veces más rápido y por una fracción del coste, porque empezó dentro del clúster, donde estaba el problema. DevOps Agent tardó más, pero su registro del incidente es más completo: el impacto medido con las métricas del balanceador, cuatro fuentes cruzadas y un plan de mitigación con el comando exacto, que valida él mismo.
Minuto a minuto
- 1 Abres la investigación desde el chat, después de que el agente preguntara si abrirla o seguir en el chat.
- 2 Tiene la prueba: el
RevokeSecurityGroupIngressen CloudTrail y las reglas del security group. Han pasado 2 min 15 s. - 3 Última llamada a AWS, después de verificar el security group, la RDS y sus eventos.
- 4 Publica la causa raíz, a los 7 min 05 s.
- 5 Le haces la misma pregunta a Kobi.
- 6 Kobi responde con la causa, quién, cuándo y el arreglo.
A escala
Tiempo
DevOps Agent tenía la prueba a los 2 min 15 s. El resto del tiempo lo dedicó a confirmarla con otras fuentes y a redactar el informe.
Coste
El panel cobra las 7 rondas a precio de Sonnet 5.5, pero 5 fueron con Haiku 5.5, mucho más barato. DevOps Agent cobra el tiempo activo del agente: la cifra es una estimación, y su prueba gratuita o los créditos de soporte pueden cubrirla.
Por dónde empieza cada uno
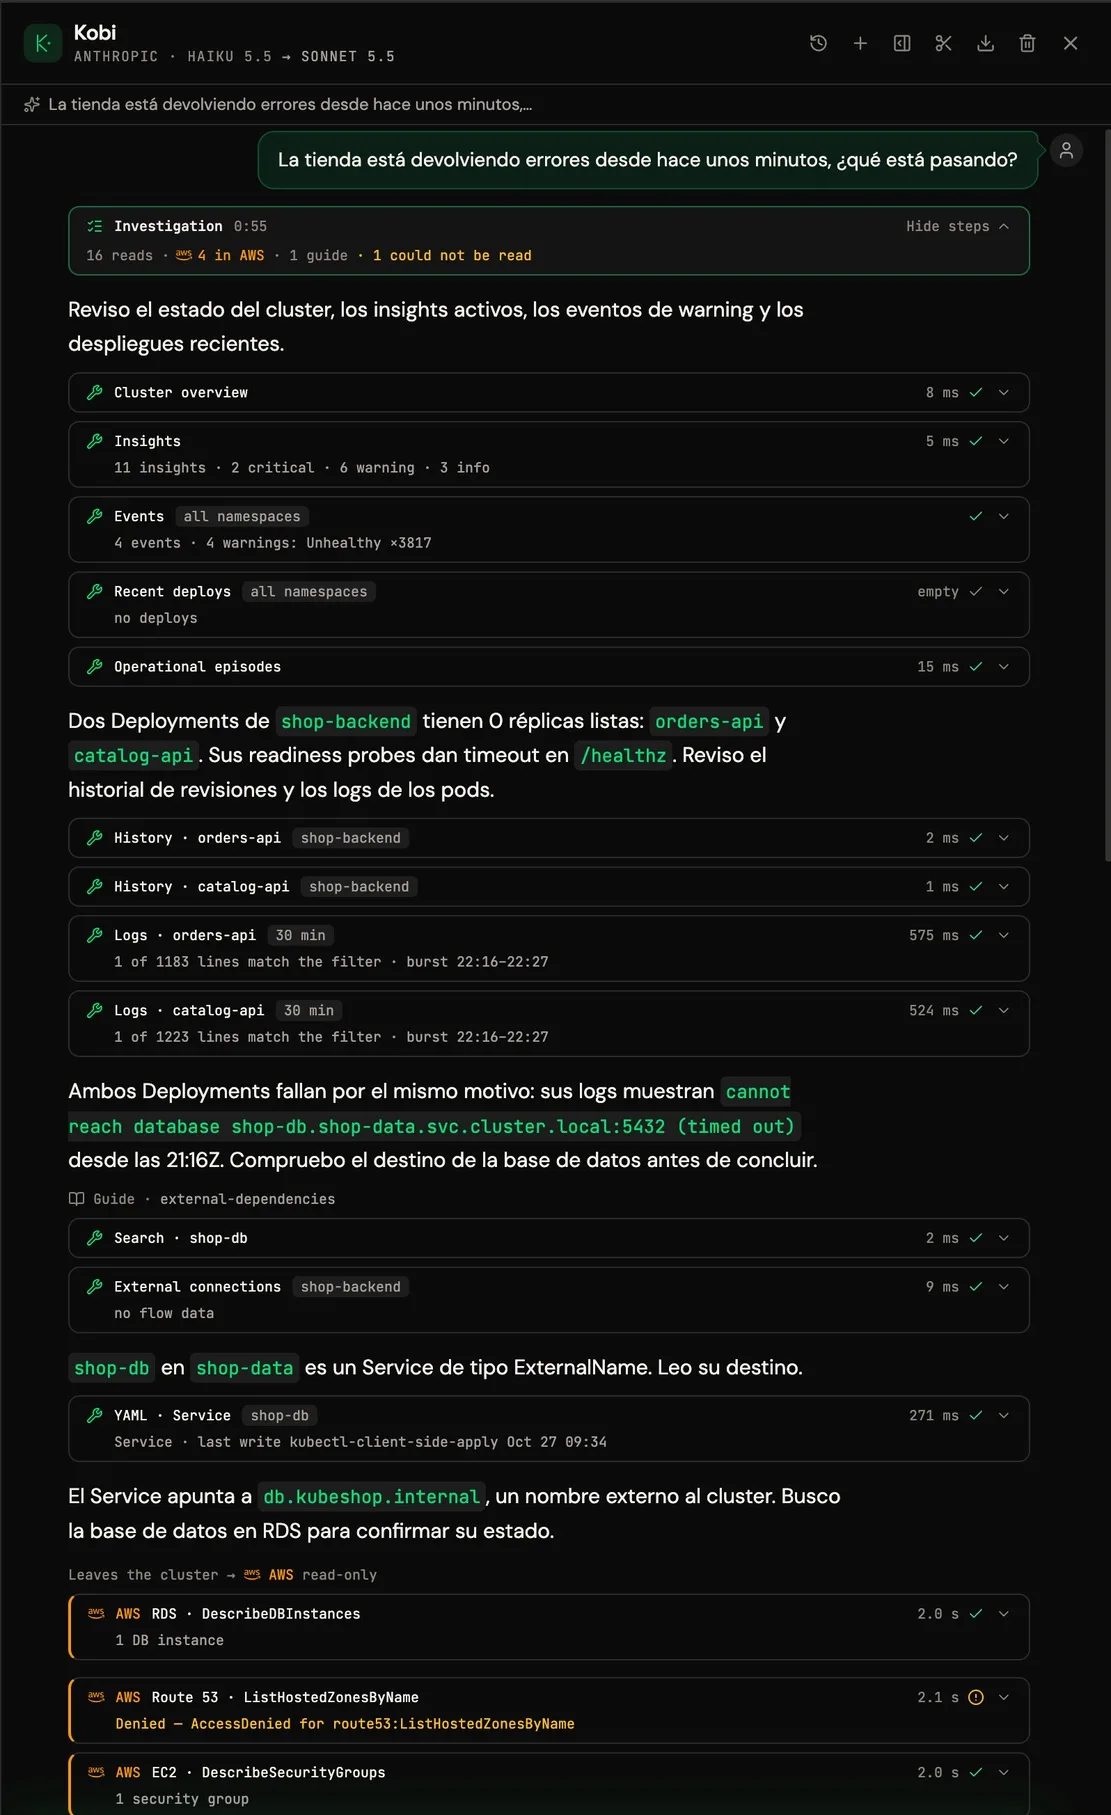
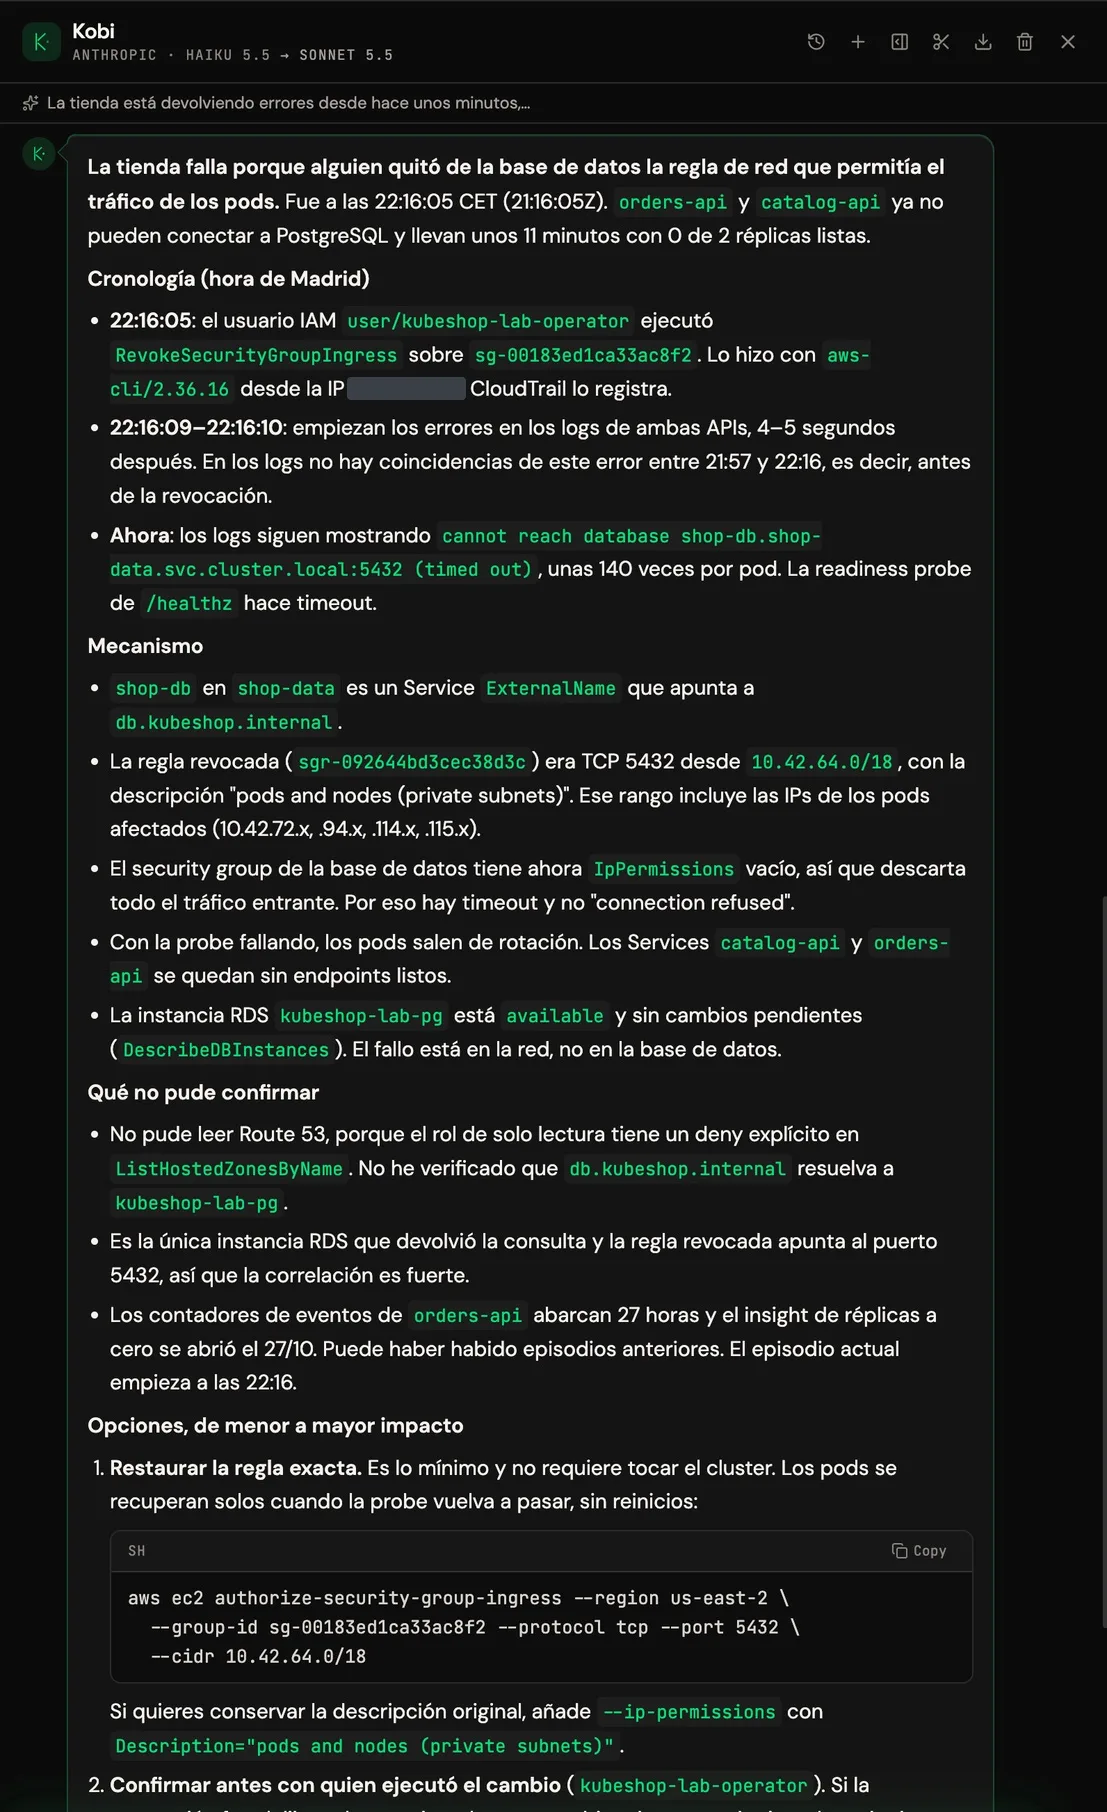
Kobi siguió el síntoma: los pods sin réplicas listas, sus logs con cannot reach database, el Service que apunta fuera del clúster y, desde ahí, la base en AWS. Le bastaron cuatro lecturas en AWS, porque cuando salió del clúster ya sabía qué buscar. DevOps Agent hizo el camino contrario: consultó CloudTrail en paralelo para todos los servicios, encontró el cambio y después bajó al clúster a confirmarlo.
Kobi: del clúster hacia AWS
- Estado del clúster, insights, eventos (
Unhealthy×3817), despliegues y episodios. - Historial y logs de
orders-apiycatalog-api:cannot reach database … (timed out)desde las 22:16. shop-dbes un Service ExternalName que apunta adb.kubeshop.internal.- En AWS: la RDS, Route 53 (denegado por la valla), el security group y CloudTrail.
- Sonnet 5.5 redacta la respuesta, con cronología, mecanismo y opciones.
7 rondas5 en Haiku y 2 en Sonnet16 lecturas4 en AWS
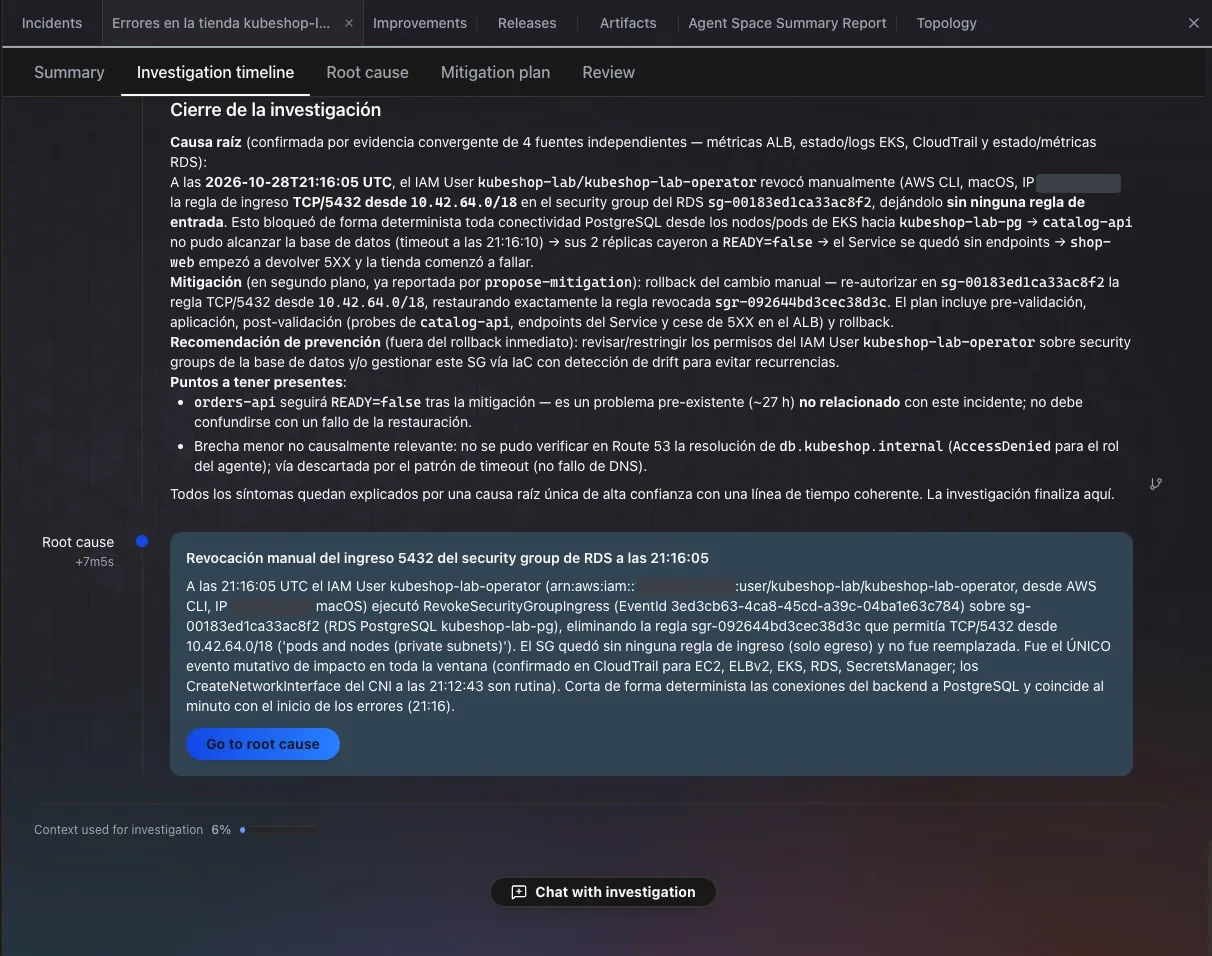
AWS DevOps Agent: de la cuenta hacia el clúster
- En el chat razona 4,4 s y pregunta si abrir una investigación.
- Entre 22:20:30 y 22:21:30 lanza 12 consultas a CloudTrail en paralelo: EC2, ELB, EKS, RDS, Secrets Manager y todos los cambios.
- Entra en Kubernetes a través de EKS y lee el estado de los pods.
- Entre 22:23:06 y 22:23:52 verifica el security group, la RDS, sus eventos y el security group de los nodos.
- Cierra con causa raíz, hallazgos, huecos y un plan de mitigación que valida él mismo.
4 fuentes: ALB, EKS, CloudTrail y RDS6 % del contexto
Criterio por criterio
Los mismos criterios para los dos. No hay nota final: cada fila dice qué hizo cada uno y por qué cuenta como bien, parcial o mal.
| Criterio | Kobi | DevOps Agent |
|---|---|---|
| Causa raíz | Kobi Bien Regla, puerto, CIDR y descripción exactos. | DevOps Agent Bien Lo mismo, con el EventId de CloudTrail. |
| Quién, cuándo y desde dónde | Kobi Bien kubeshop-lab-operator, 22:16:05, la IP y la versión de aws-cli. | DevOps Agent Bien Lo mismo, con el ARN completo del usuario. |
| Servicios afectados | Kobi Bien catalog-api y orders-api, con las IPs de los pods dentro del rango borrado. | DevOps Agent Mal Solo catalog-api. Dice que orders-api es un problema anterior que la mitigación no arreglará. |
| Hora de inicio | Kobi Bien 22:16:05, en hora de Madrid y en UTC. | DevOps Agent Parcial La causa a las 21:16:05 UTC, pero el síntoma empieza a las «21:10». Solo en UTC. |
| Prueba en negativo | Kobi Bien Ningún error de base de datos en los logs entre las 21:57 y las 22:16. | DevOps Agent Bien El único cambio con impacto en EC2, ELB, EKS, RDS y Secrets Manager. Descarta el ruido del CNI. |
| Impacto medido | Kobi Parcial Réplicas listas y unos 140 errores por pod en los logs. | DevOps Agent Bien Métricas del ALB: 2xx de 56/min a 0, 5xx hasta 29/min, p99 de 0,12 s a 4 s. |
| Arreglo | Kobi Parcial Comando con --cidr, sin la descripción de la regla, que menciona aparte. | DevOps Agent Bien Comando exacto con la descripción, comprobación previa y posterior, y vuelta atrás. |
| Origen en CloudFormation | Kobi Bien Stack kubeshop-lab-base, recurso DbSecurityGroup, y avisa del drift. | DevOps Agent Parcial Recomienda gestionar el security group con IaC, sin ver que ya lo está. |
| Prevención | Kobi Parcial Confirmar el cambio con quien lo hizo. | DevOps Agent Bien Restringir los permisos del operador sobre los security groups y detectar el drift. |
| Límites declarados | Kobi Bien Route 53 denegado, y contadores de eventos que abarcan 27 h. | DevOps Agent Bien Route 53 denegado y sin repositorios de código conectados. |
El error de orders-api
Es el fallo más serio de la prueba, y conviene verlo con sus palabras. Al cerrar la investigación, DevOps Agent escribió:
«
orders-apiseguirá READY=false tras la mitigación — es un problema pre-existente (~27 h) no relacionado con este incidente; no debe confundirse con un fallo de la restauración.»
No es cierto. La regla volvió a las 22:38:21 y los dos pods de orders-api estaban Ready a las 22:38:23 y a las 22:38:24, igual que los de catalog-api. El origen probable son los eventos de Kubernetes: los iguales se fusionan, y su contador acumula los cortes de incidentes anteriores del laboratorio. Kobi vio los mismos contadores y los leyó con cuidado: «Puede haber habido episodios anteriores. El episodio actual empieza a las 22:16».
El riesgo es práctico. Siguiendo el informe, un operador no esperaría que orders-api se recuperase al restaurar la regla, y buscaría otra causa que no existe. Revisar más fuentes no lo evitó, porque el error no salió de una fuente que faltara, sino de un dato del clúster mal leído.
Lo que Kobi aprende de DevOps Agent
La tabla tiene tres filas en las que DevOps Agent lo hizo mejor, y las tres son trabajo para Kobi:
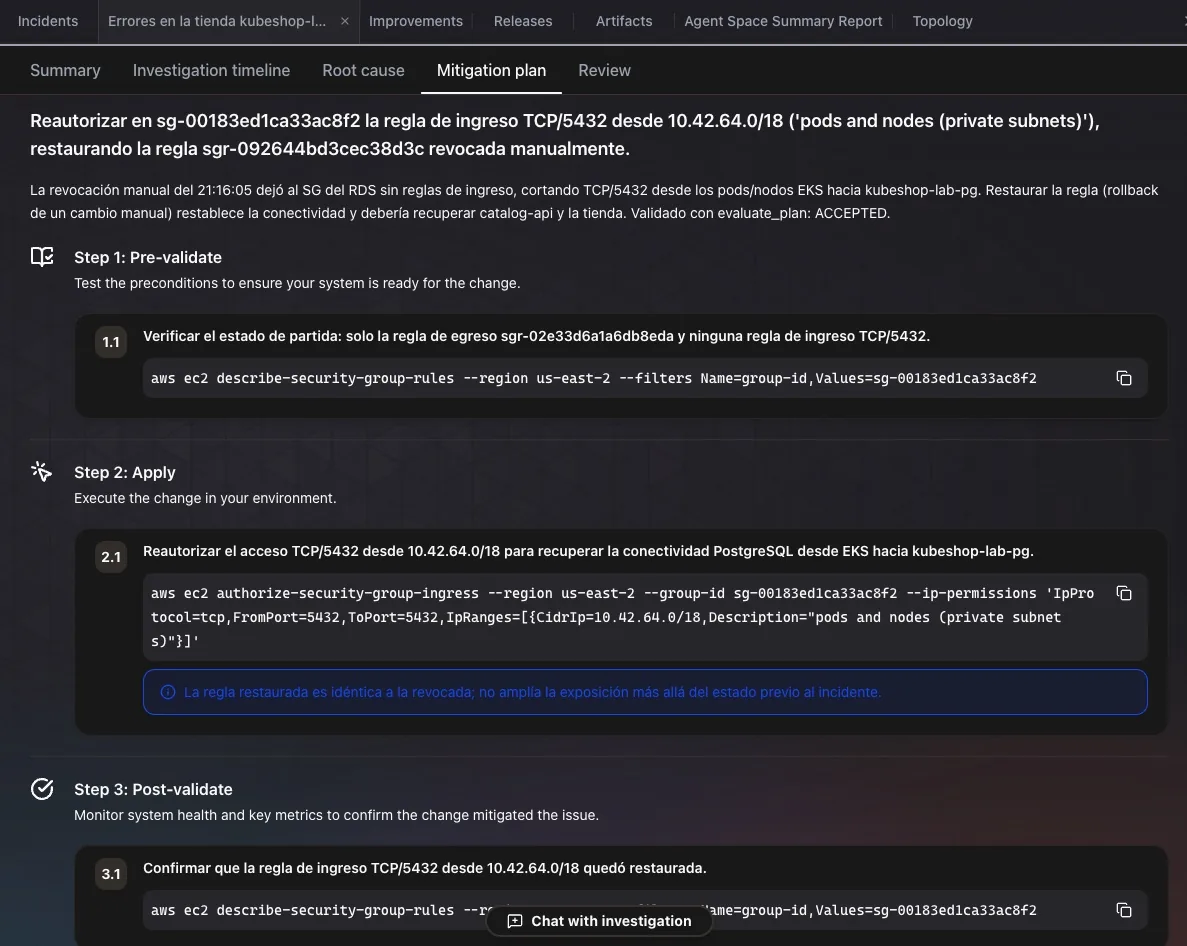
- El comando completo. DevOps Agent restauró la regla con su descripción, y añadió una comprobación antes, otra después y la vuelta atrás. Kobi dio el comando sin la descripción y la mencionó aparte.
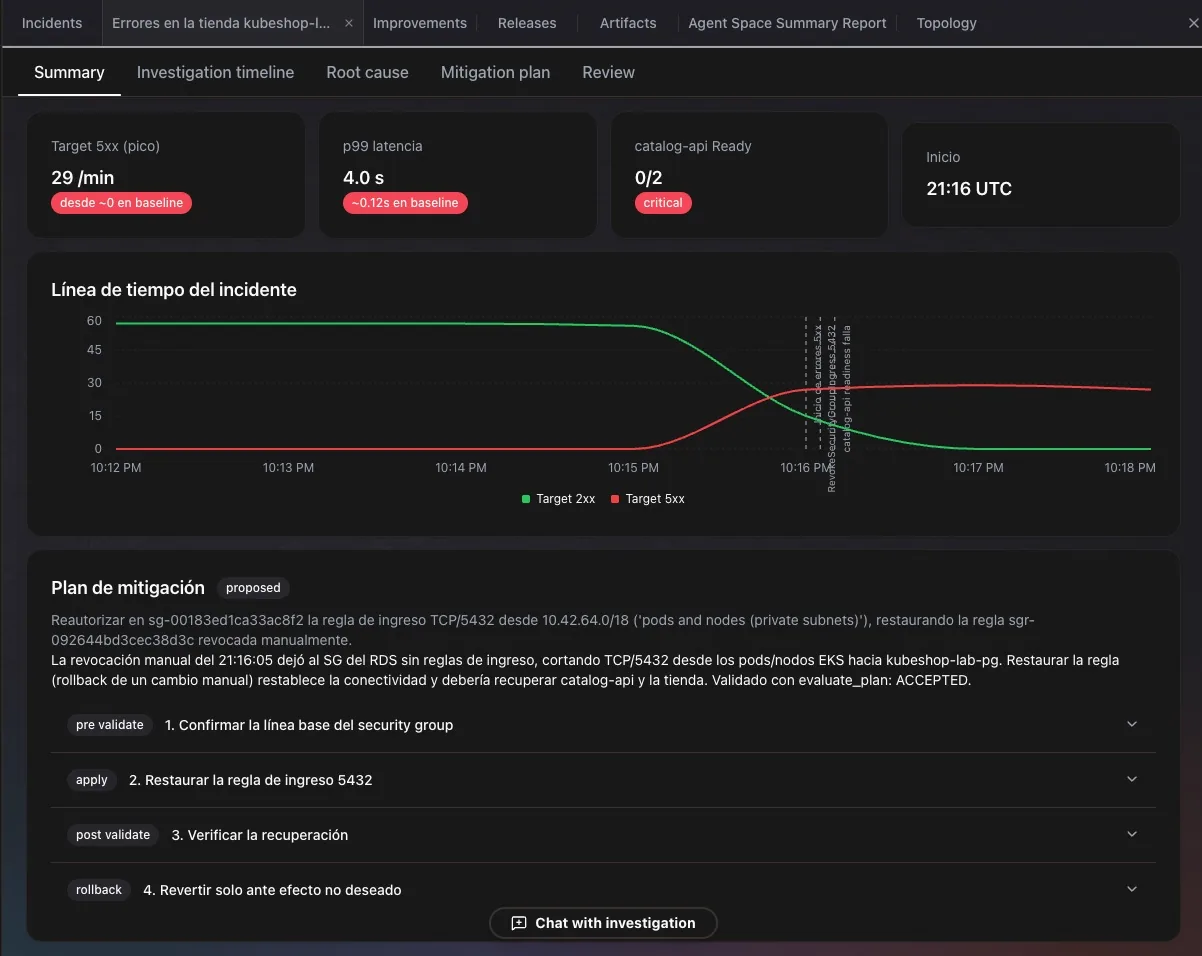
- El impacto medido. DevOps Agent contó el impacto con las métricas del balanceador: las respuestas 2xx bajaron de 56 por minuto a 0 y el p99 pasó de 0,12 s a 4 s. Kobi lo contó con réplicas y líneas de log.
- La prevención. DevOps Agent propuso limitar los permisos del operador sobre los security groups y detectar el drift. Kobi se quedó en confirmar el cambio con quien lo hizo.
Cómo leer la comparación
- Es una sola ejecución por agente, en el incidente más sencillo del laboratorio.
- Las preguntas no fueron a la vez: DevOps Agent la recibió a los 2 min 31 s del corte y Kobi a los 11 min 06 s. El evento de CloudTrail estaba disponible para los dos.
- Los dos tenían la misma valla de solo lectura: solo us-east-2, con IAM y Route 53 limitados al laboratorio. Por eso ninguno pudo leer Route 53.
- DevOps Agent no tenía repositorios ni otras integraciones conectadas. Kobi entra al clúster a través del agente de KubeBolt.
- Los costes son estimaciones: el de DevOps Agent, con su precio público por segundo de agente; el de Kobi, con el panel de KubeBolt y recalculado por modelo.
El conector de AWS, ya disponible
El conector de AWS que usó Kobi en esta prueba salió el 27 de octubre en KubeBolt 2.5, la versión open source, junto al de Azure. Se configura en Administration › AI (Kobi) › Connectors, y el formulario imprime el rol de IAM y su política de confianza, con el external ID ya puesto.
El servidor MCP de AWS no tiene modo de solo lectura: ejecuta código con la identidad de quien llama. Por eso las protecciones están en KubeBolt y en el rol, y se repiten a propósito:
- El modelo no escribe código. Kobi pide servicio, operación y parámetros, y KubeBolt escribe el script que se ejecuta.
- Una tabla, tres filtros. La lista del gateway, la política de sesión y la política del rol salen de la misma tabla, así que no pueden contradecirse.
- Ni secretos ni datos. El rol niega los valores de Secrets Manager y Parameter Store, descifrar con KMS, los objetos de S3, las filas de DynamoDB y el código de una función.
- Un external ID que nadie elige. KubeBolt lo genera para cada organización, y el administrador solo lo copia en la confianza del rol.
Lo que queda
Los dos agentes llegaron a la misma causa por caminos opuestos. Empezar donde está el síntoma da una respuesta en un minuto y por céntimos. Revisar la cuenta entera da un informe más completo, a cambio de tiempo y de coste. Ninguno de los dos caminos protege de leer mal un dato del clúster, y eso es lo que hay que medir en un agente de incidentes: si encuentra la causa, y también si es cierto todo lo que afirma alrededor.