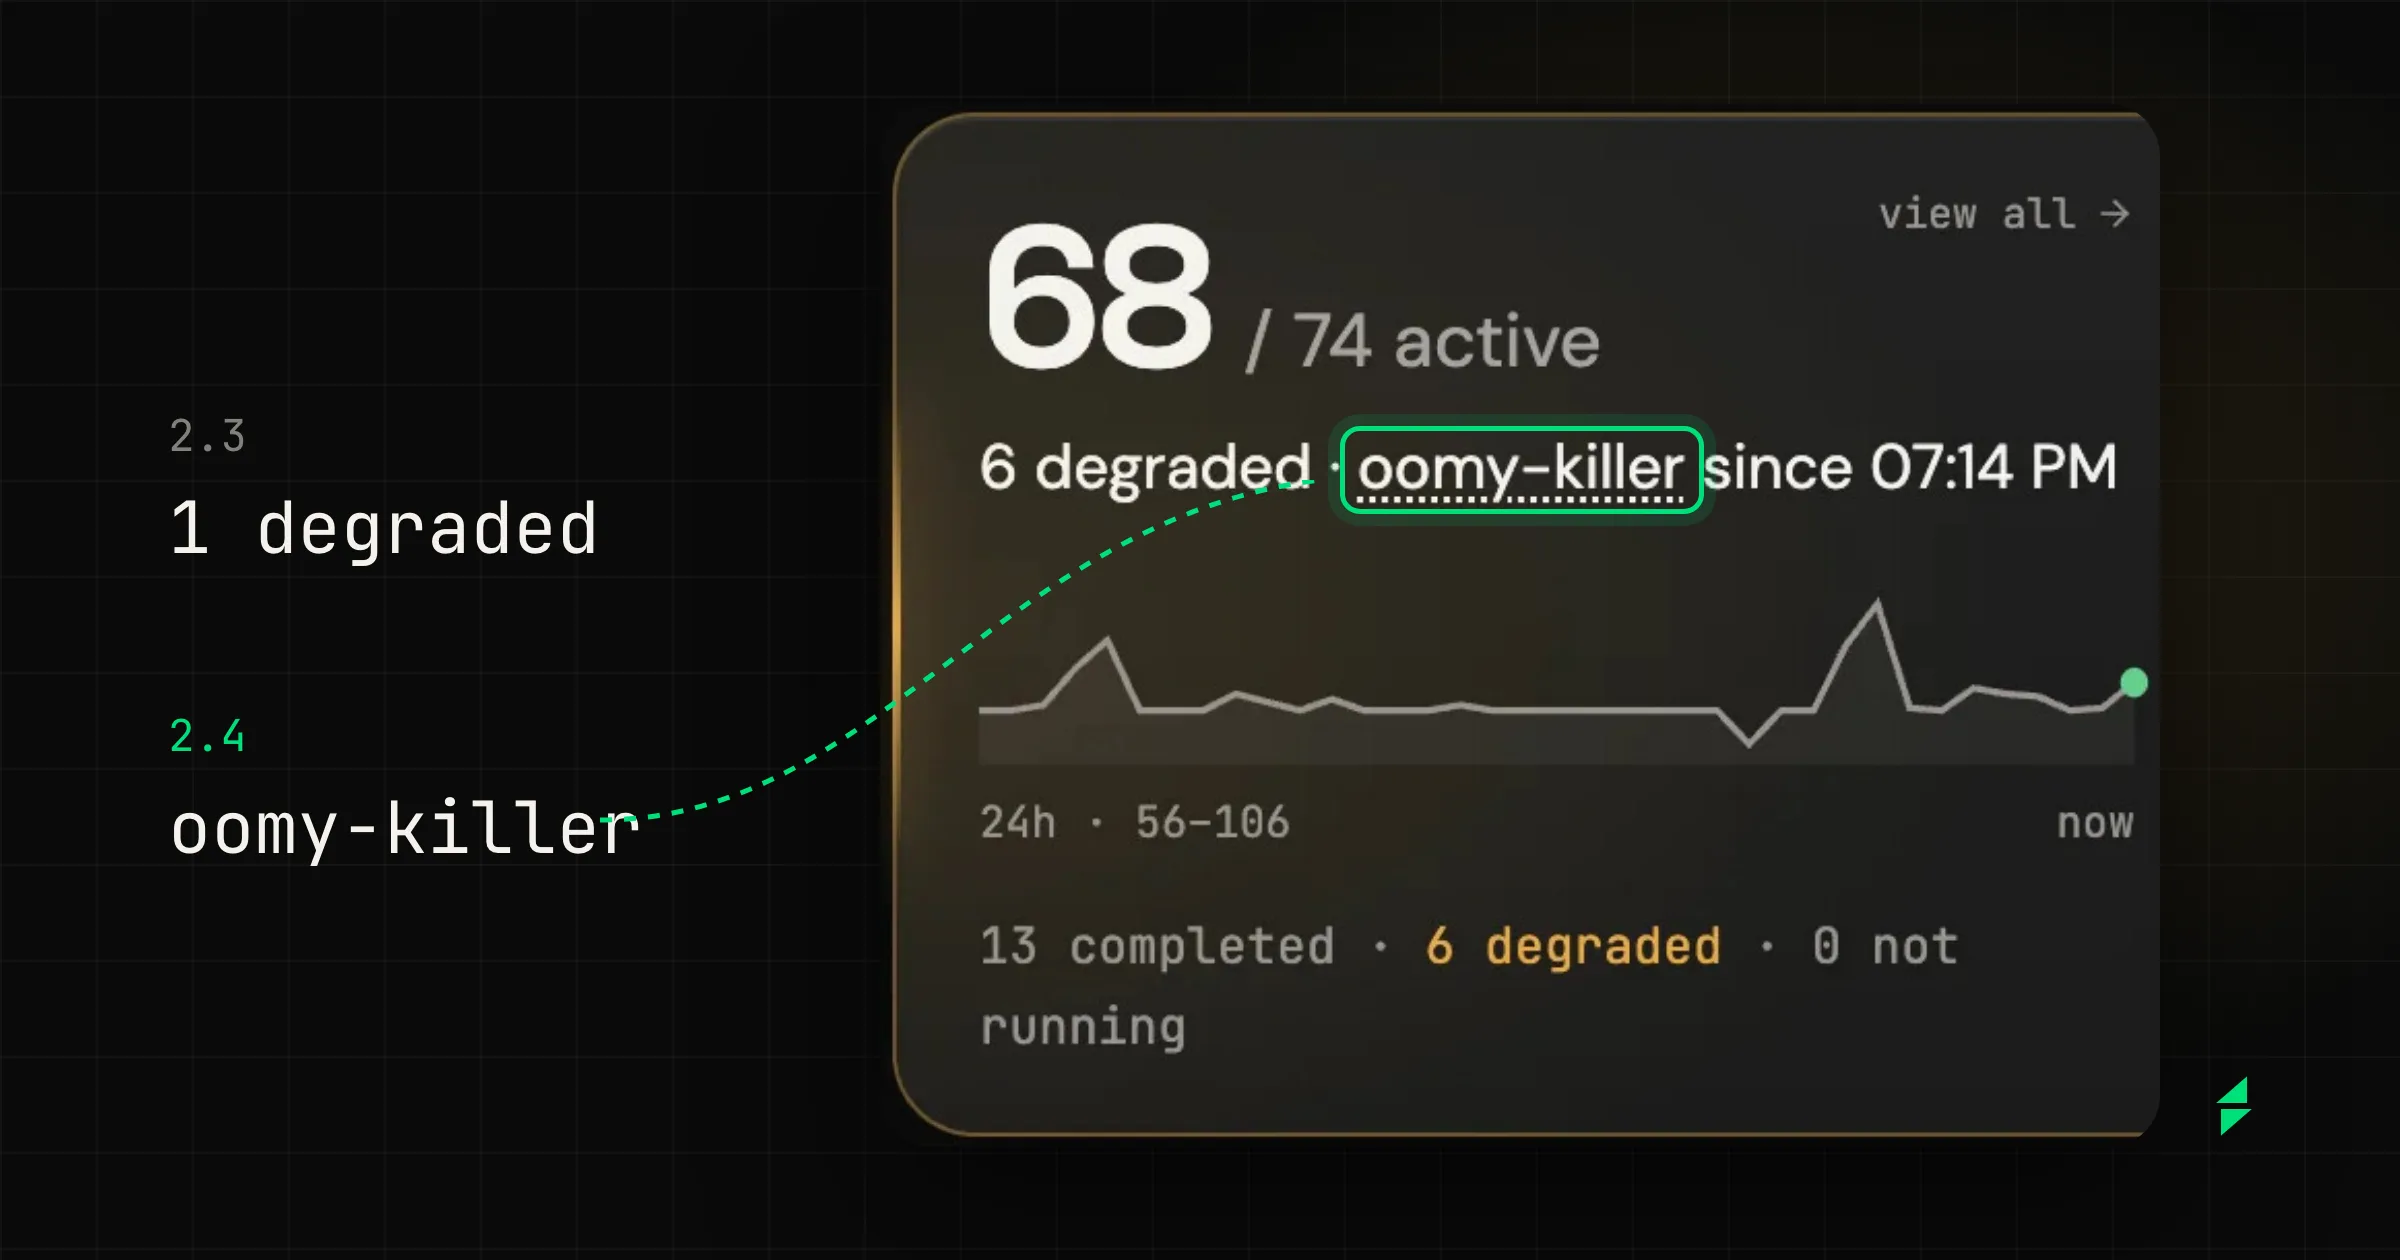
Hasta la 2.3, cuando la tarjeta de Pods de Overview se encendía, decía algo como «1 degraded». Sabías que un pod estaba mal, pero no cuál. Para averiguarlo abrías la lista de pods y lo buscabas.
En la 2.4, esa misma tarjeta dice «6 degraded · oomy-killer since 07:14 PM», y el nombre es un enlace. Es el cambio que más vas a notar: una tarjeta encendida nombra lo que falla, dice desde cuándo y te lleva a donde está el detalle. Y llega a todos los paneles.
Aquí repaso qué dice ahora cada tarjeta y qué pasa con un clúster cuando su agente deja de conectar, y al final resumo el resto. Si solo quieres saber qué trae la 2.4:
- Cada tarjeta encendida nombra el recurso, dice desde cuándo y enlaza a él.
- Un clúster cuyo agente deja de conectar aparece como «No contact», con la hora a la que se perdió el contacto.
- Autopilot cambia de modelo en dos etapas después de medirlos: Claude Haiku 5.5 en el triaje y Sonnet 5.5 en el investigador.
- Puedes valorar cada respuesta de Kobi con 👍 o 👎, y sus errores dicen quién puede resolverlos.
- KubeBolt se vigila a sí mismo: paneles de salud para su API y para Kobi, reglas de alerta y un vigilante externo para cuando la que se cae es la API.
La fila de Overview, antes y ahora
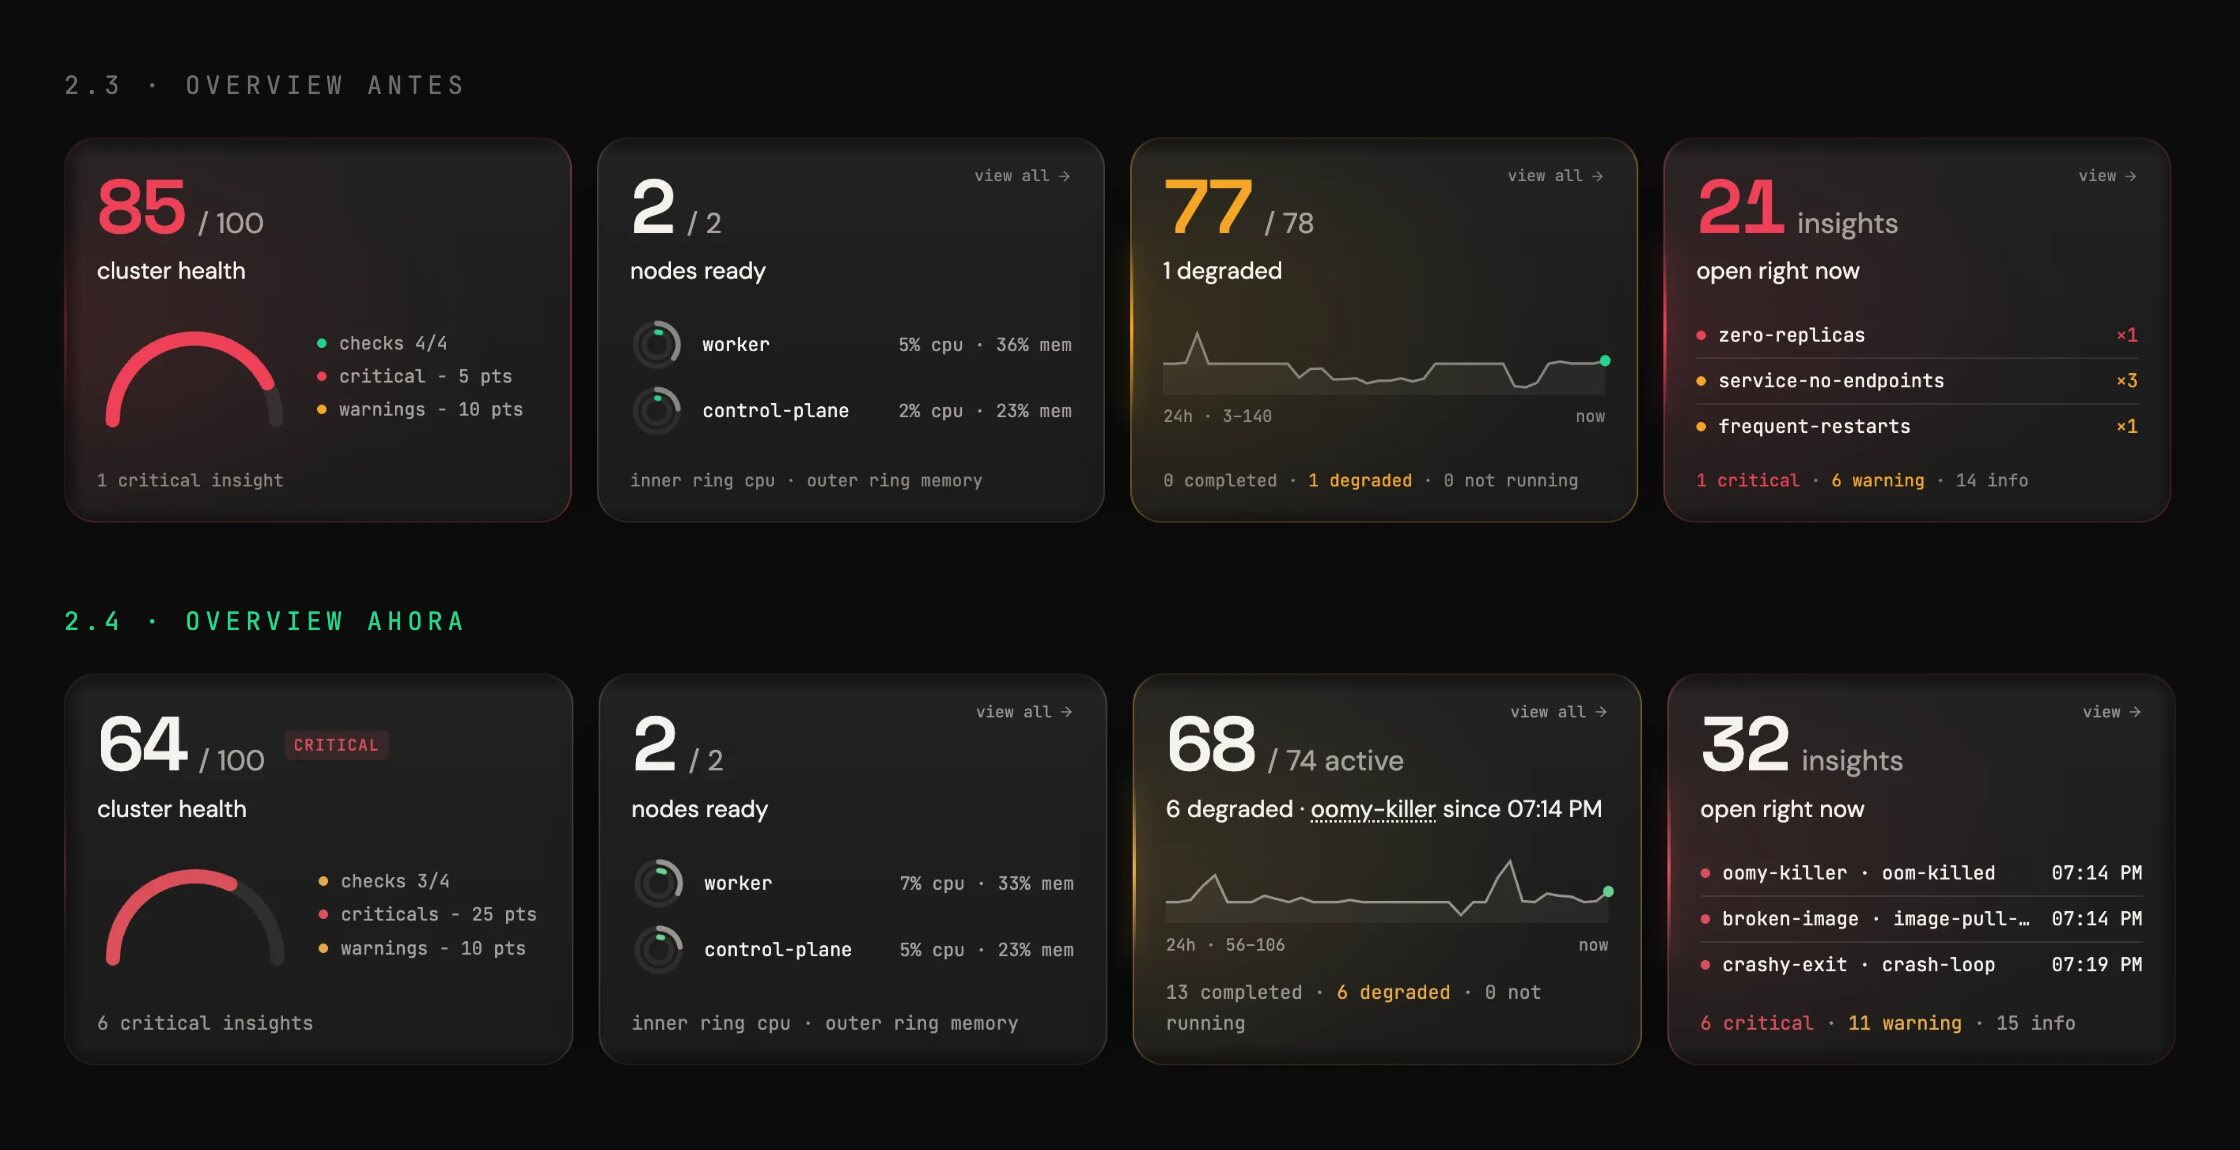
Fíjate en las dos tarjetas de la derecha. En la 2.3, Pods decía «1 degraded» e Insights listaba las reglas que más se repetían, como service-no-endpoints ×3, sin decir a qué recurso afectaban. En la 2.4, Pods nombra lo que falla y la hora a la que empezó, e Insights lista cada caso con su recurso, su regla y su hora: oomy-killer · oom-killed · 07:14 PM.
Cuando hay más casos de los que caben, la tarjeta enseña el primero y el resto aparece al pasar el ratón por encima. El orden es siempre el mismo: por recurso, de más grave a menos grave y, con la misma gravedad, el más reciente primero. Si una regla tiene tres casos o más, el enlace te lleva a Insights con el filtro ya puesto.
Qué nombra cada tarjeta encendida
Una tarjeta se sigue encendiendo cuando su cifra necesita que alguien la mire. Lo que cambia es la frase de debajo:
| Panel y tarjeta | Qué nombra cuando se enciende |
|---|---|
| Overview · Pods | lo que falla y desde cuándo, por ejemplo «3 degraded · oomy-killer since 04:47 PM» |
| Overview · Nodes | el nodo que no está listo y desde cuándo (un nodo acordonado también cuenta) |
| Overview · Insights | cada caso con su recurso, su regla y su hora |
| Overview · Recent Events | los eventos agrupados por objeto, con los rollouts reconocidos como tales |
| Reliability | el workload detrás de cada señal (5xx, puntos calientes, latencia y paquetes descartados), por ejemplo «mostly orders-api · 0.2 req/s» |
| Capacity y Nodes | el nodo de cada tarjeta y desde cuándo no está listo, el nodo que hizo el pico y los workloads que acabaron en OOMKilled |
| Fleet y Home | el peor clúster y el agente que se cayó, con su hora |
| Security | la regla y el workload de cada amenaza en ejecución |
| Cost | el nodo donde se acumula el gasto ocioso |
| Autopilot | solo se enciende «Awaiting approval»; la tarjeta de créditos, cuando se enciende, lleva a Plan & credits |
El nombre es un enlace al recurso o al panel que tiene el detalle. Lo que la tabla no te dice es por qué falla: la tarjeta te da el recurso y la hora, y la causa sigue estando en sus eventos, en sus logs o en lo que se desplegó justo antes. Para eso está Kobi, que tiene su propio botón (la K) en cada fila. Las filas te llevan al recurso, y Kobi solo se abre cuando lo pides.
Si una tarjeta tiene color, la frase de debajo ya te dice a quién mirar y desde cuándo.
Las reglas de color
Al hacer que las tarjetas nombraran cosas revisamos también cuándo se enciende cada una, porque a veces dos se encendían por el mismo hecho y algunos recuentos se quedaban en rojo para siempre. Quedaron cuatro reglas para el tema oscuro:
- Un hecho enciende una sola tarjeta. Cluster health da el veredicto con su nota, su etiqueta (Critical, Warning o Healthy) y el color de su borde, pero ya no se ilumina: se enciende la tarjeta que lista los casos (Insights, Nodes o Pods). En el artículo de la 2.3 te conté que Cluster health se encendía con un insight crítico. Ya no lo hace, porque repetía a Insights.
- La cifra nunca toma el color del estado. El estado lo llevan el brillo, la etiqueta, la barra y la frase, y la cifra se lee igual en cualquier estado.
- La postura no se trata como un incidente. Los CVE abiertos describen cómo está el clúster, y por eso nunca encienden su tarjeta. Las amenazas en ejecución sí.
- La etiqueta de arriba dice la verdad. Puede decir Live, Delayed, Disconnected o Connecting. Hasta la 2.3 decía siempre «Live».
En Reliability los umbrales quedaron así: los 5xx a partir del 1 %, la latencia cuando sube un 25 % y al menos 20 ms, y un paquete L4 descartado por minuto.
Todos los paneles usan además el mismo selector de rango, y en la pestaña Monitor de un recurso un único rango se aplica a todas sus gráficas. En Cloud, un periodo más largo que el que guarda tu plan sigue en la lista con un candado y el aviso «Your plan keeps N days of history».
Un clúster sin agente
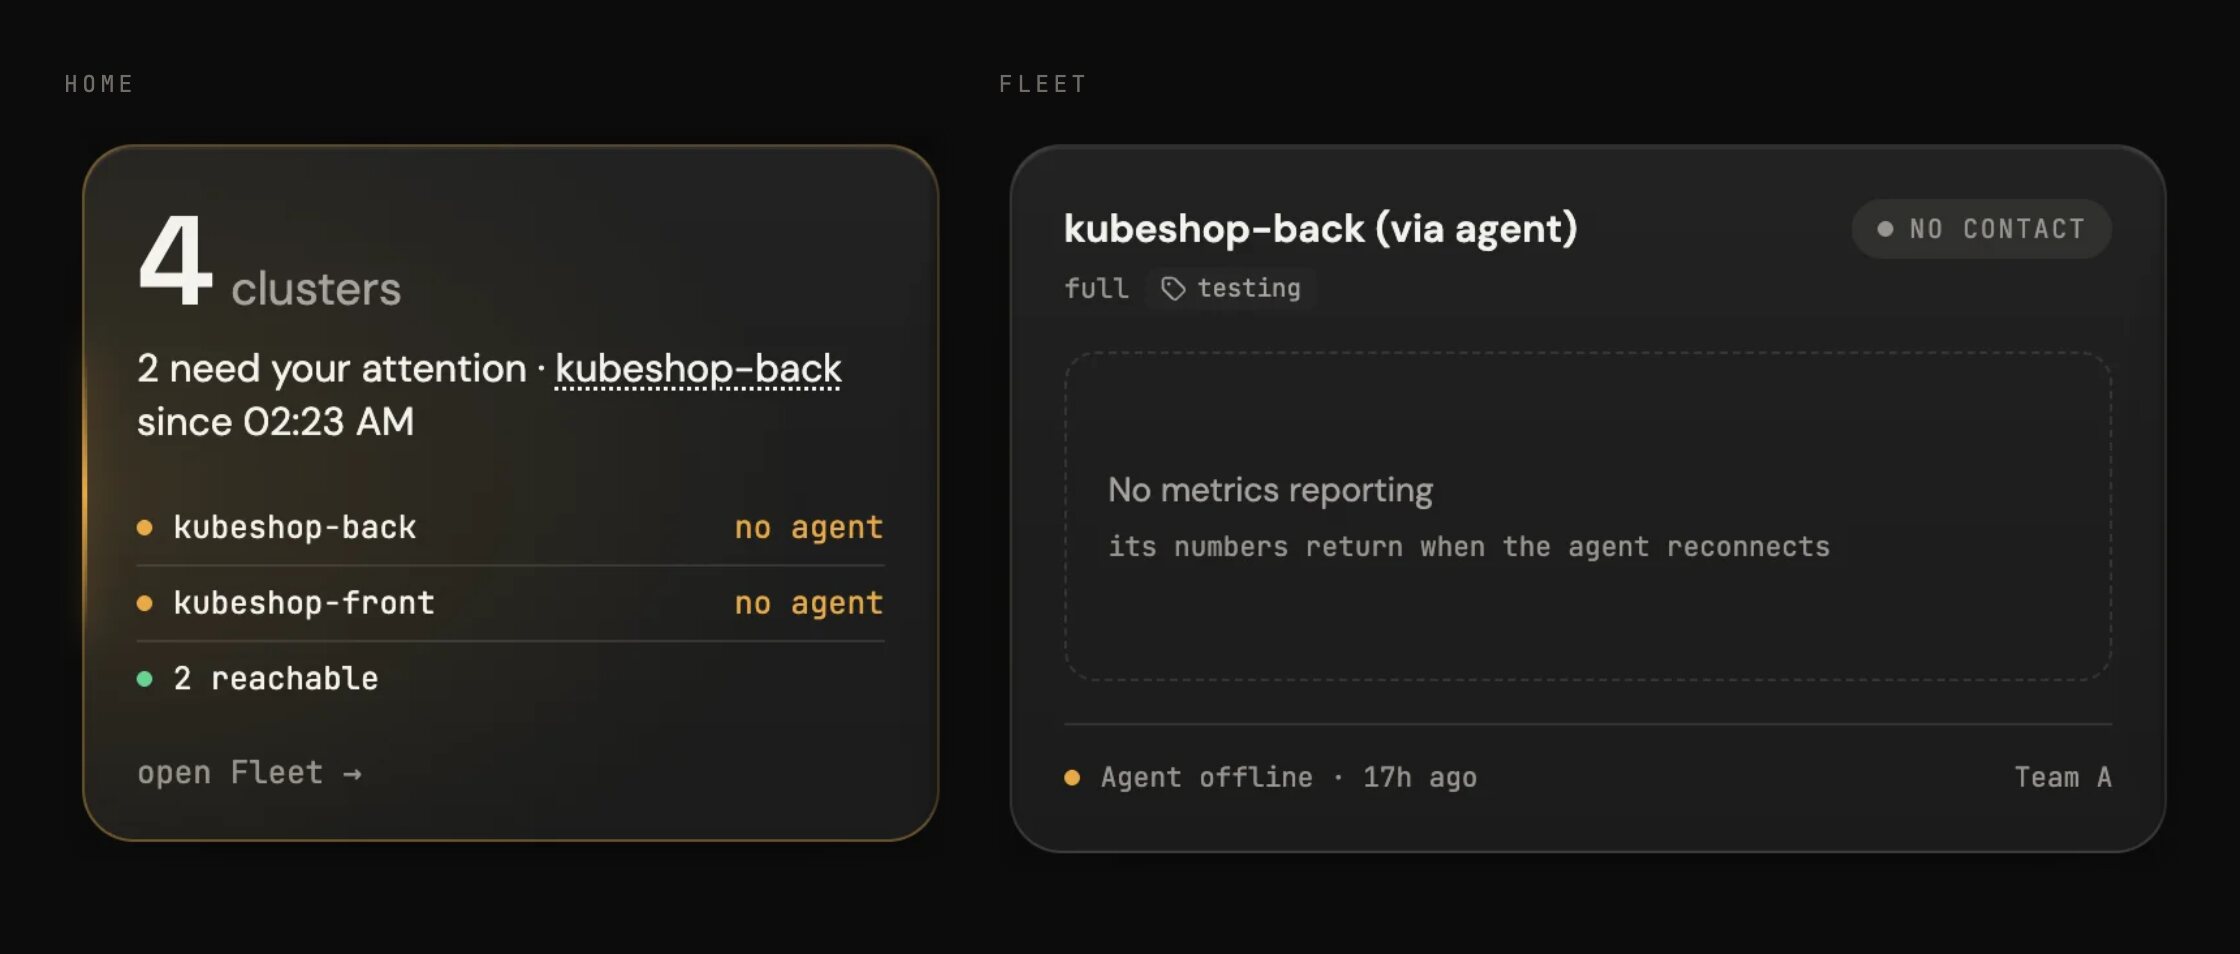
Hasta la 2.3, cuando el agente de un clúster dejaba de conectar, KubeBolt seguía enseñando lo último que había recibido como si fuera actual: el nodo «1/1 ready», los pods en Running, cero eventos, la etiqueta «Live» y la salud a 100. Kobi leía esos mismos datos y respondía con ellos. Eran los datos del momento en que el agente se fue, y nada en la pantalla lo decía.
En la 2.4, mientras ningún agente de tu organización esté conectado a ese clúster:
- Las páginas del clúster muestran el aviso «No contact with this cluster since» con la hora y cuánto tiempo hace.
- La etiqueta de arriba dice «Disconnected», y la tarjeta de salud pierde la nota y muestra la etiqueta gris «No contact».
- Fleet y Home le dan el veredicto
NO CONTACTy lo cuentan entre los clústeres que necesitan atención. - Kobi marca la vista general del clúster como el último estado conocido. KubeBolt no puede saber si cayó el agente, su nodo o la red, y lo dice.
Cuando el agente vuelve, todo se recupera solo. La pérdida se cuenta por organización, así que el agente de otra organización en el mismo clúster no oculta que el tuyo se fue.
KubeBolt también se vigila a sí mismo
Hasta la 2.3 vigilábamos tus clústeres y no el nuestro. Una ruta lenta de la API, una tarea en segundo plano atrasada, un VictoriaMetrics que rechazaba escrituras o un Kobi que fallaba solo salían a la luz si alguien se quejaba. En la 2.4, KubeBolt mide su propia API, su ingesta y a Kobi, y avisa a quien lo opera. Si instalas KubeBolt tú mismo, quien lo opera eres tú, y esta parte es para ti.
| Dónde | Qué enseña |
|---|---|
| Administration › System › Health | Réplicas y memoria de la API, la proporción de 5xx y el HTTP por grupo de rutas (el 503 de un clúster caído se cuenta aparte de un fallo de la API). Las tareas en segundo plano, las atrasadas primero. VictoriaMetrics midiéndose a sí mismo y las llamadas que le hace la API. Y los agentes: canales vivos por réplica y las peticiones a Kubernetes que cruzaron el túnel, por resultado (ok, timeout, agent_closed…) y con su p50 y p95 |
| Administration › AI › Health | Los turnos de Kobi y cómo terminaron, los errores del proveedor y lo que rescató el modelo de respaldo, las negativas y las respuestas cortadas, las herramientas que fallaron o volvieron vacías, la latencia, el coste, los tokens y la caché del prompt |
Las dos pestañas leen series que la API envía a VictoriaMetrics cada 30 segundos. Cada serie lleva instance, run_id y job, así que un reinicio nunca se cuela como un contador que vuelve a cero. No es un detalle menor: en la pantalla de actividad de la ingesta, leer los contadores sin eso escondió 10.335 peticiones limitadas después de un reinicio.
Mirar un panel no basta para enterarte a las tres de la mañana, así que la 2.4 trae dos piezas más:
- Reglas de alerta sobre la API y sobre Kobi, probadas con
promtool. El chart las crea comoPrometheusRuleconmetrics.alertRules.enabled. - Un vigilante externo. Ninguna alerta que corre dentro de la API puede avisarte de que la API se cayó. Con
KUBEBOLT_EXTERNAL_METRICS_URL, la API envía una copia de sus series de salud a un Prometheus de fuera, como Grafana Cloud, con un dashboard que se importa tal cual. Solo cruzan las series que no llevan organización ni clúster.
En KubeBolt Cloud usamos lo mismo, ampliado a todas las organizaciones: una vista de operaciones con cinco pestañas (la API, la ingesta, VictoriaMetrics y Kobi, más un resumen) y 25 reglas de alerta, 10 sobre la plataforma y 15 sobre Kobi. Una de las cosas que más cuidamos es que un problema dé un solo aviso: cuando falla el envío de métricas, se retienen las reglas que dependen de él, y un corte de cuatro minutos de VictoriaMetrics pasó de 15 alertas a una. Así nos enteramos de que Kobi falla en tu organización, o de que crecen sus 👎, sin que tengas que escribirnos.
Lo demás que trae la 2.4
Autopilot cambia de modelo en dos etapas. Antes de cambiar el modelo por defecto de una etapa, lo comparamos con el que ya usaba sobre los mismos casos grabados del laboratorio y con el mismo prompt. El triaje, que clasifica el incidente, pasa a Claude Haiku 5.5 sin razonamiento: en 39 casos, ejecutados cinco veces cada uno, acertó la regla y la gravedad igual que Haiku 4.5, con unas 14 veces menos coste y la mitad de tiempo de respuesta. Con el razonamiento alto le iba peor: 21 de las 195 ejecuciones no terminaron dentro de sus cinco turnos o sus 180 segundos. El investigador pasa a Sonnet 5.5, que propuso el remedio correcto en 50 de 50 casos, frente a 45 con Sonnet 5, y cuesta un 22 % menos por investigación.
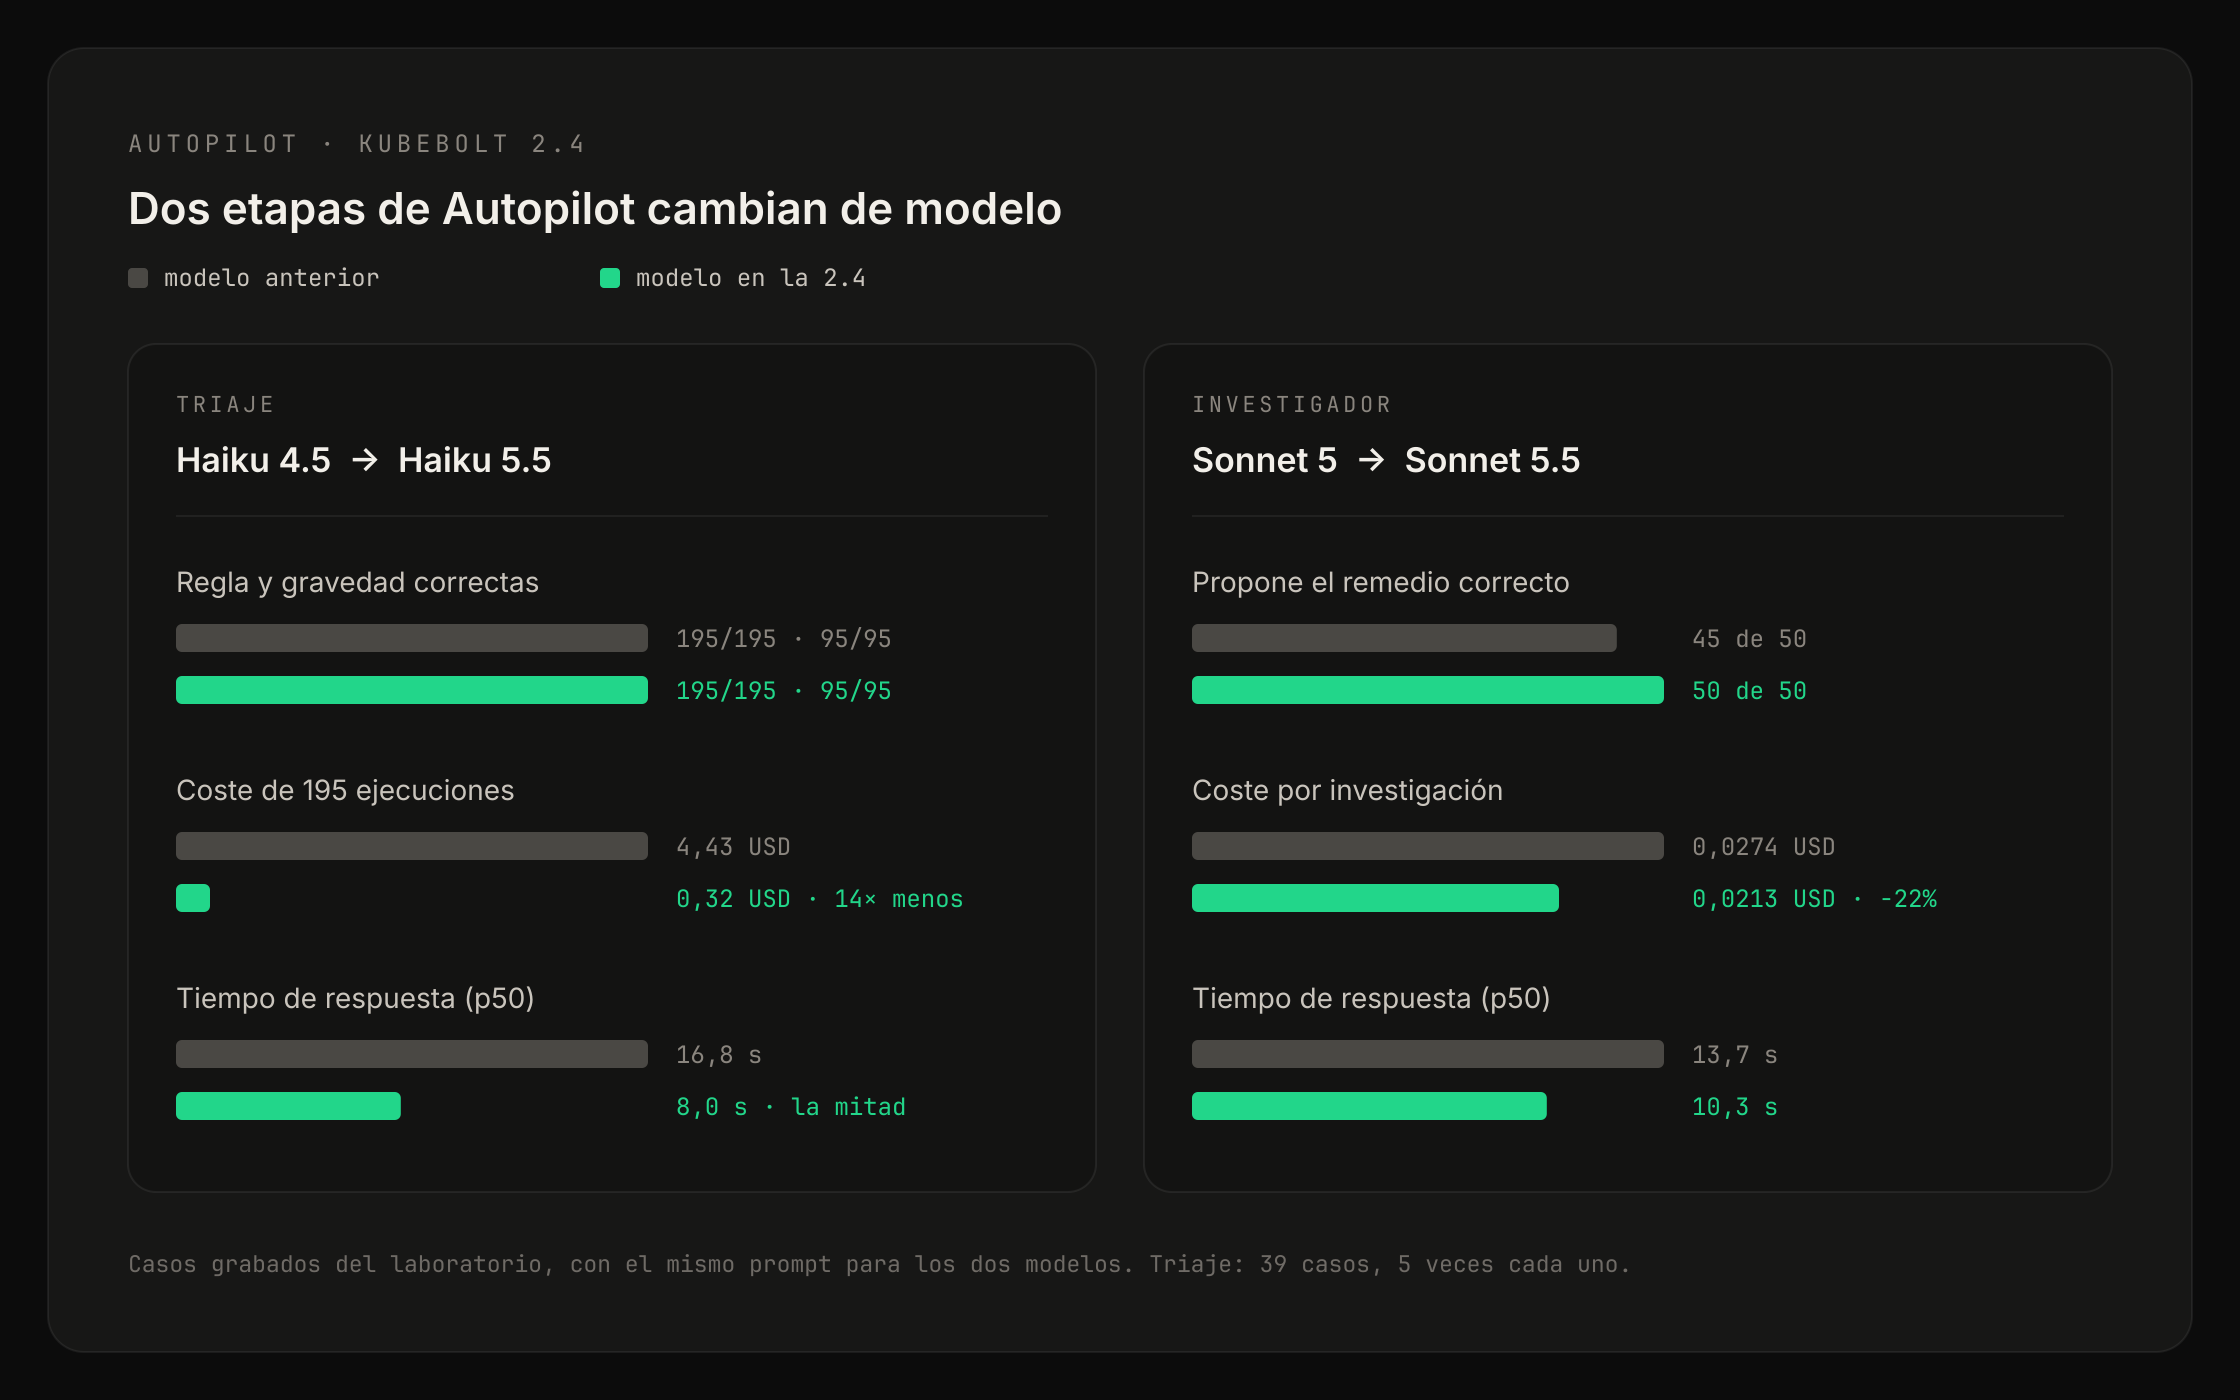
Si ya habías elegido un modelo, se mantiene el tuyo: los nuevos se aplican al instalar o con «Reset to defaults».
Kobi. Cada respuesta tiene un 👍 y un 👎. Vale el último voto, y el mismo icono lo retira. Si marcas 👎 puedes indicar el motivo y dejar un comentario, que se guarda con tu conversación, nunca pasa a una métrica y se borra con ella. Los errores ya no enseñan la respuesta del proveedor de IA tal cual: cada tipo tiene una frase fija que dice quién puede resolverlo, sea nuestro soporte, el administrador de tu organización o tú, volviendo a intentarlo. En Kobi también puedes elegir Haiku 5.5 y Sonnet 5.5; su modelo por defecto sigue siendo Sonnet 5.
remote_write. Cuando Prometheus se pone al día después de un corte y supera el límite, KubeBolt le responde 503 con Retry-After y Prometheus lo reintenta, así que lo pendiente ya no se pierde. Te recomendamos añadir retry_on_http_429: true a tu configuración.
Lo que sobrevive a un reinicio de la API, si instalas KubeBolt tú mismo: un clúster borrado ya no vuelve a aparecer, los registros de agentes que quedaron como «conectados» caducan y el clúster que tenías seleccionado se recuerda.
Empieza por aquí
Lo que buscamos con esta versión es que la primera fila de un panel baste para saber por dónde empezar: qué falla, desde cuándo y dónde se mira. Que cuando KubeBolt no puede saber cómo está un clúster, lo diga. Y que si el que falla es KubeBolt, te enteres por una alerta y no por un usuario.
Si usas la versión Open Source, actualiza a la 2.4.0 y el agente a la 1.4.4. Un aviso para la actualización: un clúster ya no desaparece cuando se va su agente, se queda en la lista como «No contact». Si contabas con que desapareciera, bórralo en Clusters. En Cloud ya está todo actualizado.
Abre Overview en tu clúster y mira la primera fila. Si alguna tarjeta tiene color, pulsa el nombre que aparece en ella.
Si todavía no usas KubeBolt, empieza gratis: dos clústeres, sin límite de tiempo.