Cuando abres un clúster en KubeBolt, la lista de pods, el mapa y los insights no le preguntan nada a tu API server. Los leen de una copia del clúster que KubeBolt guarda en memoria y que se mantiene al día sola. Por eso el portal responde al instante, y por eso pasar una hora mirando un clúster apenas le añade carga.
Esa copia tiene un precio: hay que traerla entera al conectar. En un clúster pequeño son unos segundos. Hace unas semanas, un cliente conectó un clúster de desarrollo con 140 namespaces y 5.632 ReplicaSets, y la primera conexión no conseguía terminar. Los arreglos salieron en cuatro versiones, de la 2.6.4 a la 2.7. Aquí cuento cómo funciona la carga y qué cambió. Si solo quieres saber qué trae:
- La carga inicial llega en páginas de 500 objetos, también a través del agente.
- KubeBolt ya no descarga listas enteras cada pocos minutos: la comprobación de la copia cuenta sin descargar, y la historia de Helm se queda en el clúster hasta que una vista la pide.
- Mientras un clúster carga, ves los pasos, lo que ha llegado y cuánto falta.
- El agente 1.4.10 tiene más memoria por defecto, y si una respuesta no le cabe contesta con un error en lugar de reiniciarse.
- Cuando un clúster abre decenas de insights a la vez, te llega un resumen en lugar de un aviso por cada uno.
Por qué KubeBolt carga el clúster al conectar
Hay dos formas de enseñar un clúster en una interfaz. Una es preguntarle al API server cada vez que alguien abre una vista, de modo que cada lista, cada filtro y cada refresco es una petición. La otra es la que usan los propios controladores de Kubernetes: pedir la lista completa una vez y después escuchar solo los cambios. KubeBolt hace lo segundo, con los informers de client-go.
Lo que viaja entre tu clúster y KubeBolt
Del API server a KubeBolt
Del portal a la copia en memoria
- Al conectar, KubeBolt comprueba qué le deja leer su rol y pide la lista completa de cada tipo de recurso permitido.
- Desde ese momento mantiene un watch por tipo, y el API server le envía solo lo que cambia: un pod nuevo, un Deployment escalado, un evento.
- Las listas, el mapa del clúster y los insights, que se evalúan cada 60 segundos, leen de esa copia. Moverte por las listas y el mapa no genera peticiones a tu clúster.
La carga completa se repite solo en tres casos: la primera vez, cuando KubeBolt se reinicia y cuando se pierde la conexión. El resto del tiempo viajan los cambios.
Lo caro es traer la copia una vez. A partir de ahí, lo que viaja son los cambios.
Lo que pesaba la carga de un clúster grande
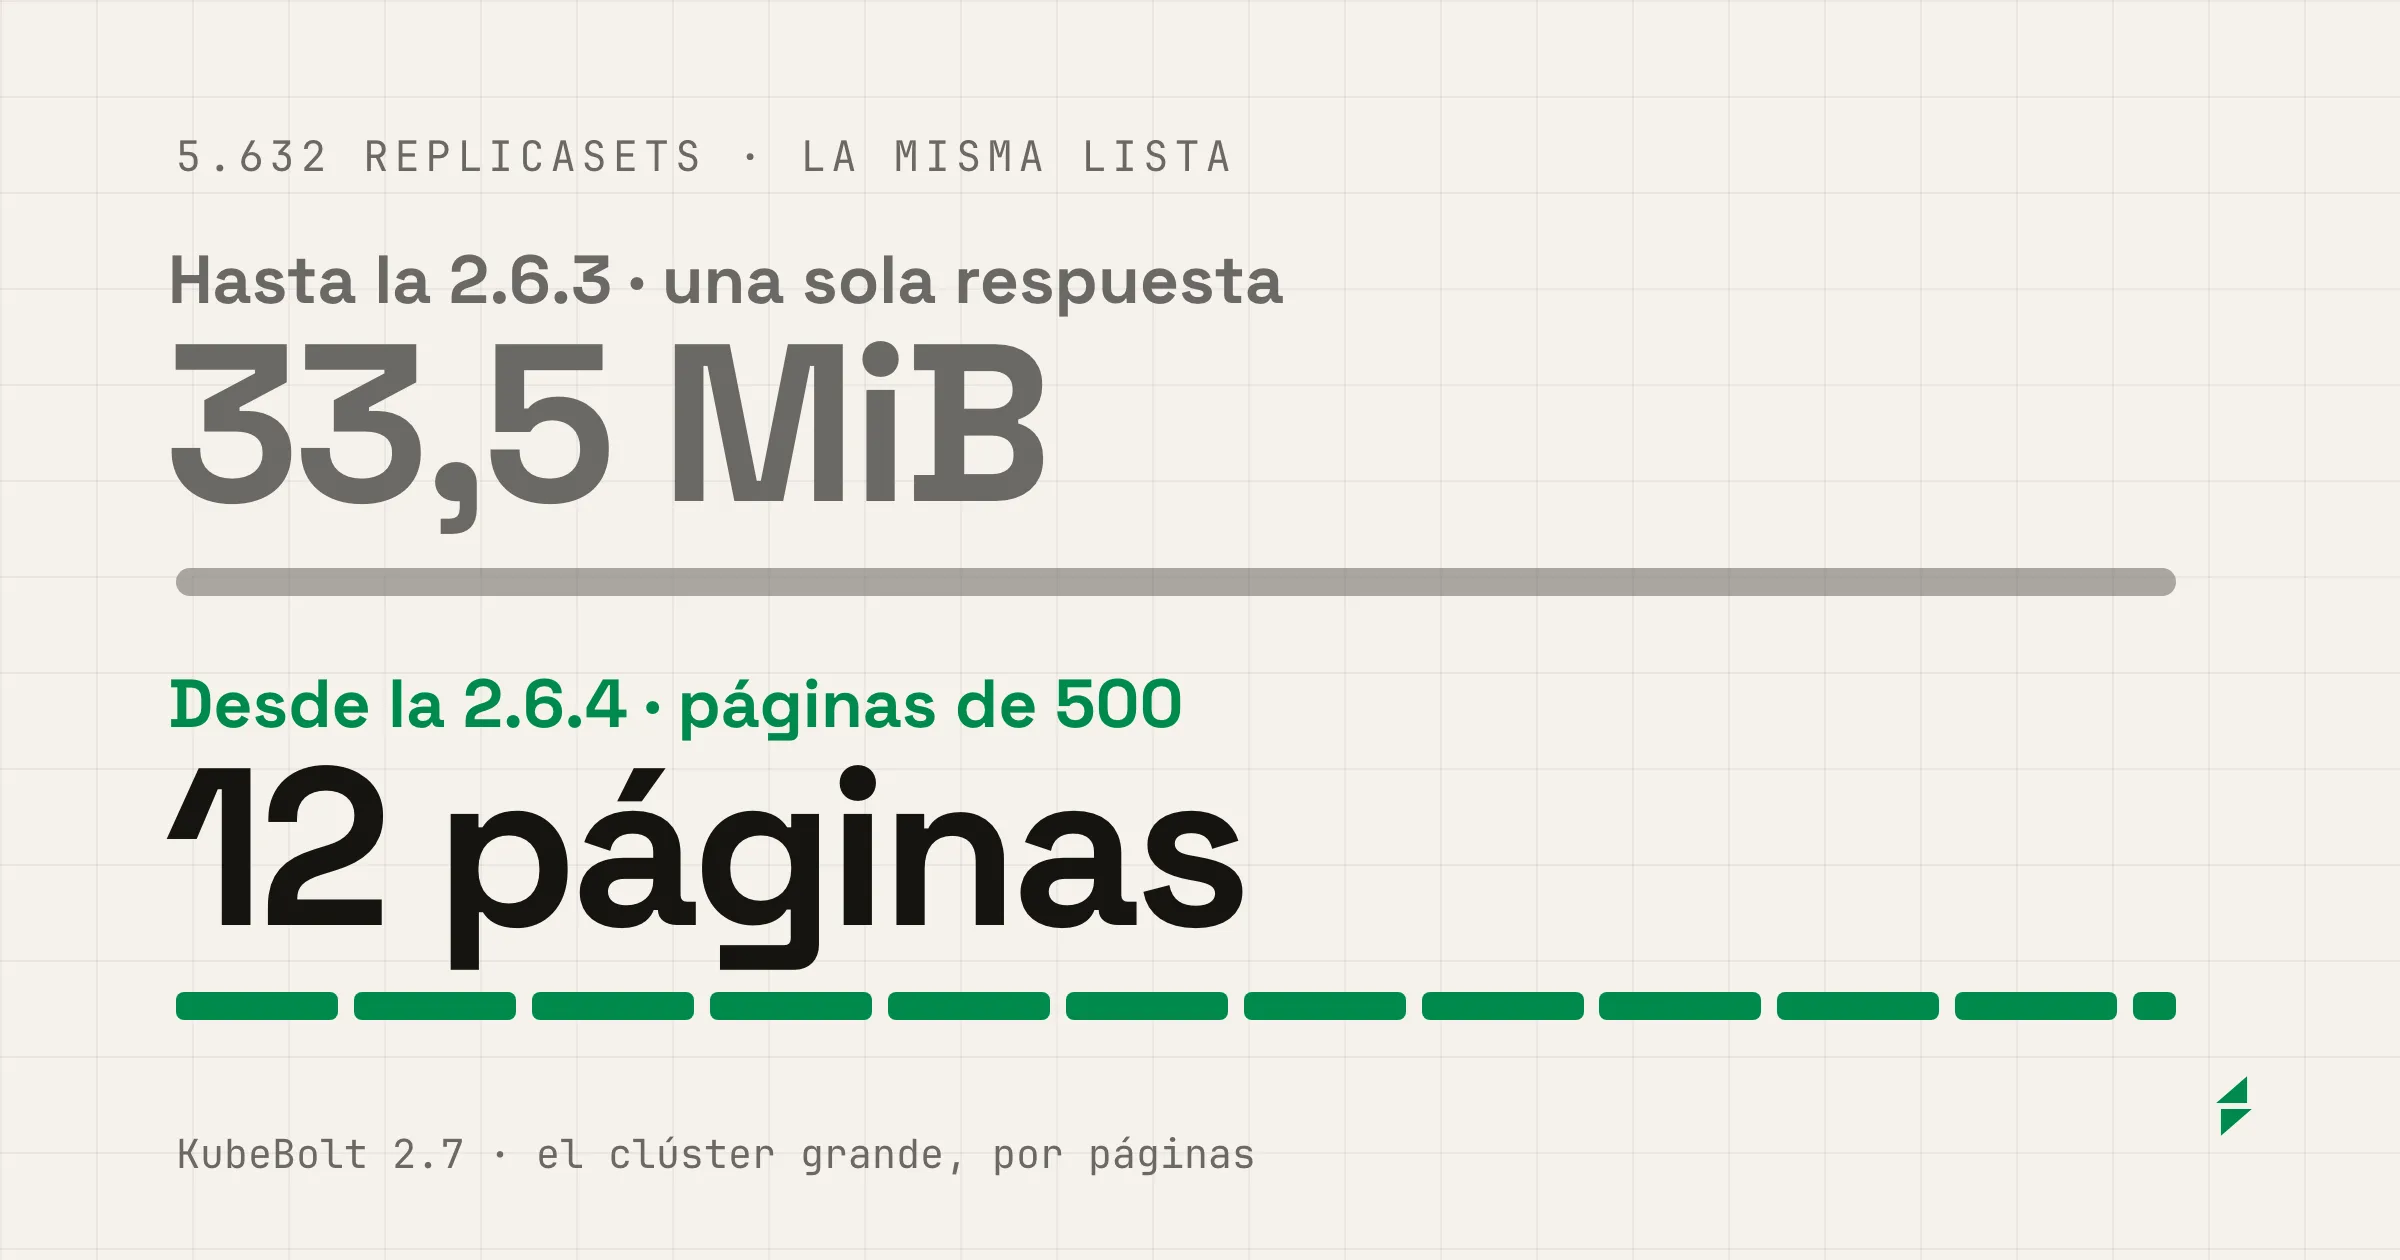
El clúster de nuestro cliente se conectaba a través del agente, que abre un canal de salida hacia KubeBolt para que no haya que exponer nada del clúster. Cada respuesta del API server cruza ese canal, y la lista de ReplicaSets lo cruzaba de golpe: 33,5 MiB en una sola respuesta.
La causa es un detalle de Kubernetes. Los informers piden la lista en páginas de 500, pero con resourceVersion=0, que le permite al API server responder desde su caché. Desde la caché, el API server ignora el tamaño de página y devuelve la colección entera. El agente tenía que guardar esa respuesta en memoria, dos veces mientras la reenviaba, con el límite de 128 Mi que traía el chart. Kubernetes lo mataba por falta de memoria a mitad de la conexión.
La lista de ReplicaSets de un clúster con 5.632
Hasta la 2.6.3 · una sola respuesta
Desde la 2.6.4 · 12 páginas de 500, de unos 3 MiB
Memoria del agente durante la conexión
Una respuesta entera, dos copias en memoria
Página a página
- Desde la 2.6.4, la carga inicial pide las páginas sin
resourceVersion=0, y el API server las respeta. Los 5.632 ReplicaSets llegan en 12 páginas de 500, y cada página se sigue sirviendo desde la caché del API server, sin leer etcd entero. - En nuestro laboratorio, con un clúster del mismo tamaño, la memoria del agente durante la conexión bajó de 113-125 MiB a unos 64 MiB.
- Los watches no cambian: los cambios siguen llegando uno a uno.
Lo que KubeBolt releía sin que nadie mirara
Con el clúster ya conectado, medimos todo lo que cruzaba el canal del agente minuto a minuto. Dos lecturas periódicas pesaban mucho más de lo que debían.
La primera es la comprobación de la copia. Cada 5 minutos, KubeBolt cuenta pods, Deployments y ReplicaSets en el clúster y en su copia para detectar si se han desviado. Para contar pedía un solo objeto y leía el total en el campo remainingItemCount, pero llevaba el mismo resourceVersion=0, y el API server devolvía las tres listas completas. En un clúster de ese tamaño eran unos 40 MB cada cinco minutos.
La segunda es la historia de Helm. Helm guarda cada revisión de cada release como un Secret con la release entera: el chart, los values y todos los manifiestos renderizados. KubeBolt la descargaba al conectar y la volvía a listar cada minuto, para dos insights y para la página de Applications, aunque solo el detalle de una release necesita esa historia.
| Lectura | Antes | Desde la 2.6.4 y la 2.6.5 |
|---|---|---|
| Comprobación de la copia, cada 5 minutos | Las listas enteras de pods, Deployments y ReplicaSets | Un objeto por tipo: 2-3 KB |
| Secrets de Helm con Overview abierto | 7.225 KiB por minuto | 11,7 KiB por minuto |
| Todo el canal del agente, en reposo | 7.342 KiB por minuto | 227 KiB por minuto |
| Lista de Applications, ya cargada | 136 ms | 0,5 ms |
Las cifras de Helm son de nuestro laboratorio, con 10 releases y 18 revisiones. Lo que la tabla no enseña es dónde caía ese trabajo: cada una de esas lecturas pasaba también por el API server de tu clúster, y la comprobación de la copia y los insights corrían aunque nadie tuviera KubeBolt abierto.
Ahora la copia de los Secrets deja fuera los de Helm, y sus listas y recuentos leen solo los metadatos, una vez por minuto. El contenido de una release se lee cuando algo lo necesita: la última revisión, una vez, para la lista de Applications o para un insight sobre una release fallida, y el detalle lee solo esa release.
Mientras carga, ves cuánto falta
Hasta la 2.6.4, un clúster que cargaba enseñaba «Connecting to cluster» y nada más. Si la conexión fallaba, no había forma de saber por qué ni cuándo lo volvería a intentar. Desde la 2.6.5, la pantalla de carga enseña el proceso entero.
- Cuatro pasos: los agentes conectados, el acceso comprobado (con los tipos que el rol no deja leer, si los hay), la carga del clúster y la primera evaluación de salud.
- Una barra que avanza con los bytes, porque es lo que tarda en cruzar el canal: un ReplicaSet pesa muchas veces lo que un evento. Cuando la carga espera a una colección grande, la nombra.
- Lo que ha llegado y a qué velocidad, el tiempo transcurrido, una estimación de lo que falta y un registro de lo que va pasando.
- La CPU y la memoria del clúster, que llegan por las métricas de los agentes y no esperan a que termine la carga.
Con la pantalla cambió también cómo se comporta una conexión lenta:
- Los plazos de conexión cuentan el tiempo que pasa sin recibir nada del clúster. Una conexión que sigue recibiendo páginas continúa hasta 10 minutos, y un agente atascado falla en el mismo momento que antes.
- Si una conexión falla, KubeBolt espera 30 segundos antes de reintentar, luego 1, 2 y 4 minutos, y como máximo 5, y la pantalla dice cuándo será el siguiente intento. Antes, cada petición del portal lanzaba una conexión nueva: en el laboratorio fueron 710 MB en 14 minutos sin llegar a conectar.
- Si no puede listar los namespaces, lo reintenta, y si sigue sin poder, te dice qué tipos se quedan sin acceso. Antes se limitaba en silencio a
default,kube-systemykube-public.
El agente 1.4.10, con margen
La 1.4.10 sube los límites por defecto del agente a 256 Mi de memoria y 500m de CPU. Los requests no cambian, así que el scheduling tampoco. Una respuesta que no cabe en su memoria ya no lo tumba: el agente acepta respuestas de hasta un cuarto de su límite de memoria, 63 MiB como máximo, y por encima contesta con un error que dice el tamaño máximo, el límite y el valor que hay que subir, resources.limits.memory.
Si un agente se queda sin memoria de todas formas, los insights OOMKilled y Memory Near Limit te dan el helm upgrade que la sube al doble. Y desde la 2.7, la página de Clusters marca el clúster cuyo agente conviene actualizar, con el comando listo para copiar.
Un resumen en lugar de cientos de avisos
La primera evaluación de un clúster grande abre muchos insights a la vez. En aquel clúster de desarrollo fueron casi 600, la mayoría Services sin endpoints listos, algo normal en un entorno así, y cada uno salía como una notificación.
Desde la 2.6.4, cuando un clúster abre 5 o más insights en 60 segundos, Slack, Discord y el correo inmediato reciben un solo resumen en cuanto el clúster lleva 30 segundos tranquilo. Dice cuántos hay de cada severidad, nombra los críticos y lista cada regla con su cuenta y los namespaces más afectados. Si la ráfaga no para, llega un resumen parcial cada 5 minutos como mucho. En el laboratorio, una reconexión con 502 insights dejó cuatro avisos sueltos y un resumen por canal.
En pantalla, un clúster con muchos namespaces también se lee mejor. Workloads by namespace, en Overview, enseña 12 namespaces, primero los que necesitan atención, y deja el resto tras Show all, que avisa si entre los ocultos hay alguno que la necesita. La página de Namespaces pagina de 50 en 50, los cuenta todos y filtra por nombre.
Si instalas KubeBolt tú mismo
Actualiza el backend a la 2.7.0 y el agente a la 1.4.10 en cada clúster, con el contexto de kubectl de ese clúster:
helm upgrade kubebolt oci://ghcr.io/clm-cloud-solutions/kubebolt/helm/kubebolt \
  --version 2.7.0 -n kubebolt --reset-then-reuse-values

helm upgrade kubebolt-agent oci://ghcr.io/clm-cloud-solutions/kubebolt/helm/kubebolt-agent \
--version 1.4.10 -n kubebolt-system --reset-then-reuse-values--reset-then-reuse-valuesnecesita Helm 3.14 o posterior. No uses--reuse-values: conserva los valores por defecto del chart anterior, y el agente se quedaría con 128 Mi.- Si subiste a mano los plazos de conexión para conectar un clúster grande, puedes devolverlos a sus valores por defecto.
- Si el namespace del agente tiene una ResourceQuota sobre los límites, deja sitio para los nuevos.
Lo que cambia según el tamaño
En un clúster pequeño, casi nada de esto se nota, salvo una pantalla de carga que dura unos segundos. En uno grande, decide si llega a conectar. Y en todos, KubeBolt le pide a tu API server bastante menos que antes.