La forma más rápida de construir un producto de AI Ops que pierda dinero con cada cliente es elegir tu modelo más inteligente y enrutar todo a través de él. Se siente responsable: razonamiento de nivel Opus en cada alerta, sin concesiones, calidad máxima. Después llega la factura y descubres que acabas de pagar precio de modelo de frontera para clasificar un reinicio rutinario de pod como “probablemente esté bien”.
Este es el error que casi todos cometen primero, y es justo el que el motor Autopilot de KubeBolt fue diseñado para evitar. La tesis es simple: casi ningún paso de un incidente necesita tu mejor modelo, y buena parte de lo que detectas no tiene por qué llegar a ninguno. El truco está en saber cuál es cuál antes de gastar los tokens, y en medirlo en lugar de suponerlo.
El enfoque ingenuo y por qué quema dinero
Los clústeres de Kubernetes son mangueras de eventos. Un solo clúster bajo estrés moderado emite cientos de eventos Warning por hora: BackOff, FailedScheduling, OOMKilled, fallos pasajeros de probes, el pod que reinicia una vez y se recupera. Si tu arquitectura es “cada evento va a un modelo grande”, estás pagando precio de frontera por un flujo que es, en su gran mayoría, ruido y patrones bien conocidos.
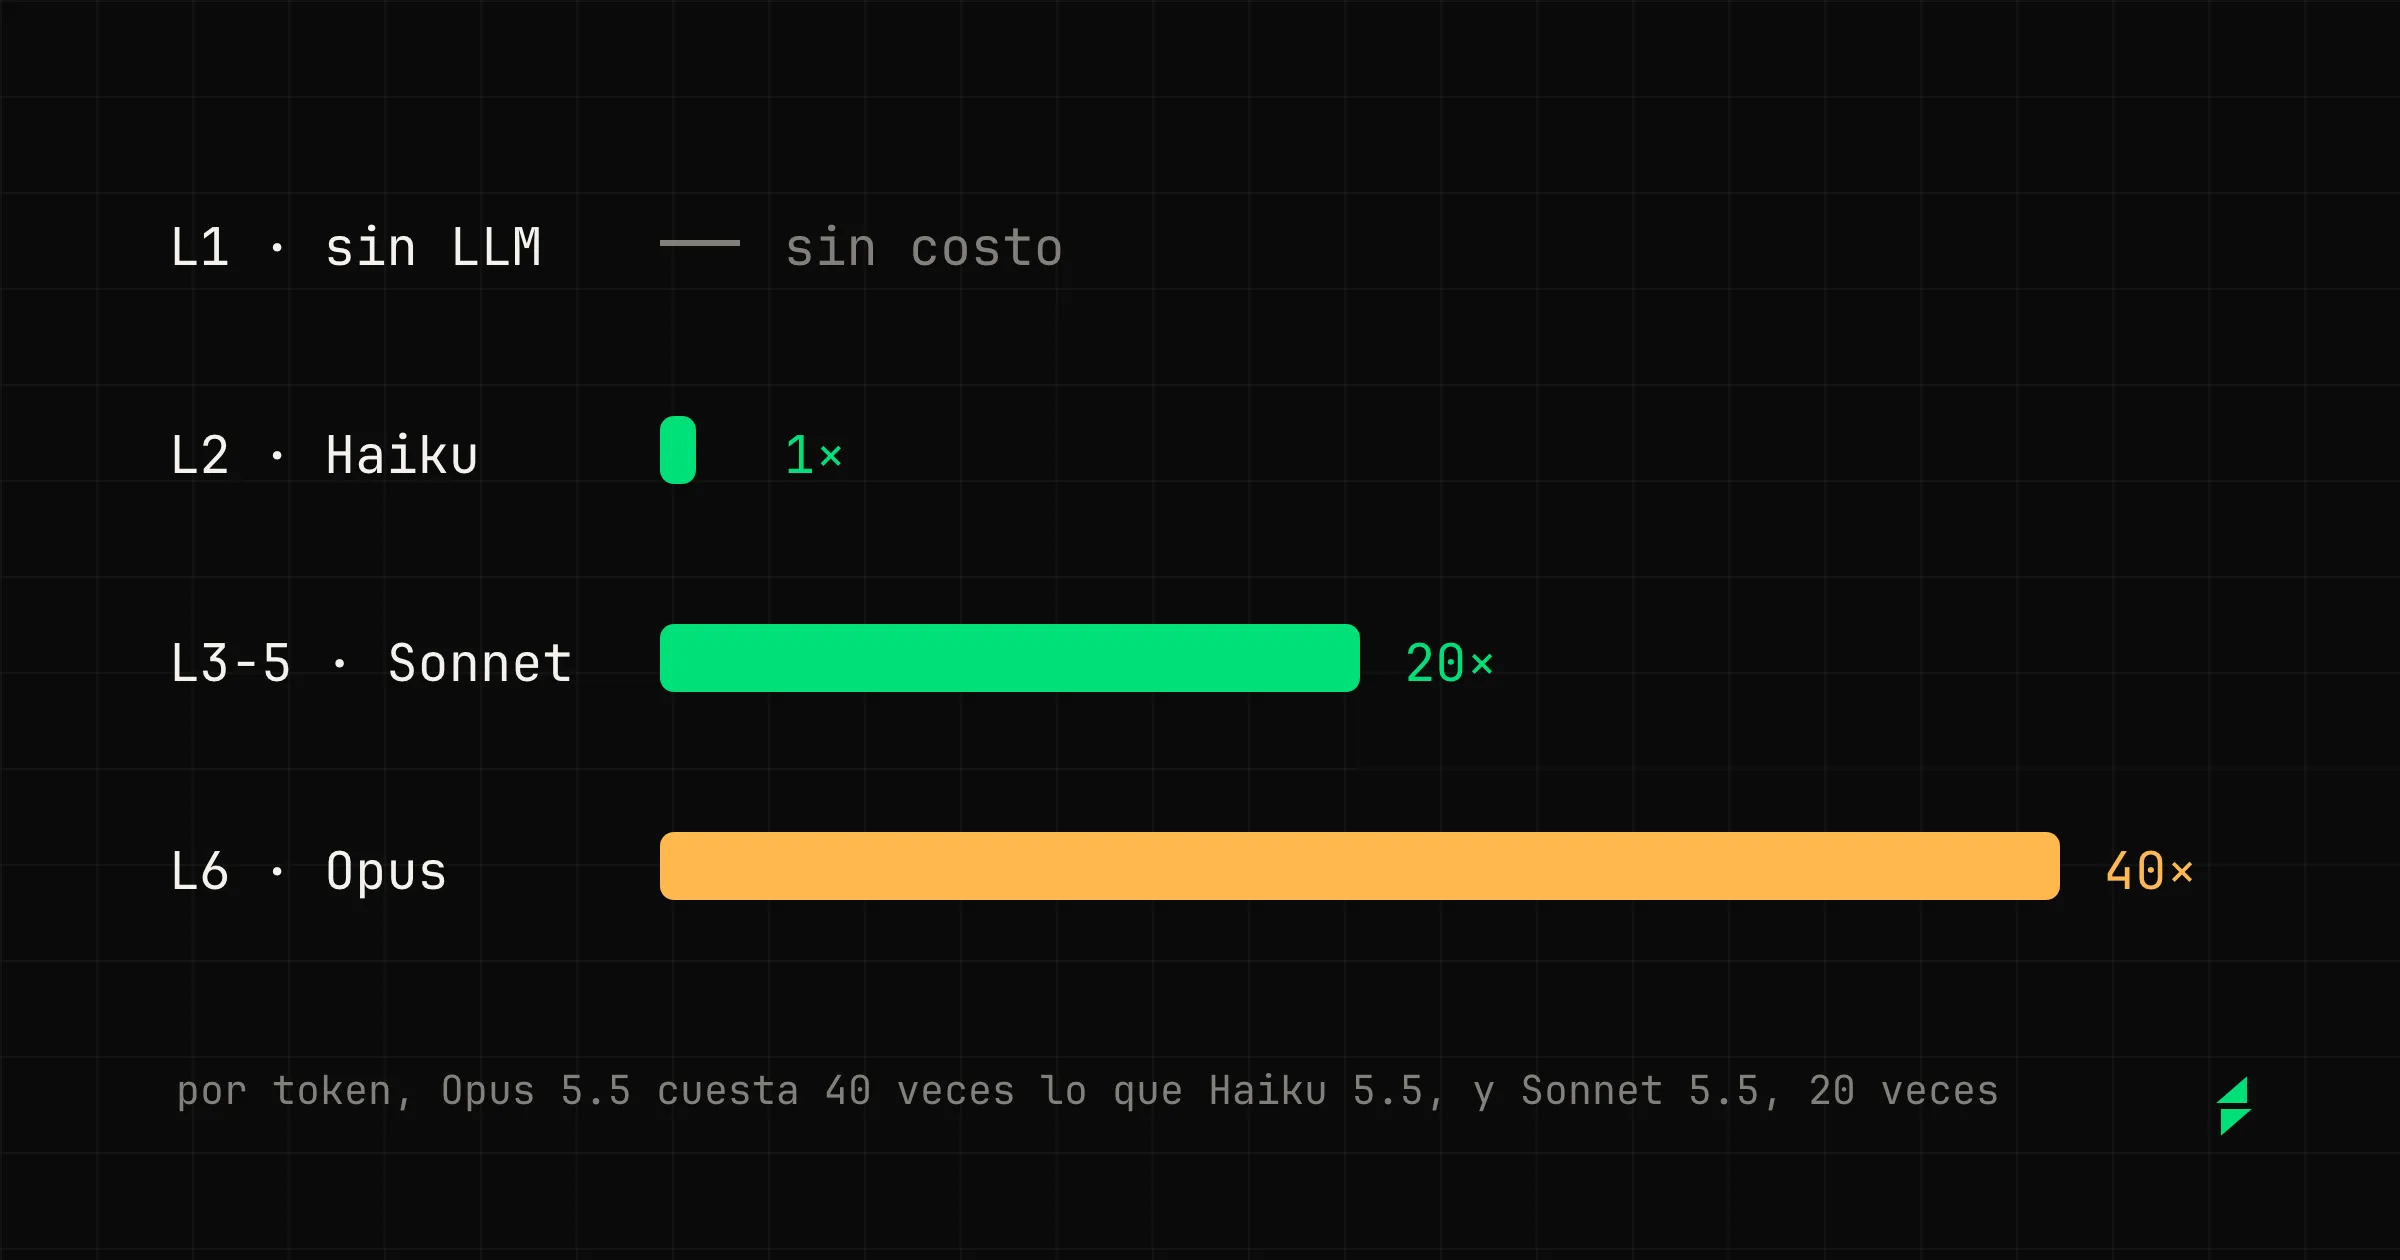
La estructura de precios de los modelos lo vuelve brutal. Los números se mueven con cada versión, así que trata cualquier cifra como una foto. La de hoy: por token, Claude Sonnet 5.5 cuesta 20 veces lo que Claude Haiku 5.5, y Claude Opus 5.5, 40 veces. Y una investigación no es una llamada: encadena varias con herramientas, cada una con el contexto acumulado. Pásale todo al modelo grande y tu costo por incidente queda dominado por los incidentes que nunca necesitaron tanta inteligencia.
Peor aún: es más lento y no más preciso. Un modelo de frontera al que le preguntas “¿este reinicio de pod es ruido?” te da la misma respuesta que uno barato, solo que más tarde y más caro. Lo medimos, y lo contamos más abajo.
Cómo reparte KubeBolt el trabajo entre sus capas
Autopilot es un motor de seis capas. Cinco usan un modelo, y cada una tiene el más barato que hace bien su trabajo. Este es el reparto por defecto:
| Capa | Trabajo | Modelo por defecto | Precio por token | Cuándo se usa |
|---|---|---|---|---|
| L1 Detector | Reconocer el problema y decidir si entra | ninguno | nada | En cada hallazgo |
| L2 Router | Triage: severidad real y si sigue | Haiku 5.5 | 1× | Hallazgos de los 8 tipos catalogados |
| L3 Investigador | La causa, con herramientas y varios turnos | Sonnet 5.5 | 20× | Lo que el triage deja pasar |
| L4 Planner | El plan, dentro de un catálogo cerrado | Sonnet 5.5 | 20× | Cuando hay una causa |
| L5 Executor | Aplicar el plan con acciones tipadas | Sonnet 5.5, o ninguno | 20×, o nada | En cada plan aprobado |
| L6 Postmortem | Escribir el informe | Opus 5.5 | 40× | Una vez, al cerrar |
Cada etapa tiene además un modelo de respaldo, y un administrador de la plataforma puede cambiar los dos.
La capa 1, el Detector, no usa modelo, y su trabajo es decidir qué entra. Son las 24 reglas deterministas del Insights Engine, el mismo que viene en el agente open source. No resuelven nada: destapan el problema y te lo dejan con su recomendación. Lo que ahorra tokens es que Autopilot solo abre un incidente para los 8 tipos que sabe tratar con su catálogo de acciones. Todo lo demás se queda en un hallazgo para ti, y no llega a ningún modelo. La capa más importante de un sistema construido sobre LLMs es la que no llama a ninguno.
La capa 2, el Router, es un triage con Haiku 5.5. Clasifica el hallazgo, decide su severidad con evidencia de impacto y decide si merece una investigación. El ruido para aquí. Es a propósito el modelo más barato haciendo la tarea más barata, porque el triage es un filtro, no un análisis. Corre sin razonamiento extendido: cuando lo probamos con razonamiento, el resultado empeoraba, porque investigaba más de lo que caben sus cinco turnos.
La capa 3, el Investigador, es de nivel Sonnet, y aquí ocurre el trabajo real. Usa herramientas en varios turnos, hasta catorce: trae logs, describe el deployment, consulta métricas, cruza eventos y despliegues recientes. Itera hasta dar con una causa en la que confía, o marca que hace falta una persona. Sonnet es el nivel correcto aquí porque investigar necesita razonamiento de verdad y manejo de herramientas, pero no la frontera absoluta.
La capa 4, el Planner, también es Sonnet. En una versión anterior de este artículo contábamos que los planes difíciles subían a Opus. No es así. El Planner elige acciones de un catálogo cerrado de ocho (seis que cambian el clúster, una que verifica y una que solo recomienda) y les pone parámetros que la herramienta valida. Es una decisión acotada, y Sonnet la toma bien.
La capa 5, el Executor, aplica el plan. Por defecto es un agente con Sonnet que solo puede llamar a las acciones tipadas, en orden, y cada llamada pasa por una compuerta escrita en código: aprobaciones, namespaces bloqueados, cancelación. En la edición Enterprise puede ser código sin modelo (autopilot.executor: code), y entonces ejecutar no gasta tokens. En los dos casos, ningún modelo decide algo que no esté en el catálogo.
La capa 6, el Postmortem, es el único lugar con Opus. Corre una vez, cuando el incidente se cierra, fuera del camino crítico. Ahí gastamos con gusto en calidad, porque no bloquea nada y es el informe que de verdad lee una persona. Opus no es el modelo por defecto desde el que optimizas hacia abajo: es la excepción, y la ponemos donde su precio rinde más.
Lógica de enrutamiento: qué decide cada paso
El paso de una capa a la siguiente no va por intuición. Cada frontera tiene una señal explícita:
- De la capa 1 a la 2: el hallazgo pertenece a uno de los 8 tipos catalogados. Si no, se queda como hallazgo, con su recomendación, y no gasta nada.
- De la capa 2 a la 3: el Router decide que no es ruido. Es el filtro de mayor palanca del sistema, porque es la compuerta barata que evita que el ruido llegue a un modelo veinte veces más caro.
- De la capa 3 a la 4: el Investigador llega a una causa. Si concluye que hace falta una persona (porque la causa está fuera del clúster, por ejemplo), el plan no toca nada y el incidente pasa a ella.
- De la capa 4 a la 5: la confianza del plan supera el umbral de su tipo de incidente, 0.7 en general y 0.85 donde una acción equivocada hace más daño. Si no, el plan se queda en sugerencia.
Encima va el control de consumo. Un límite de concurrencia hace que una mala tarde no se abra en abanico hacia decenas de investigaciones en paralelo: las demás esperan en cola. Y el gasto de créditos puede repartirse a lo largo del mes, para que un día con muchos incidentes no se coma el presupuesto de los siguientes; los críticos pueden saltarse ese reparto.
Los números, con honestidad
Aquí viene la parte donde los vendedores de AI Ops suelen citar una cifra en dólares sospechosamente redonda. Nosotros también lo hicimos: en la primera versión de este artículo decíamos “menos de un dólar por incidente, de punta a punta”. Era una estimación del MVP, no una medición, y la retiramos.
Lo que sí tenemos son mediciones por etapa. Antes de cambiar el modelo por defecto de una etapa, la probamos por separado con un arnés, sobre casos grabados en nuestro laboratorio, con las herramientas de lectura respondidas por un servidor de repetición. Dos de esas mediciones:
- Triage, Haiku 5.5 frente a Haiku 4.5 (195 corridas sobre 39 casos): las mismas decisiones de regla y severidad, la mitad de latencia (8 segundos de mediana) y 14 veces menos costo por corrida. Las 195 corridas costaron 0,32 USD, menos de dos décimas de céntimo cada una.
- Investigador, Sonnet 5.5 frente a Sonnet 5 (31 casos): la causa correcta en todas las corridas con los dos modelos, pero Sonnet 5.5 nombró el remedio en el 100 % de los casos frente al 90 %, costó un 22 % menos por corrida (0,021 USD) y respondió un 25 % más rápido (10 segundos de mediana).
Fíjate en la proporción: una corrida del investigador cuesta unas trece veces lo que una del triage. Ese es el gradiente funcionando. El ruido se filtra por una fracción de céntimo, y el dinero de verdad se gasta solo en lo que ha pasado el filtro.
Son cifras de laboratorio, no de producción, y no suman un costo de punta a punta: para eso falta medir el incidente entero, con todas sus etapas, con el mismo cuidado. Cuando lo tengamos, lo publicaremos. Lo durable no es ningún número en dólares: es la proporción entre niveles y la arquitectura que la aprovecha.
Resiliencia: respaldo, freno y otro motor
Repartir entre niveles de modelo resuelve el costo. La disponibilidad es otro problema, y conviene ser precisos sobre lo que tenemos.
Cada etapa tiene un modelo de respaldo. Si el principal falla o se agota el tiempo, la etapa reintenta con el respaldo en vez de perder el incidente. El respaldo es la versión anterior del mismo modelo, probada antes de que llegara la nueva.
Delante va un circuit breaker, que nació de un mal día. Una tarde, la API de nuestro proveedor dejó de responder durante hora y media, y Autopilot siguió empezando ejecuciones como si nada: cada etapa agotaba su tiempo, reintentaba con el respaldo, lo volvía a agotar, y cada ejecución acababa a los veinticinco minutos sin haber hecho nada. Ahora, después de varios fallos seguidos por causa del proveedor, el freno se abre y no empieza ninguna ejecución nueva. Pasado un rato deja pasar una de prueba: si sale bien, se cierra; si no, espera otra vez.
Y hay otro motor. Desde la versión 2.5, además del SDK de agentes de Anthropic, Autopilot puede correr en la edición Enterprise sobre un motor gateway que habla con cualquier endpoint compatible con OpenAI, como GLM o Kimi, con su propio modelo y respaldo por etapa. Lo elige un administrador. No es un salto automático de un proveedor a otro cuando uno se cae; es la posibilidad de no depender de uno solo. Kobi Copilot, por su parte, corre en KubeBolt Cloud con Anthropic como principal y OpenAI como respaldo.
El trade-off honesto
Nada de esto es gratis, y sería deshonesto fingir lo contrario. Una arquitectura de un solo modelo es genuinamente más simple: un cliente, un estilo de prompt, un conjunto de modos de fallo, una sola cosa sobre la que razonar. Lo que describimos son seis etapas, prompts por etapa, umbrales de confianza que hay que calibrar, una cola, un reparto de créditos, un circuit breaker, modelos de respaldo y dos motores. Eso es superficie operativa real: más código que probar, más bordes donde equivocarse.
Esa complejidad se siente más cuando el reparto falla. Un Router demasiado agresivo marca un incidente real como ruido y se te escapa algo; uno demasiado tímido deja pasar ruido a investigaciones pagadas y se come en silencio el ahorro que justifica todo el diseño. Los umbrales de cada frontera derivan. Por eso medimos cada etapa antes de cambiarle el modelo, y por eso es trabajo continuo, no una configuración que se hace una vez.
Así que el planteamiento honesto es un canje, no un almuerzo gratis: asumes complejidad de ingeniería a cambio de pagar cada paso al precio que su trabajo pide. Para una herramienta que usas de vez en cuando, no vale la pena: usa un buen modelo y sigue. Para un sistema autónomo que procesa cada evento de producción las 24 horas, el costo de no repartir se acumula en cada incidente, y la complejidad se paga sola. Ese es el régimen en el que opera KubeBolt.
Tres LLMs son de verdad mejor que uno. Pero la parte más afilada del diseño es la capa que decide, sin ningún LLM, qué llega a los demás. El panorama completo está en Cómo funciona y en la arquitectura de seis capas, y las reglas de la capa 1 están en GitHub, Apache 2.0, legibles de punta a punta.