Pregúntale a la mayoría de los productos de “AI Ops” cómo llegaron a una conclusión y vas a recibir un encogimiento de hombros disfrazado de funcionalidad. Un modelo miró tu incidente, lo pensó y devolvió una respuesta. Quizás acertó. Quizás alucinó un Deployment que no existe. No hay forma de saberlo, porque el razonamiento vive dentro de una única llamada opaca: entra un prompt, sale un veredicto. Está bien para un chatbot. Es una idea genuinamente mala darle a esa forma la capacidad de hacer kubectl delete en producción.
Construimos KubeBolt Autopilot sobre la premisa opuesta: un motor de operaciones autónomas debería ser tan auditable como el equipo que lo supervisa. No “confía en el modelo”, sino “muestra tu trabajo en cada paso, y deja que el código decida qué se puede tocar”. Ese principio se convirtió en una arquitectura concreta: seis capas, cada una con un solo trabajo, cada una observable por separado. Este post es el recorrido honesto de por qué tiene esa forma, qué te da y dónde cuesta más que el enfoque de caja negra que reemplaza.
El problema del LLM como caja negra
La versión seductora de AI Ops es un único agente con una ventana de contexto enorme y credenciales del clúster. Le das la alerta, lo dejas razonar, lo dejas actuar. Luce impecable. También falla de tres maneras que importan más que la demo.
No rinde cuentas. Cuando una sola llamada hace detección, diagnóstico, planificación y ejecución al mismo tiempo, no hay costura que inspeccionar. No puedes responder “¿por qué escaló ese deployment?” con nada mejor que “el modelo lo decidió”. La revisión posterior al incidente se vuelve arqueología.
Es caro por defecto. Cada incidente, incluido el que es de manual (el pod que murió por OOMKill después de un deploy, el image pull que falló por un tag mal escrito), paga una pasada de razonamiento con un modelo de frontera. Estás alquilando el cerebro de un ingeniero senior para preguntas que un modelo pequeño responde igual de bien.
Es peligroso cuando actúa. Un LLM que decide y ejecuta no tiene ningún freno natural sobre sus propios errores. Si alucina el nombre de un recurso o malinterpreta un nivel de riesgo, el mismo razonamiento defectuoso que produjo el plan también lo lleva a cabo. No hay segunda opinión, porque no hay segundo componente.
La solución no es un mejor prompt. Es separación de responsabilidades, la idea más vieja del diseño de sistemas aplicada al tipo de componente más nuevo. Divide el trabajo en capas, da a cada una una responsabilidad estrecha, y obtienes las dos cosas que las cajas negras no pueden ofrecer: un registro de auditoría y un lugar donde poner los guardarraíles.
La arquitectura: seis capas, un incidente
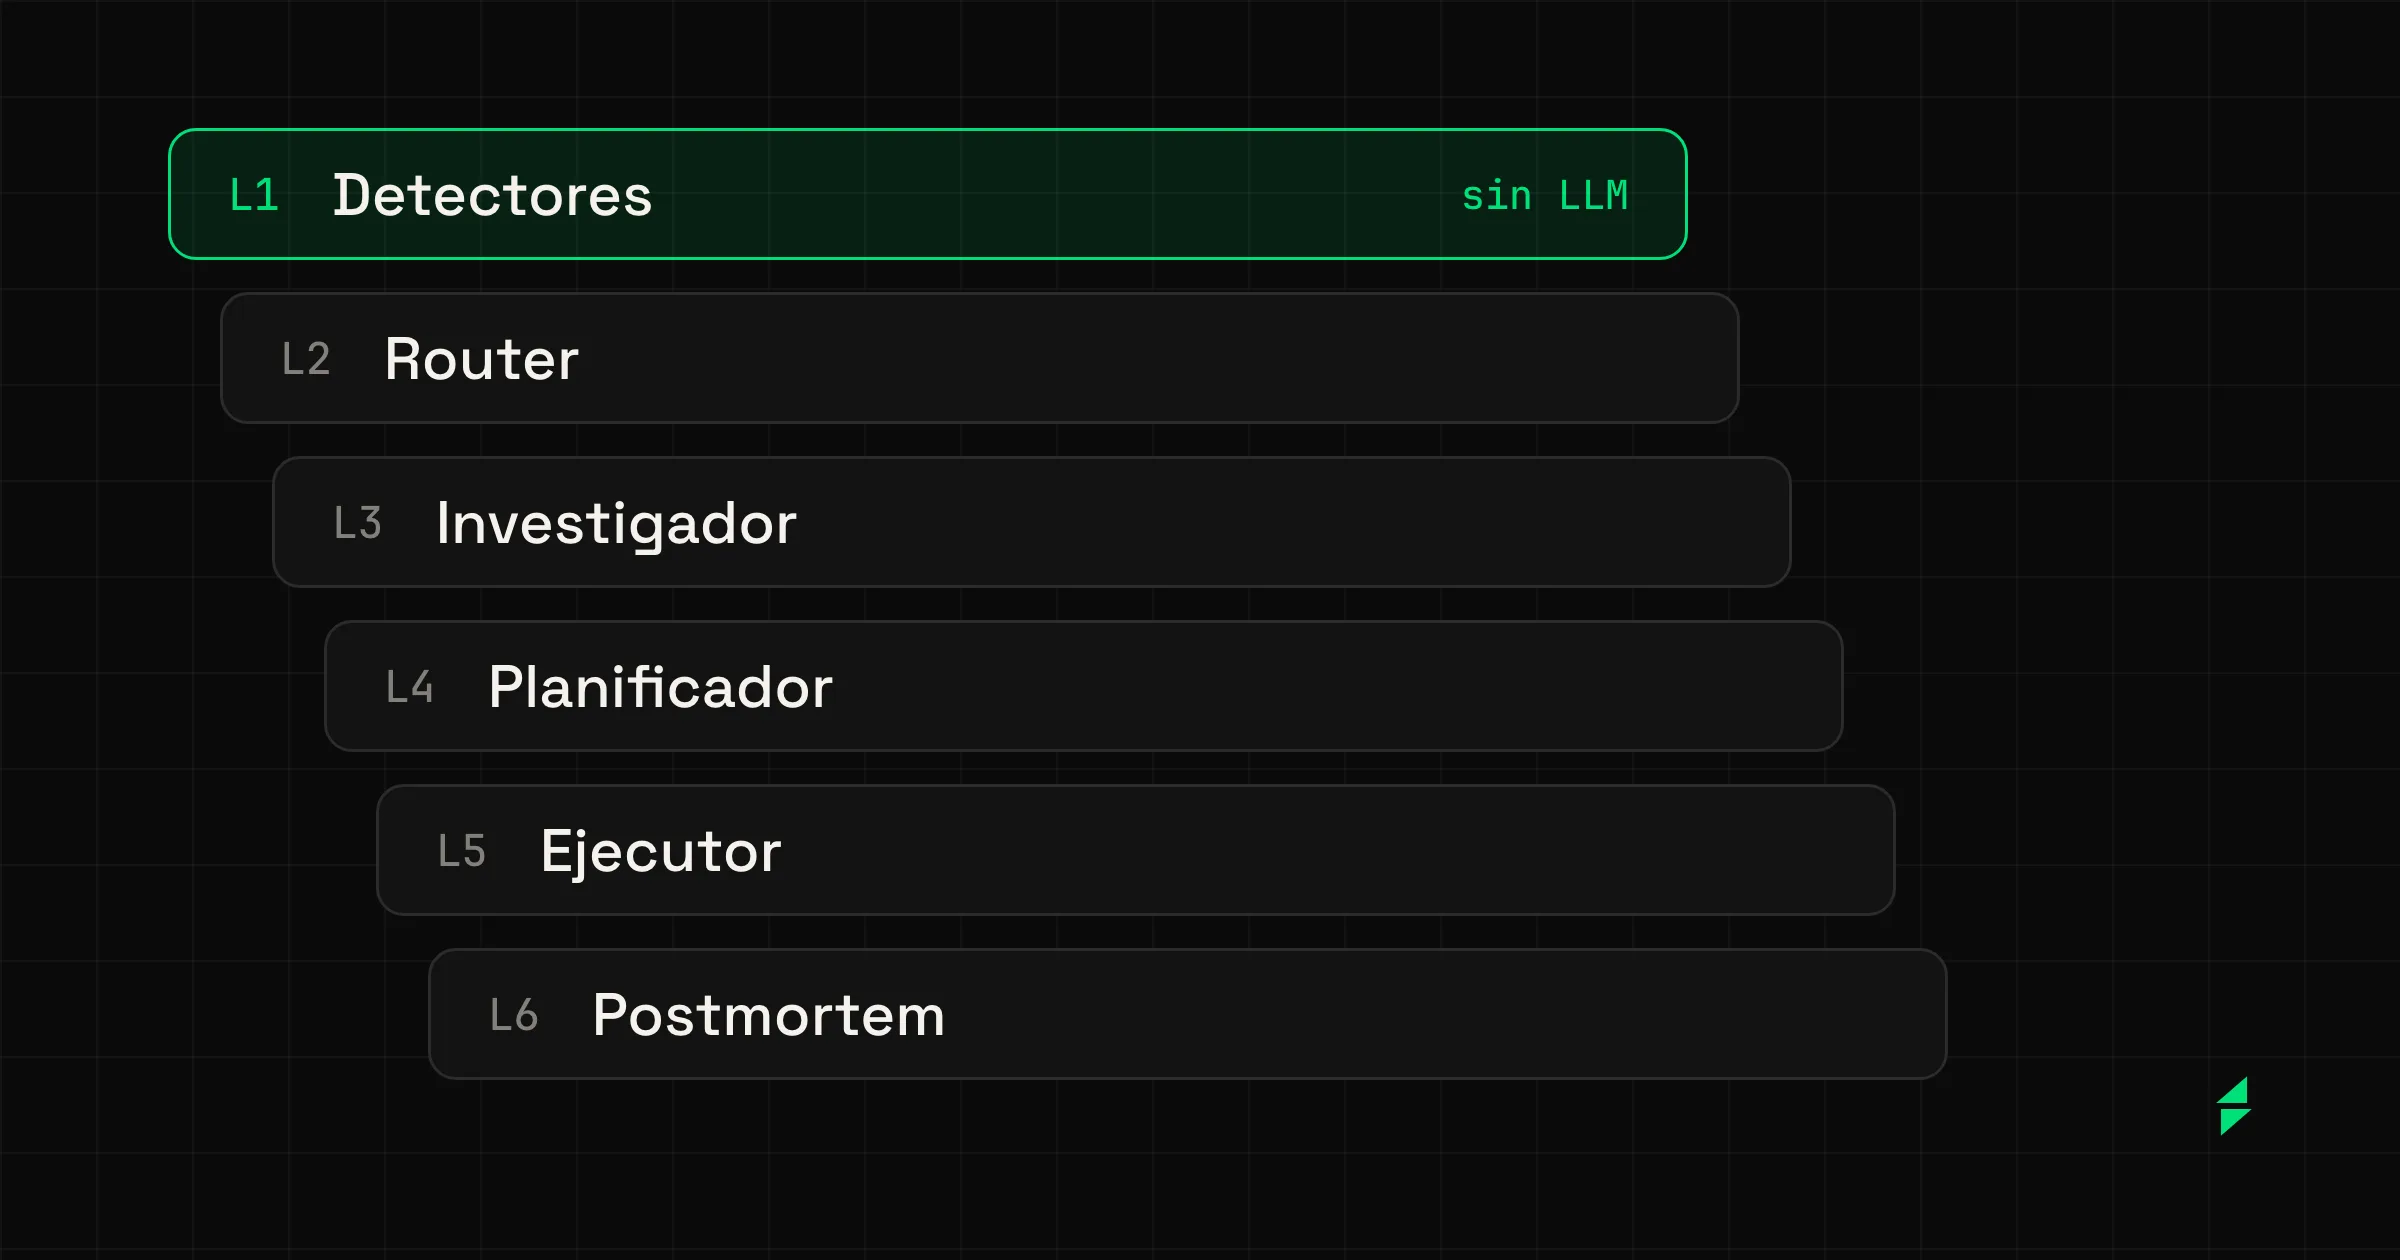
Cada incidente recorre el mismo camino. Cada capa tiene una entrada y una salida definidas, así que se pueden probar por separado y cambiar el modelo de una sin tocar las demás.
L1  Detector       reglas, sin modelo    "¿Es un incidente que Autopilot sabe tratar?"
L2  Router         Claude Haiku 5.5      "¿Es real y cuánto importa?"
L3  Investigador   Claude Sonnet 5.5     "¿Qué está mal de verdad?"
L4  Planner        Claude Sonnet 5.5     "¿Qué hacemos, dentro del catálogo?"
L5  Executor       IA + determinista     "Hazlo, solo con acciones tipadas."
L6  Postmortem     Claude Opus 5.5       "Deja escrito lo que pasó."
Cada etapa tiene su modelo y un respaldo por si falla, y un administrador de la plataforma puede cambiar los dos. Corre sobre el SDK de agentes de Anthropic o, en Enterprise, sobre un motor gateway que habla con modelos compatibles con OpenAI, como GLM o Kimi. Delante va un circuit breaker: si el proveedor deja de responder, Autopilot deja de empezar ejecuciones hasta que vuelve, en lugar de quemar una tras otra. Pero la parte interesante no es a qué modelos llamamos. Es qué les dejamos hacer.
L1 · Detector (reglas)
La primera capa nunca habla con un modelo. Es el mismo motor de reglas que se distribuye como nuestro Insights Engine open source: 24 chequeos deterministas que reconocen los problemas que Kubernetes produce a diario. Crash loops, OOMKills, imágenes que no bajan, probes que fallan, réplicas en cero.
Lo que hacen esas reglas es destapar, no resolver. Cada hallazgo te llega con su recomendación, y lo resuelves tú. Autopilot solo abre un incidente cuando el hallazgo pertenece a uno de los 8 tipos de su catálogo que arrancan una ejecución; el resto lo deja pasar. Cada tipo del catálogo es una entrada declarativa:
{
  ruleId: "image-pull-backoff",
  titlePatterns: ["imagepull", "image pull"],
  minConfidenceToAct: 0.85, // revertir es destructivo: pide confianza alta
  productionNamespaceRequiresApproval: true,
  typicalActionKinds: ["rollback_deployment", "verify_pods_ready"],
}
Esa entrada dice qué reconocer, con cuánta confianza se puede actuar y qué acciones suelen arreglarlo. Añadir un tipo de incidente es añadir una entrada. Lo que no está en el catálogo no entra en el pipeline, y no gasta un solo token.
L2 · Router (Claude Haiku 5.5)
Un hallazgo catalogado todavía no merece una investigación. La pregunta de esta capa es la más barata y la más gruesa: ¿esto es real, y cuánto importa? Los clústeres son ruidosos. Mucho de lo que parece un incidente es un reinicio que ya se recuperó solo.
Así que la Capa 2 es un triage rápido con Claude Haiku 5.5, sin razonamiento extendido y con cinco turnos como mucho. Clasifica el hallazgo contra el catálogo, decide su severidad real (info, warning o critical) y decide si sigue. La severidad exige evidencia de impacto: antes de llamar crítico a algo, mira cuántas réplicas disponibles le quedan al workload dueño. Si es ruido, para aquí. No despierta a nadie y no gasta una llamada a Sonnet.
L3 · Investigador (Claude Sonnet 5.5)
Ahora el trabajo se pone difícil, y ahora sí sacamos un modelo que razona. El Investigador corre Claude Sonnet 5.5 con uso de herramientas en varios turnos, hasta catorce. No recibe un volcado de datos: pide lo que necesita, con las mismas herramientas de lectura que Kobi Copilot pone a disposición de las personas (logs, describe, eventos, métricas, despliegues recientes), bajo la identidad propia de Autopilot.
Itera: forma una hipótesis, junta evidencia, la refina, hasta dar con una causa en la que confía o hasta quedarse sin turnos. Si no llega, no improvisa: marca que hace falta una persona y explica por qué. Cuando la causa está fuera del clúster, sale a leer tu cuenta de AWS en solo lectura, y aun así no la arregla: un fallo fuera del clúster se arregla fuera, y te lo deja nombrado. Si el incidente cae en medio de una rotación de nodos o de un despliegue masivo, dice que la ráfaga es la causa en vez de culpar al workload.
La salida es estructurada: un resumen de la causa, un nivel de confianza y el rastro de evidencia, así quien revise después ve qué vio el modelo, no solo su conclusión. Ese rastro es el antídoto contra la caja negra.
L4 · Planner (Claude Sonnet 5.5)
Diagnosticar y remediar son habilidades distintas, así que son capas distintas. El Planner toma la causa del Investigador y escribe un plan concreto: una lista ordenada de acciones, su riesgo, la duración esperada y cómo deshacerlo si algo sale mal.
Las acciones salen de un catálogo cerrado. Esta es la lista entera:
| Acción | Qué hace | Riesgo |
|---|---|---|
restart_deployment | Reinicia el rollout y recrea los pods | bajo |
scale_deployment | Cambia las réplicas (nunca si lo gestiona un HPA) | medio |
patch_deployment_resources | Ajusta requests y límites de CPU y memoria | bajo |
rollback_deployment | Vuelve a la revisión anterior | alto: siempre pide aprobación |
patch_hpa | Ajusta el mínimo, el máximo o el objetivo de CPU del HPA | medio |
patch_probe | Relaja los tiempos de una probe, nunca su ruta ni su puerto | medio |
verify_pods_ready | Espera a que los pods estén listos | bajo |
inform_only | Recomienda sin tocar el clúster | bajo |
Seis cambian el clúster; las otras dos verifican o informan. Si el modelo pide algo que no está en la lista, no existe: cada acción es una herramienta tipada, y un parámetro inventado se rechaza en la herramienta. Si ninguna acción del catálogo arregla el fallo (una imagen con un error de código, una configuración que faltó desde el primer día), el plan termina en inform_only, nombra el arreglo manual y el incidente pasa a una persona.
Encima va el umbral de confianza de cada tipo de incidente: 0.7 en general y 0.85 donde una acción equivocada hace más daño, como revertir. Si la confianza no llega, el plan se queda en sugerencia. El LLM puede sugerir; no puede inventar capacidades.
L5 · Executor (IA + determinista)
Aquí está la capa que nos deja dormir, y conviene ser precisos sobre por qué. Por defecto, el Executor es un agente con Claude Sonnet 5.5, y lo único que puede hacer es llamar a las acciones tipadas del catálogo, en el orden del plan. Cada llamada pasa por una compuerta escrita en código, que el modelo no puede cambiar: espera la aprobación cuando hace falta, bloquea los namespaces protegidos, impide escalar a cero lo que no debe y respeta una cancelación. Si una acción falla, para. No reintenta ni sigue con las demás.
En la edición Enterprise hay una opción más estricta, autopilot.executor: code: el plan aprobado se ejecuta sin modelo, con las mismas barreras. Y antes de cambiar nada comprueba dos cosas que un modelo no comprobaba: que la condición del incidente sigue presente y que cada acción todavía encaja con el workload tal como está ahora, también después de una aprobación que pudo tardar.
Después viene la verificación: verify_pods_ready espera a que los pods estén listos, 180 segundos por defecto. Si no lo están, Autopilot revierte solo y restaura los valores que había antes del cambio. Ese es el mismo camino protegido, atado a RBAC y auditado, que usa una persona cuando aprueba una acción desde Copilot.
L6 · Postmortem (Claude Opus 5.5)
Cuando el incidente se cierra, corre una última capa, fuera del camino crítico para que nunca frene un arreglo. Claude Opus 5.5 escribe el postmortem: la línea de tiempo, la causa, el impacto que la evidencia demuestra y las tareas pendientes, que se pueden exportar a PDF. Es el único lugar donde gastamos con gusto el modelo grande, porque corre una vez por incidente y es el documento que las personas de verdad leen cuando se asienta el polvo.
Por qué el esquema en capas se gana su lugar
Dos ejes justifican todo el diseño. Colapsa las capas y pierdes los dos.
Separación de coste. Las capas siguen un gradiente deliberado. El Detector no cuesta nada. Por token, Sonnet 5.5 cuesta 20 veces lo que Haiku 5.5, y Opus 5.5, 40 veces. Así que el modelo barato filtra, el intermedio hace el trabajo de verdad y el caro escribe una sola cosa por incidente. Un único agente monolítico cobraría precio de modelo grande por cada tropezón, ruido incluido.
Separación de riesgo. El modelo propone; el código dispone. Diagnosticar y planificar es trabajo creativo, y ahí es donde los modelos brillan. Pero actuar sobre infraestructura de producción es justo el tipo de tarea que quieres rígida, predecible y acotada. Con un catálogo cerrado de acciones tipadas (L4) y una compuerta en código delante de cada una (L5), obtenemos diagnóstico creativo sin destrucción creativa. El radio de impacto de una alucinación es una acción que no existe, no un namespace borrado.
Encima van los guardarraíles que controla el operador. Tres modos: suggest_only (investiga y propone, nunca toca; es el de por defecto), approve_and_execute (apruebas cada acción) y autonomous (en beta abierta, y lo destructivo sigue pidiendo tu firma). kube-system está protegido siempre y no se puede desproteger, y puedes bloquear más namespaces. El modo autónomo puede limitarse a una ventana horaria. Una aprobación que nadie responde caduca. Y el gasto de créditos puede repartirse a lo largo del mes, para que un mal día no se coma el de todos los demás.
La llamada más barata es la que no haces
Si te llevas una sola cosa de este post, que sea esta: la llamada al LLM más barata es la que nunca haces. Pero conviene decir bien dónde se ahorra.
No se ahorra porque las reglas resuelvan incidentes. No resuelven ninguno. Se ahorra porque el Detector decide qué entra: de todo lo que las 24 reglas encuentran, Autopilot solo trata los 8 tipos que sabe arreglar con su catálogo. Lo demás te llega como hallazgo, con su recomendación, sin gastar un token. Y de lo que entra, el triage con el modelo más barato para el ruido antes de que llegue a uno más caro.
Esto invierte el discurso habitual de AI Ops, que arranca con el modelo de frontera y le da las llaves. Nosotros arrancamos acotando: qué entra, qué se puede hacer y quién aprueba. El modelo trabaja dentro de ese perímetro. Es menos vistoso. Es mucho más fácil de confiar.
Los tradeoffs honestos
Esta arquitectura no es gratis, y fingir lo contrario sería justo el tipo de deshonestidad de respuesta mágica contra la que estamos argumentando. Esto es lo que cuesta.
Es más compleja de construir y operar. Seis etapas coordinadas, un estado por incidente, una cola con límite de concurrencia, modelos de respaldo, un circuit breaker, dos motores: son bastantes más piezas que “llama al modelo, ejecuta la salida”. Un agente monolítico es genuinamente más simple de levantar. Asumimos la complejidad porque la auditabilidad y la seguridad no son opcionales en infraestructura de producción, pero es complejidad real, y es nuestra.
Gastamos más en ingeniería para gastar menos en inferencia. Mucho de nuestro esfuerzo va a la parte poco glamurosa: escribir y mantener reglas, curar el catálogo de acciones, endurecer la compuerta, medir cada modelo antes de ponerlo por defecto. Es trabajo humano que un enfoque de puro LLM se salta empujándolo todo al modelo. Creemos que es el canje correcto, pero el coste se mueve de tu factura de inferencia a nuestro código.
Las fronteras entre capas suman latencia y traspasos. Pasar un incidente por etapas discretas, guardando el estado en cada una, es más lento que un único flujo de razonamiento. Creemos que unos segundos más en un incidente son un precio justo por saber exactamente qué pasó y poder revertirlo.
El catálogo tiene un techo. Autopilot solo arregla lo que su catálogo cubre: 8 tipos de incidente y seis acciones. Todo lo demás termina en una persona, con la investigación hecha. Es la red de seguridad funcionando, pero significa que la cobertura depende de cuántos tipos sepamos tratar bien, y eso es una inversión continua, no un problema resuelto.
Números reales, presentados con honestidad
Antes de cambiar el modelo por defecto de una etapa, lo medimos con un arnés que la prueba por separado, sobre casos grabados en nuestro laboratorio. Las herramientas de lectura las responde un servidor de repetición, sin clúster de por medio. Son cifras de laboratorio, no un SLA, pero son medidas:
- Triage con Haiku 5.5: 195 corridas sobre 39 casos, las mismas decisiones de regla y severidad que su predecesor, 0,32 USD en total (menos de dos décimas de céntimo por corrida) y 8 segundos de mediana.
- Investigador con Sonnet 5.5: 31 casos, la causa correcta en 93 de 93 corridas, el remedio nombrado en 50 de 50, la petición de una persona cuando tocaba en 54 de 54, 0,021 USD por corrida y 10 segundos de mediana.
Lo que no tenemos todavía medido con el mismo cuidado es el coste de punta a punta de un incidente, así que no lo damos. Antes publicábamos “menos de un dólar y menos de 90 segundos”; era una estimación de cuando el producto era un MVP, y no la vamos a sostener sin medirla.
Lo que sí defendemos es la forma: un sistema donde cada incidente tiene un rastro en papel, donde el código decide qué se puede tocar, y donde el LLM es un componente sobre el que puedes razonar en vez de una caja negra en la que tienes que confiar.
Si quieres ver cómo encaja todo, está en Cómo funciona, y los niveles de autonomía, en la documentación de Kobi. Las reglas de la capa 1 son open source, Apache 2.0, por si prefieres leer el código; Autopilot forma parte de KubeBolt Cloud y de la edición Enterprise. La forma más confiable de correr autonomía en infraestructura es hacerla algo que puedas inspeccionar: así que la hicimos.