Conceptos
Motor de insights
24 reglas integradas con ciclo de vida: episodios duraderos con evidencia tipada, amortiguación de oscilaciones, un vigilante de caducidad, silencios de primera clase y una capa de políticas por regla.
En esta página
El motor de insights evalúa 24 reglas integradas contra cada clúster con el
que KubeBolt mantiene una conexión en vivo: el que estás viendo y los que se
mantienen conectados en segundo plano. Se ejecuta cada 60 segundos
(--insight-interval en el servidor) sobre la caché de informers y las
lecturas de Metrics Server, así que no necesita agente ni IA. Un clúster solo
de métricas (sin conexión en vivo a la API) no se evalúa. Cada hallazgo lleva
el recurso afectado, un mensaje que nombra lo que leyó la regla y una
sugerencia con pasos de remediación o comandos kubectl.
Desde la 2.1.0, un hallazgo ya no es una luz que está encendida o apagada. Tiene historia, dueño y política: los episodios registran lo que pasó, los silencios registran lo que decidiste tolerar y la matriz de reglas registra cuánto ruido puede hacer cada regla.
Las reglas destapan problemas; nunca arreglan nada. Una remediación solo ocurre cuando alguien ejecuta una acción: tú, Kobi con tu aprobación o Autopilot en KubeBolt Cloud.
Definición de las reglas
Cada tarjeta muestra el id de la regla, su severidad por defecto, qué la dispara, su clase (consulta la matriz de reglas) y, en las seis reglas que lo tienen, el umbral ajustable con su valor por defecto.
- crash-loop crítica
Un contenedor está en espera en CrashLoopBackOff con más de 3 reinicios. Indica si el kubelet lo está matando porque falla su liveness probe o si cada ejecución termina en OOMKilled.
- oom-killed crítica
La última terminación de un contenedor fue OOMKilled. Se cierra cuando la nueva ejecución se mantiene Ready durante 2 minutos, o más tiempo que el que pasó entre sus dos últimos OOMKill (24 h como máximo).
- zero-replicas crítica
Un Deployment que pide réplicas tiene 0 disponibles. Un primer rollout que sigue en curso no cuenta.
- node-not-ready crítica
La condición Ready de un nodo no es True.
- image-pull-backoff crítica
Un contenedor está en espera en ImagePullBackOff o ErrImagePull.
- progress-deadline-exceeded crítica
La condición Progressing de un Deployment es False con ProgressDeadlineExceeded. La sugerencia indica si un rollback puede ayudar.
- missing-config-dependency crítica
Un contenedor está atascado en CreateContainerConfigError: falta un ConfigMap, un Secret o una clave, hay un conflicto con runAsNonRoot o el kubelet agotó el tiempo de lectura.
- helm-release-failed crítica
La última revisión de una release de Helm está en estado failed.
- cpu-throttle-risk advertencia
El uso de CPU de un pod se mantiene por encima del 80% de su límite de CPU durante 2 minutos. Solo pods en los que todos los contenedores fijan un límite.
- memory-pressure advertencia
El uso de memoria de un pod se mantiene por encima del 85% de su propio límite durante 2 minutos (su título es Memory Near Limit: no es presión de memoria del nodo).
- hpa-maxed-out advertencia
Un HPA está en maxReplicas y quiere más (ScalingLimited: TooManyReplicas, o CPU por encima de su objetivo). Con un HPA fijado (min = max) no se dispara.
- pvc-pending advertencia
Un PVC está en Pending sin volumen enlazado ni en aprovisionamiento. Con un claim WaitForFirstConsumer que todavía no usa ningún pod, no se dispara.
- frequent-restarts advertencia
Un contenedor se ha reiniciado más de 5 veces y su ejecución actual todavía no se ha mantenido Ready durante 2 minutos.
- evicted-pods advertencia
Un pod fue desalojado en los últimos 30 minutos, por presión en el nodo o por superar su propio límite de ephemeral-storage.
- readiness-probe-failing advertencia
Un pod Running con readiness probe (o readiness gates) lleva más de 2 minutos sin estar Ready.
- liveness-probe-failing advertencia
El kubelet informa más de un fallo de la liveness probe en un pod que todavía existe.
- service-no-endpoints advertencia
Un Service con selector (ni headless ni ExternalName) no tiene endpoints listos.
- policy-no-match advertencia
El podSelector de una NetworkPolicy no selecciona ningún pod, y ningún workload de su namespace tiene pods con esas etiquetas.
- pdb-no-match advertencia
El selector de un PodDisruptionBudget no selecciona ningún pod, y ningún workload de su namespace tiene pods con esas etiquetas.
- helm-release-hook-pending advertencia
Una release de Helm lleva más de 5 minutos en un estado pending-*, normalmente por un hook que nunca terminó.
- cert-expiring advertencia
Un Certificate de cert-manager caduca en menos de 14 días. Si ya caducó, se dispara con severidad crítica.
- argocd-out-of-sync advertencia
Una Application de Argo CD está OutOfSync o Degraded.
- resource-underrequest info
El request de CPU o memoria de un pod se mantiene por debajo del 40% de lo que realmente usa durante 2 minutos.
- policy-orphan info
Un namespace tiene pods en ejecución y ninguna NetworkPolicy (ni CiliumNetworkPolicy). Los namespaces del sistema se omiten.
Las reglas que leen el uso (cpu-throttle-risk, memory-pressure,
resource-underrequest) necesitan Metrics Server y solo se disparan cuando la
condición se ha mantenido durante 2 minutos, así que una subida breve no abre
un episodio. Las reglas que leen CRDs (cert-expiring, argocd-out-of-sync)
no dicen nada en un clúster sin cert-manager o Argo CD, y las reglas de Helm
leen los Secrets de las releases que se describen en
Aplicaciones de Helm.
Cuando el pod es de un agente de KubeBolt, oom-killed y memory-pressure
(Memory Near Limit) sugieren el helm upgrade que sube su límite de memoria:
el doble del límite actual, como mínimo 256Mi, fijado a la versión del chart
que ejecuta el agente, con la clave de values propia del pod promread cuando
es ese pod. Consulta El agente.
Un insight se cierra cuando la regla observa la recuperación, no cuando se
acaba un temporizador: un contenedor en crash loop o terminado por OOM se
cierra cuando su nueva ejecución lleva el tiempo suficiente Ready, y un PVC
pendiente cuando se enlaza. Los relojes solo aparecen donde no hay estado en
vivo que leer: evicted-pods informa de los desalojos de los últimos 30
minutos, y una liveness probe que se recuperó sin reinicio se cierra tras un
silencio calculado a partir del periodo de la propia probe.
Dónde aparecen los insights
- Insights (fijado en la barra lateral del clúster) tiene tres pestañas: Active, History y Bursts, con un filtro Critical / Warning / Info. Cada tarjeta lleva Ask Kobi (cuando Kobi está configurado) y View episode →, más Silence para los editores y Adjust rule para los administradores.
- Las tarjetas Insights y Cluster health de Overview, y los veredictos por clúster de Home y Fleet.
- Notificaciones, cuando se abre un episodio realmente nuevo o se resuelve uno.
- Las herramientas
get_insights,get_insight_episodesyget_insight_episodede Kobi, que también sirve el servidor MCP de solo lectura.
Episodios
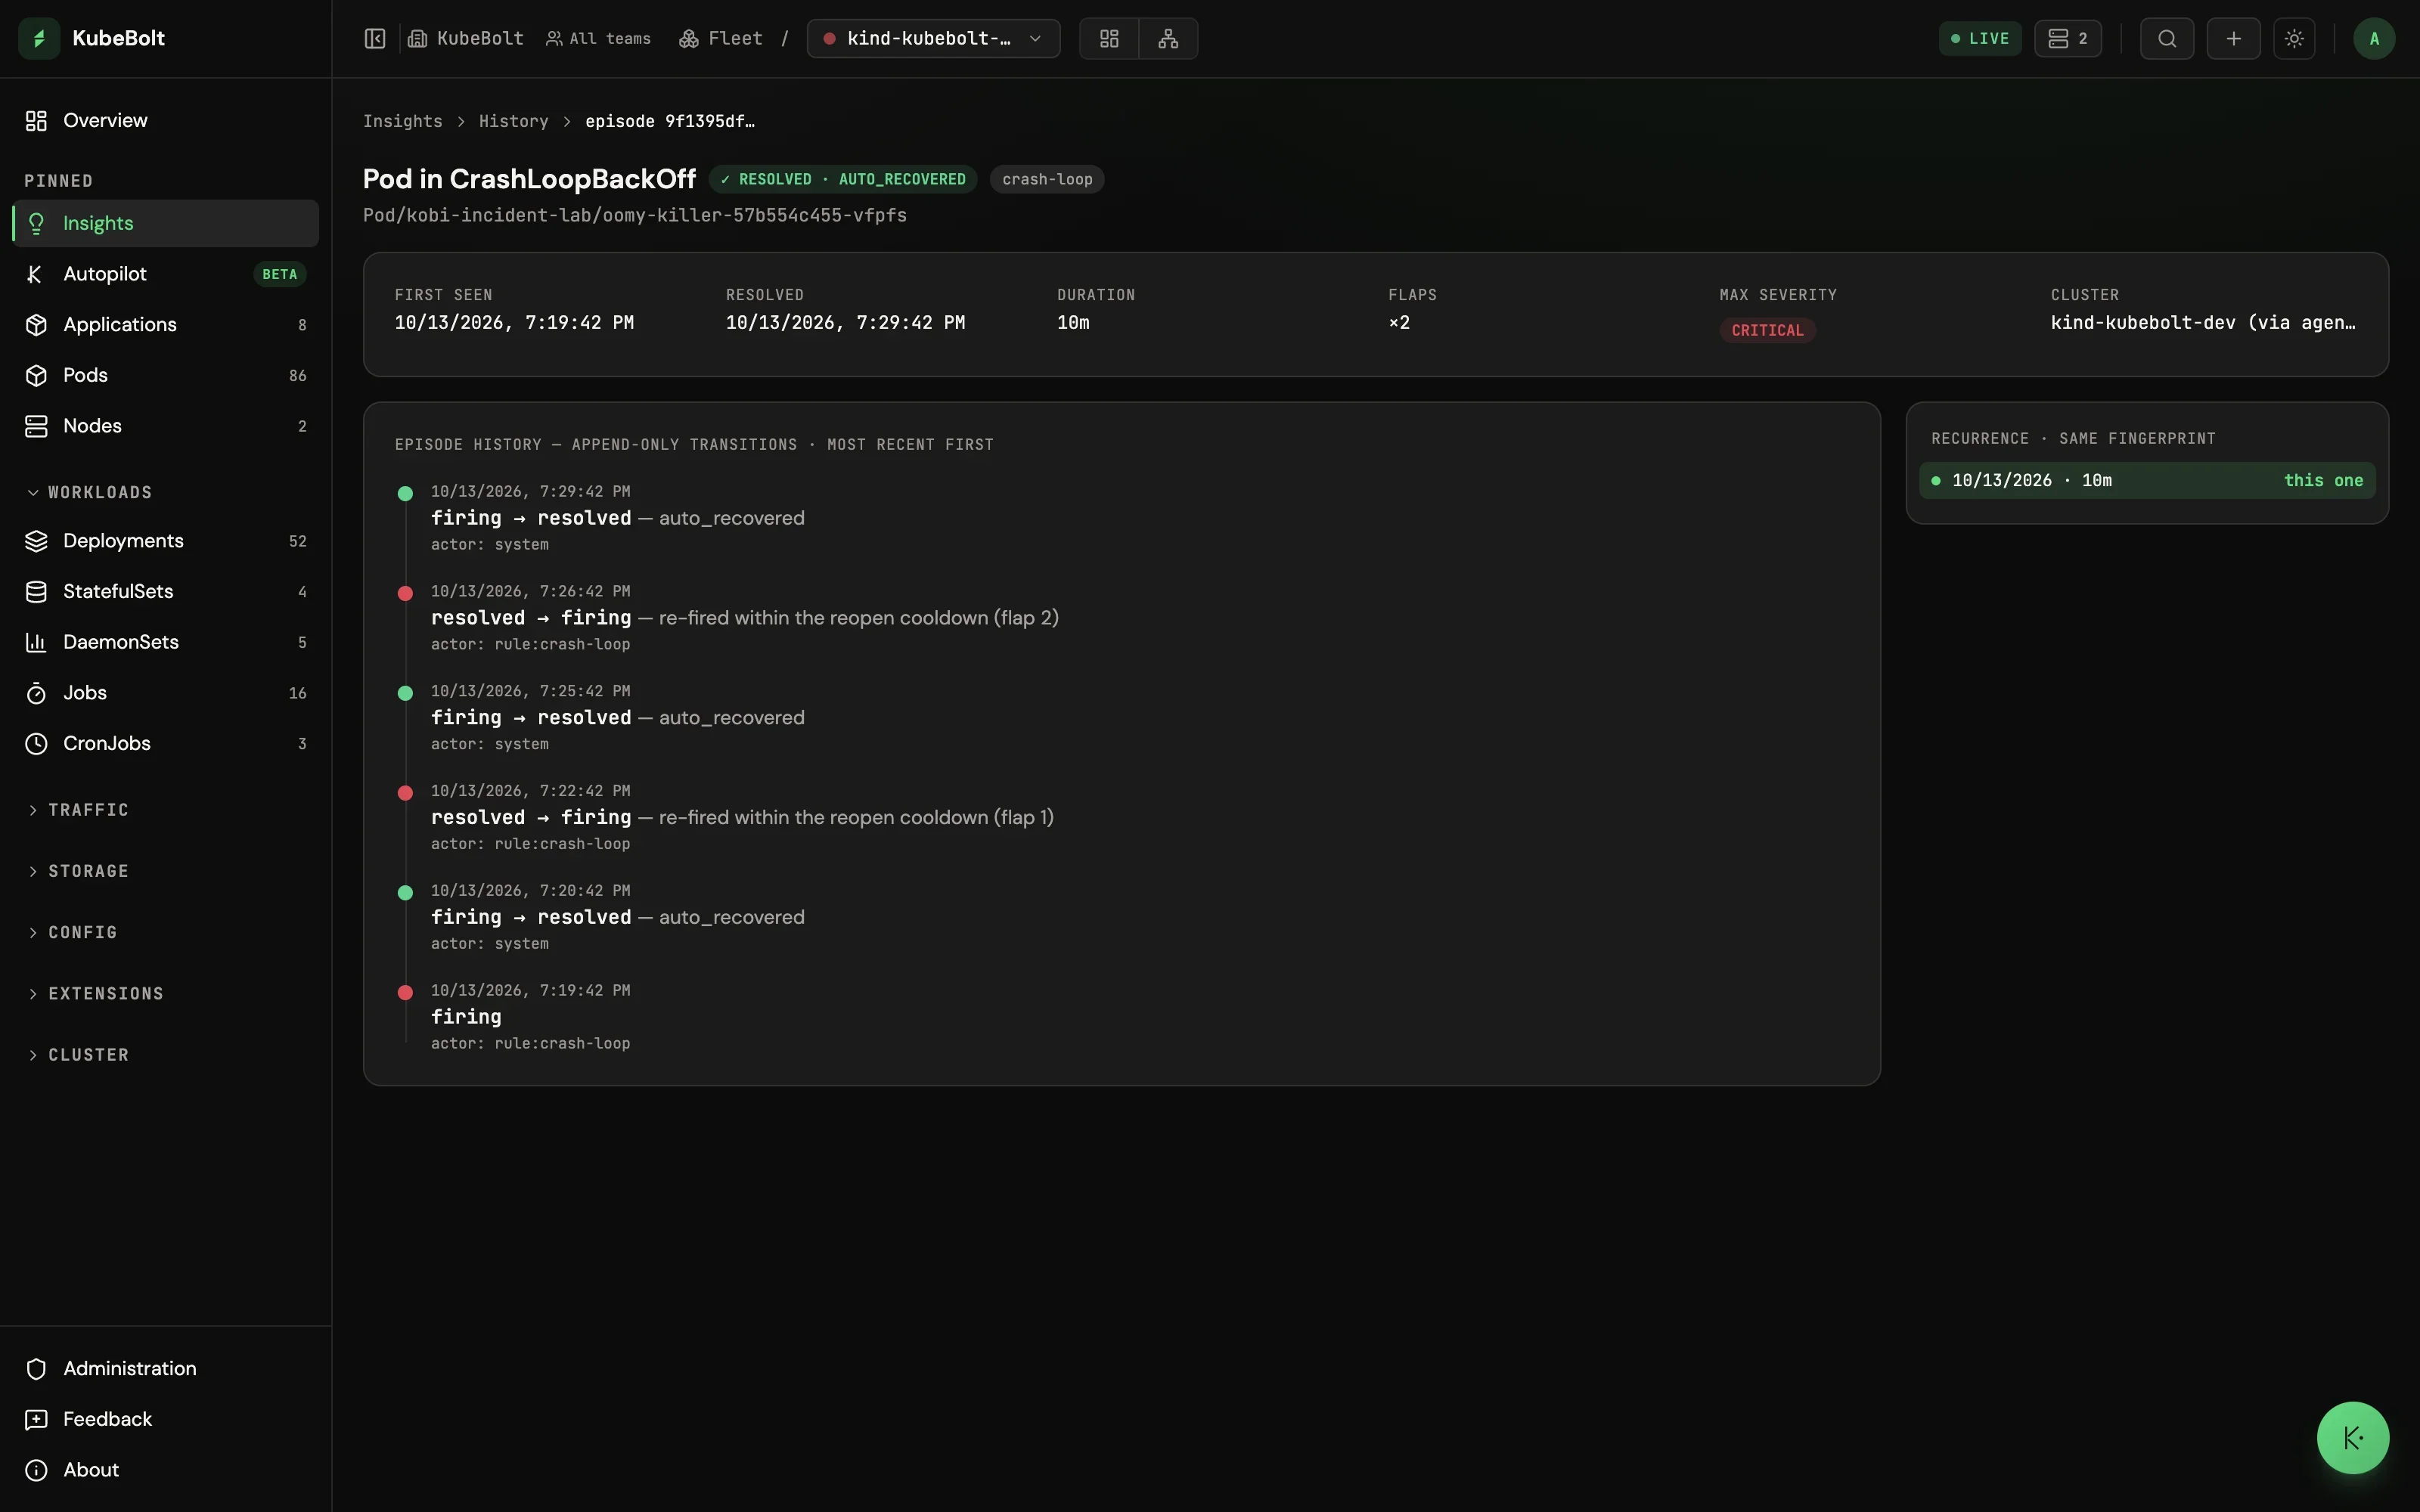
Cada insight que se dispara abre un episodio: una fila duradera
identificada por la huella (clúster, regla y recurso), con una línea de tiempo
de transiciones en la que solo se añaden entradas: abierto, oscilación, cambio
de severidad, silenciado, reactivado, resuelto, caducado. Cada transición
registra quién la causó (system, rule:<id>, watchdog, user:<id>) y por
qué.
Evidencia tipada. Una regla registra lo que realmente vio al dispararse:
los números y los objetos que hay detrás del veredicto, no una relectura del
clúster minutos después. El episodio la conserva, así que la recomendación se
puede contrastar con el estado que la produjo incluso cuando el clúster ya ha
cambiado. Kobi lee esa misma evidencia con get_insight_episode.
Amortiguación de oscilaciones. Una huella que se vuelve a disparar menos de 10 minutos después de resolverse es el mismo episodio oscilando: el contador de oscilaciones sube, no se crea un episodio nuevo y no se envía una segunda notificación. Fuera de esa ventana es un episodio realmente nuevo.
El vigilante de caducidad. Un episodio activo cuyo clúster dejó de
informar ya no es verificable: el agente se fue, el clúster se eliminó. Tras
15 minutos sin señal (KUBEBOLT_INSIGHT_EXPIRE_TTL), el vigilante, que
hace una pasada cada minuto, lo pasa a expired y sale de la lista Active.
expired no es resolved: nadie observó la recuperación, y la distinción se
conserva en la línea de tiempo. Si la misma condición vuelve más tarde, el
nuevo episodio enlaza con el caducado.
Las resoluciones son tipadas, así que el historial se lee como un relato y
no como un recuento: auto_recovered, remediated (una acción ejecutada lo
cerró, con el id de la acción adjunto), manual y rule_changed (lo cerró un
cambio de política).
Active, History y Bursts. Active lista lo que se está disparando ahora mismo; un episodio resuelto o caducado pasa a History. History mira 24 horas, 7 días o 30 días atrás, filtra por estado (firing, resolved, expired) y por severidad, y cambia entre This cluster y All clusters. Cada episodio abre una página de detalle con su evidencia, su línea de tiempo completa y su recurrencia: cuántas veces ha vuelto exactamente esa huella.
Bursts agrupa lo que se rompió a la vez por una causa común, así que 48
desalojos de una sola rotación de nodos se leen como un evento y no como 48.
Responde a «¿qué pasó a las 3 de la madrugada del miércoles pasado?»: elige
24h, 7d o 30d, o un solo día con On a day, y la ventana queda en la
URL para poder enlazar la vista. La pestaña muestra el clúster que tienes
abierto; This cluster / All clusters la amplía a la flota. See the N
episodes en una ráfaga abre exactamente los episodios de esa ráfaga, así que
el número del enlace coincide con la lista. Cómo se forman las ráfagas se
explica en el informe del turno.
History responde por los clústeres muertos. Un episodio conserva el nombre visible del clúster que quedó guardado, así que un post-mortem sobre un clúster que ya eliminaste se sigue leyendo con nombres y no con UUIDs, que es precisamente cuando llega la pregunta.
La retención va en la pasada de mantenimiento de cada hora. En la edición open
source, los episodios resueltos y caducados y sus líneas de tiempo se
conservan durante KUBEBOLT_FINDINGS_RETENTION_HORIZON (30 días por defecto),
y el registro de insight de cada huella durante
KUBEBOLT_INSIGHTS_RETENTION_HORIZON (7 días). Los episodios activos nunca se
podan. En KubeBolt Cloud, la ventana depende de tu plan.
Silencios
Un silencio acalla una regla en un recurso de un clúster. Es una capa de presentación, no una supresión: el motor sigue evaluando y los episodios siguen registrándose; solo se ahorra tu atención.
- Silence en una tarjeta de insight ofrece For 7 days, For 30 days, Until it resolves y Permanently…. Un silencio permanente exige un motivo escrito, para que quien lo encuentre dentro de seis meses sepa por qué existe. Un silencio «until it resolves» se consume cuando el episodio se resuelve; uno vencido se borra un día después de su fecha.
- Los silencios restan en todos los sitios donde se cuentan insights: las
tarjetas de Overview, la puntuación de salud del clúster, los veredictos de
Home y Fleet, el informe del turno y la API. La pestaña Active los cuenta
(N muted) y puede mostrarlos en su sitio; la API los devuelve con
includeMuted=true. - La severidad crítica atraviesa un silencio. Una escalada pasa, y por eso el motor nunca consulta la lista de silencios: para atravesarlos necesita la señal subyacente intacta.
- Cada silencio y cada reactivación quedan en la línea de tiempo del episodio y en el registro de auditoría, con el nombre del actor y el motivo.
- Leer la lista no requiere ningún rol en particular; crear o levantar un silencio requiere Editor.
- Administration → Insights → Silenced lista los silencios de la organización con los nombres de los clústeres, no UUIDs, junto a las reglas desactivadas por política.
Volver a silenciar la misma clave (cluster, rule, resource) actualiza las
condiciones en lugar de apilar duplicados.
El informe del turno
El saludo de Home te cuenta lo que pasó mientras no estabas (consulta Home y Fleet para ver cómo se lee). La ventana cuelga de tu propio ancla de presencia: la última vez que la página Home se mostró de verdad para ti, no tu último inicio de sesión, que la renovación del token congelaría. Tu primer turno usa por defecto una ventana de 24 horas; un ancla de más de 30 días se recorta, y el informe lo dice.
Informa de eventos, no de estado en pie: qué se abrió, qué se recuperó solo, qué se remedió, qué caducó, cuántos de los episodios recién abiertos siguen ardiendo y cuántos eran críticos. Una condición que simplemente abarca tu ausencia pertenece a la lista Active, no a este informe, así que el informe se queda en silencio cuando de verdad no pasó nada.
Las ráfagas se agrupan de forma determinista, sin IA de por medio: la misma ventana de entrada produce la misma agrupación de salida. Solo participan las reglas de fallo (una expectativa es estado en pie, no un evento). Los episodios cuyas horas de inicio caen a menos de 5 minutos unas de otras se encadenan en una ráfaga, y una ráfaga necesita al menos 5 episodios; con menos, se quedan como hallazgos sueltos. Después, cada ráfaga se clasifica en este orden:
| Tipo | Se muestra como | Lo origina |
|---|---|---|
node_rotation | Node rotation | node-not-ready |
node_pressure | Node pressure | evicted-pods (no un desalojo por el propio límite de almacenamiento del pod) |
mass_rollout | Mass rollout | Reglas de rollout (progress-deadline-exceeded, image-pull-backoff, readiness-probe-failing, crash-loop) en al menos 5 workloads distintos |
unknown_burst | Unattributed | Nada reconocible: un «no lo sabemos» honesto |
El radio de impacto es aritmética simple sobre los miembros: recursos afectados, recuperados solos, remediados, todavía activos, caducados y el episodio más largo. El episodio más largo de la ventana se nombra y se enlaza, y los contadores de supresión (hallazgos silenciados mientras no estabas, reglas desactivadas por política) son parte de la historia.
La matriz de reglas
Las reglas se dividen en dos clases, y la clase decide qué control tienes:
| Clase | Número | Qué puedes cambiar |
|---|---|---|
| Malfunction (fallo) | 15 | Solo el umbral numérico, y solo en las reglas que lo tienen. La severidad está bloqueada y la regla nunca se puede desactivar: lo que está roto está roto en cualquier parte. Para acallar del todo un recurso, la única vía es un silencio. |
| Expectation (expectativa) | 9 | La severidad es el control, off incluido. En un clúster de desarrollo se incumplen a propósito. |
Seis reglas tienen un umbral numérico: crash-loop y frequent-restarts
(reinicios), resource-underrequest (relación request/uso),
cpu-throttle-risk y memory-pressure (relación uso/límite) y
cert-expiring (días antes de que caduque). Mover el umbral mantiene la regla
fiel a lo que dice su nombre; las otras dieciocho son booleanas y no tienen
control.
Administration → Insights → Rules (Admin) lista las 24 agrupadas por
clase, con una descripción de una frase, sus controles y la columna de
honestidad Ignored 30d: episodios de esa regla cerrados en los últimos 30
días sin un acuse de recibo, una acción ni un silencio. Una regla que has
desactivado se sigue evaluando y contando: la pestaña Active muestra un
aviso con cuántos hallazgos está ocultando tu política, y Silenced lista la
regla en Off by policy con un botón Turn back on. Desactivar una regla
resuelve sus episodios abiertos como rule_changed, nunca como una
recuperación. Un cambio se aplica en la siguiente evaluación.
La capa de ajustes global (un ajuste por regla, para todos los clústeres) viene en la distribución open source. Añadir una segunda capa de ajustes por categoría de entorno (production, staging, testing, development) necesita la clasificación de clústeres y es una función de KubeBolt Cloud, en la pestaña Environment tuning; allí, el valor efectivo se resuelve control a control como ajuste del entorno → ajuste global → valor por defecto de fábrica.
Endpoints
Todos bajo /api/v1. Solo GET /insights necesita un clúster conectado; el
resto responde desde el estado almacenado, porque el historial tiene que
responder por clústeres que ya no existen.
| Método | Endpoint | Descripción |
|---|---|---|
| GET | /insights | Insights activos del clúster actual (severity, includeMuted), con hiddenByProfile y profile |
| GET | /insights/summary | Estado por clúster para la flota, servido sin un conector en vivo |
| GET | /insights/episodes | Historial de episodios: status, severity, rule, cluster, since, until, limit, page |
| GET | /insights/episodes/{id} | Un episodio con su evidencia, sus transiciones y su recurrencia |
| GET | /insights/operational-episodes | Las ráfagas deterministas de una ventana (since, until; 24 horas por defecto, 31 días como máximo) |
| GET | /insights/operational-episodes/{id}/episodes | Los episodios de una ráfaga |
| GET | /insights/shift-report | «While you were away», limitado a tu ancla de presencia |
| POST | /account/dashboard-seen | La señal de presencia que envía Home después de mostrarse |
| GET · POST | /insights/mutes | Listar (cualquier rol) y crear (Editor, auditado) |
| DELETE | /insights/mutes/{id} | Levantar un silencio (Editor, auditado) |
| GET · PUT · DELETE | /admin/insight-policies[/{rule}] | La capa de políticas de reglas (Admin, auditado) |
Configuración
| Variable | Valor por defecto | Para qué sirve |
|---|---|---|
KUBEBOLT_INSIGHT_EXPIRE_TTL | 15m | Un episodio activo que pasa más de este tiempo sin señal pasa a expired |
KUBEBOLT_INSIGHTS_RETENTION_HORIZON | 168h (7 días) | Cuánto tiempo se conserva el registro de insight resuelto o caducado de cada huella |
KUBEBOLT_FINDINGS_RETENTION_HORIZON | 720h (30 días) | También limita los episodios resueltos y caducados y sus líneas de tiempo (edición open source) |
El intervalo de evaluación es el flag del servidor --insight-interval (en
segundos, 60 por defecto). La lista completa de variables está en
Variables de entorno. Las notificaciones de
insights se configuran aparte: consulta Notificaciones.