Conceptos
Costos y rightsizing (Beta)
Gasto en la nube por clúster con OpenCost: ritmo de gasto (run-rate), costo ocioso y recomendaciones de rightsizing con su precio en dinero. Cómo se calcula cada número, las tres formas de conectar OpenCost y cómo verificarlo.
En esta página
Cuando un clúster envía datos de OpenCost, aparece en su panel una subpestaña Cost (marcada como Beta), y las cifras de gasto de Home y Fleet empiezan a contarlo. No hay ningún servicio de backend nuevo que operar: la pestaña es una lente sobre familias de métricas de costo que el agente envía al almacén de métricas de KubeBolt, acotadas por clúster como todo lo demás. KubeBolt no llama a la API de OpenCost: OpenCost es un exportador de Prometheus, y sus métricas recorren el mismo camino que el resto.
La pestaña solo aparece en un clúster cuyas muestras de costo han llegado a
KubeBolt (comprueba node_total_hourly_cost una vez por minuto). Un clúster
sin datos de costo no recibe una pestaña vacía.
Qué muestra la pestaña Cost
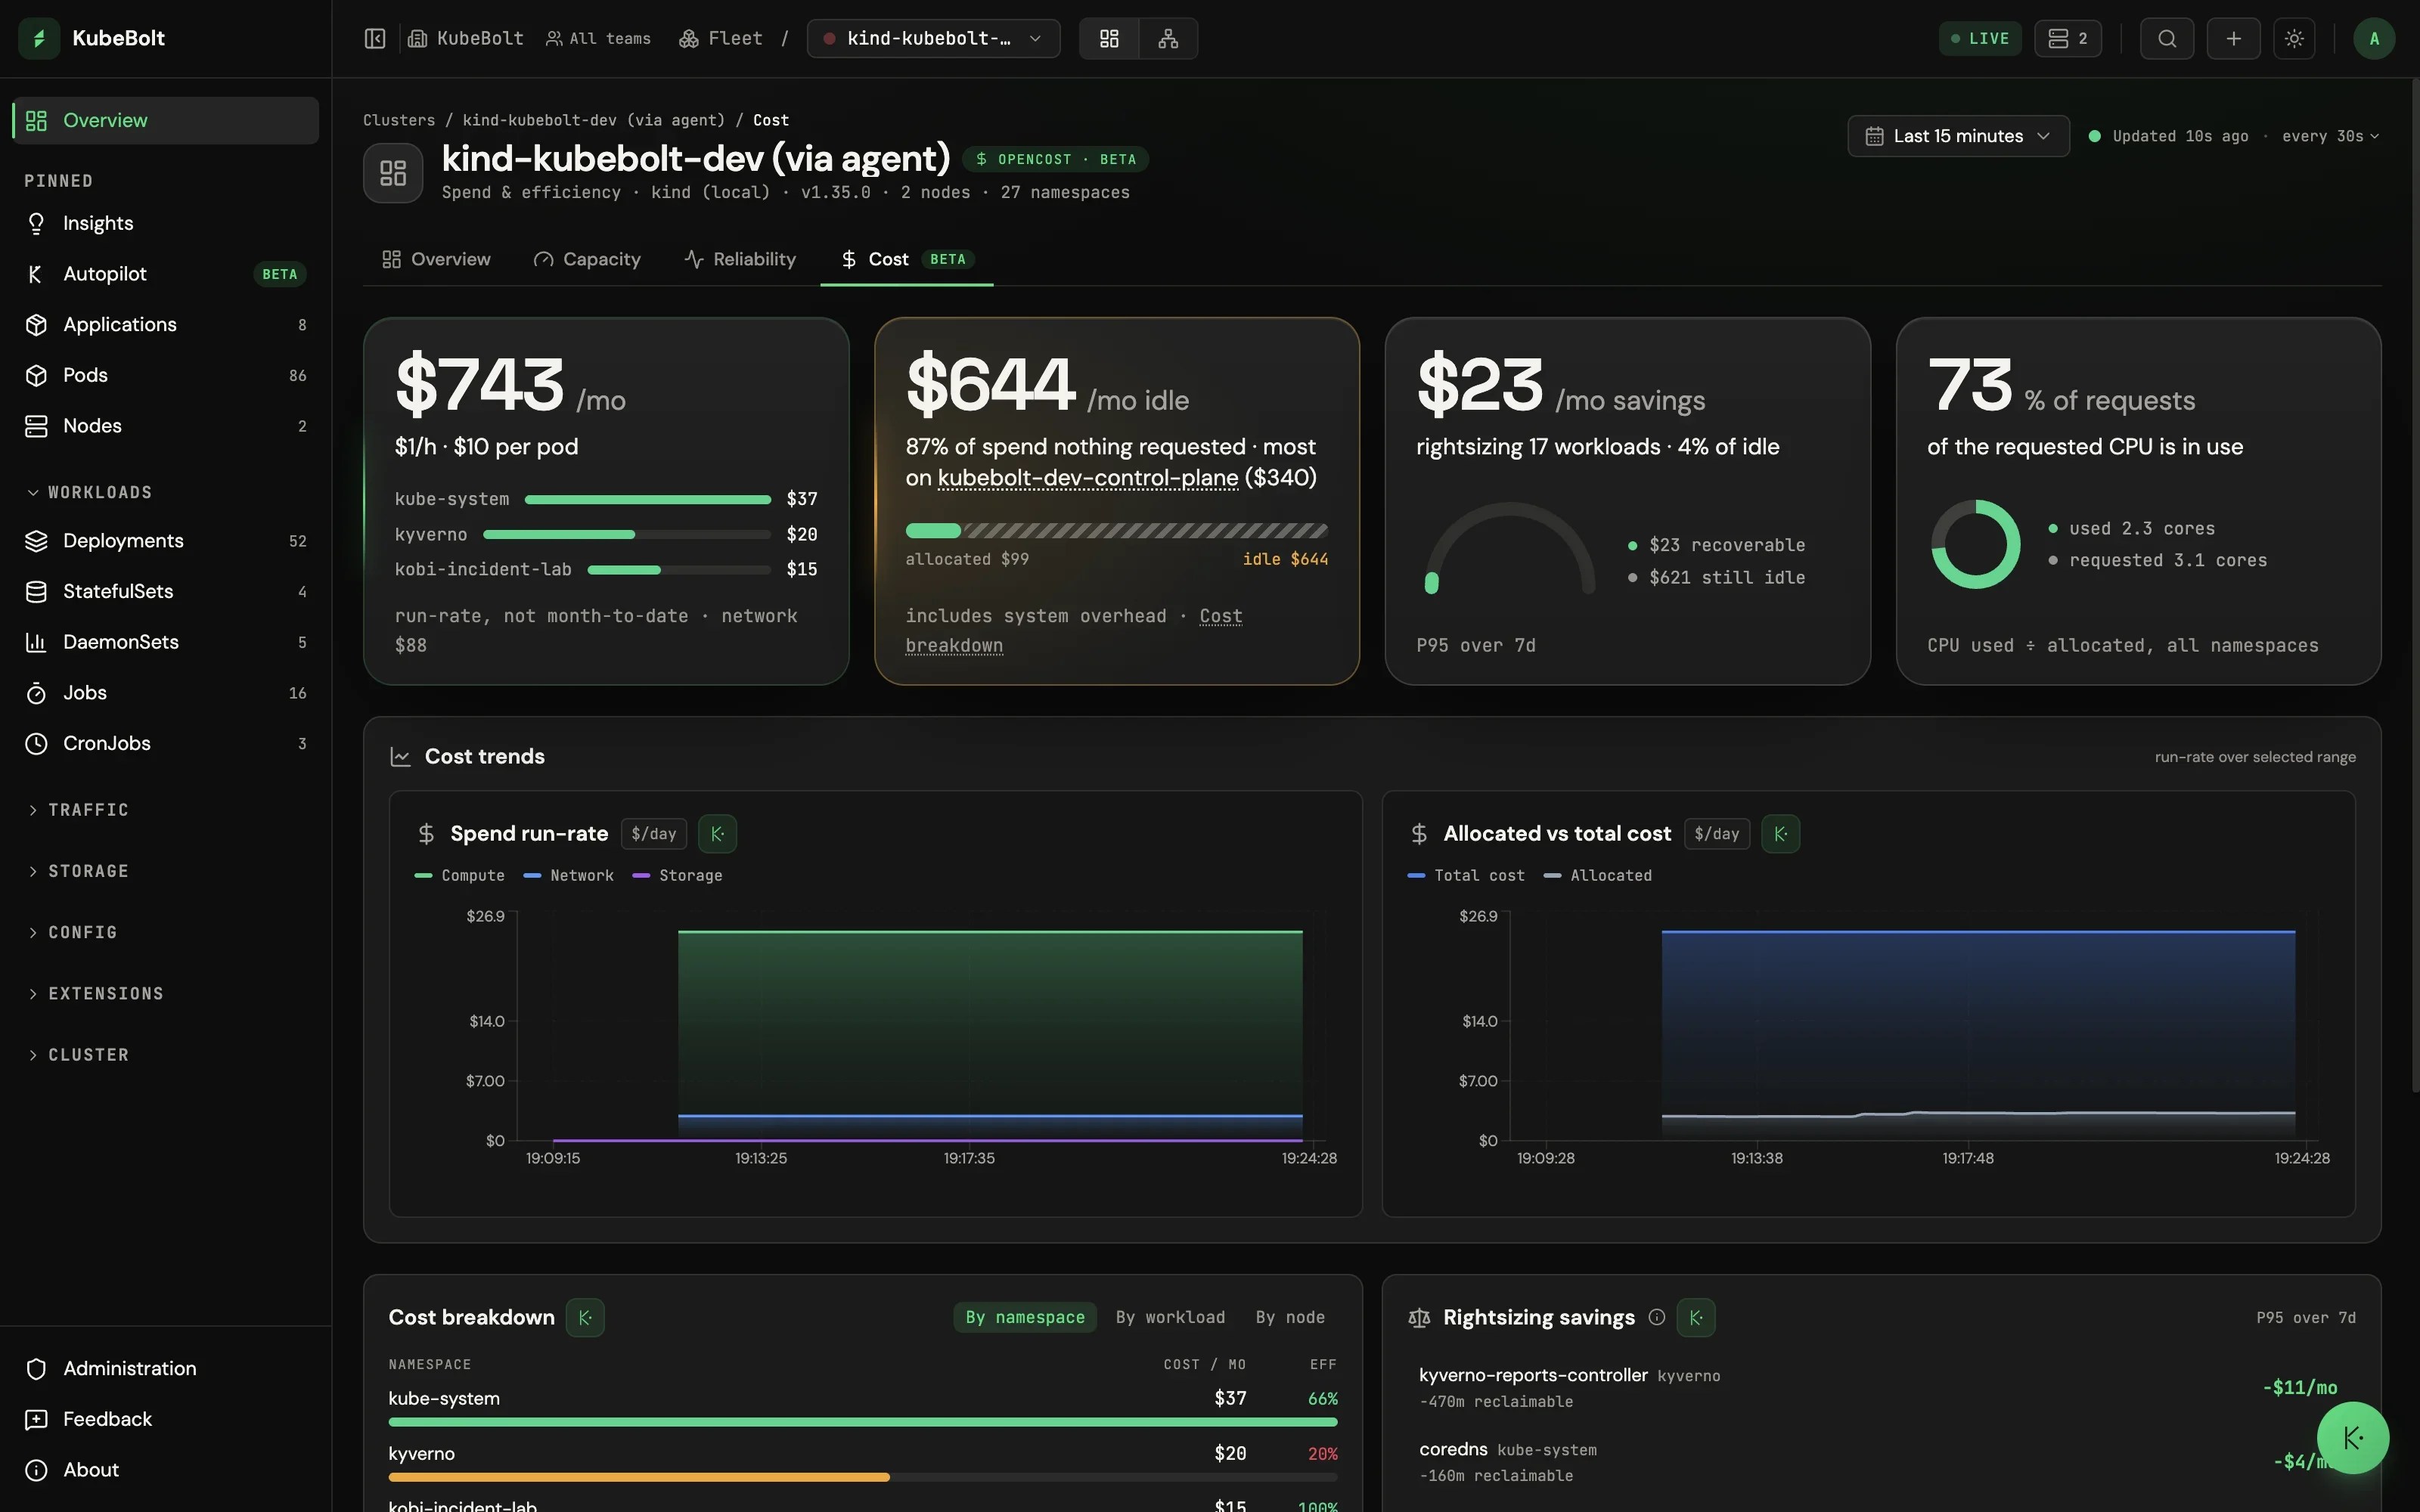
- Fila de tarjetas. Cuatro tarjetas: el ritmo de gasto mensual (con la tarifa por hora y el costo por pod en su frase, y los tres namespaces que más gastan), el costo ocioso (lo que pagas por capacidad que ningún workload pidió), el ahorro mensual que recuperarían las recomendaciones de rightsizing y la eficiencia (cuánta de la CPU que pediste está en uso). El costo ocioso se pone en ámbar cuando el 60 % o más del gasto está ocioso, y nombra el nodo donde se concentra la mayor parte.
- Tendencias de costo. En el rango seleccionado, en $/día: el ritmo de gasto dividido en cómputo, red y almacenamiento, y lo asignado frente al costo total (la diferencia entre ambos es lo ocioso).
- Desglose. Costo por namespace (con la eficiencia de CPU de cada namespace), por workload y por nodo (con los nodos spot marcados), así que «¿quién está gastando esto?» queda a dos clics.
- Recomendaciones de rightsizing, en dinero. Las recomendaciones de sobreaprovisionamiento del mismo motor que la pestaña Capacity, cada una con su precio en $/mes y ordenadas por lo que ahorran. Las recomendaciones de cerca del límite y sin especificaciones no devuelven dinero, así que se quedan en Capacity. Cada fila enlaza al workload; desde aquí no se aplica nada.
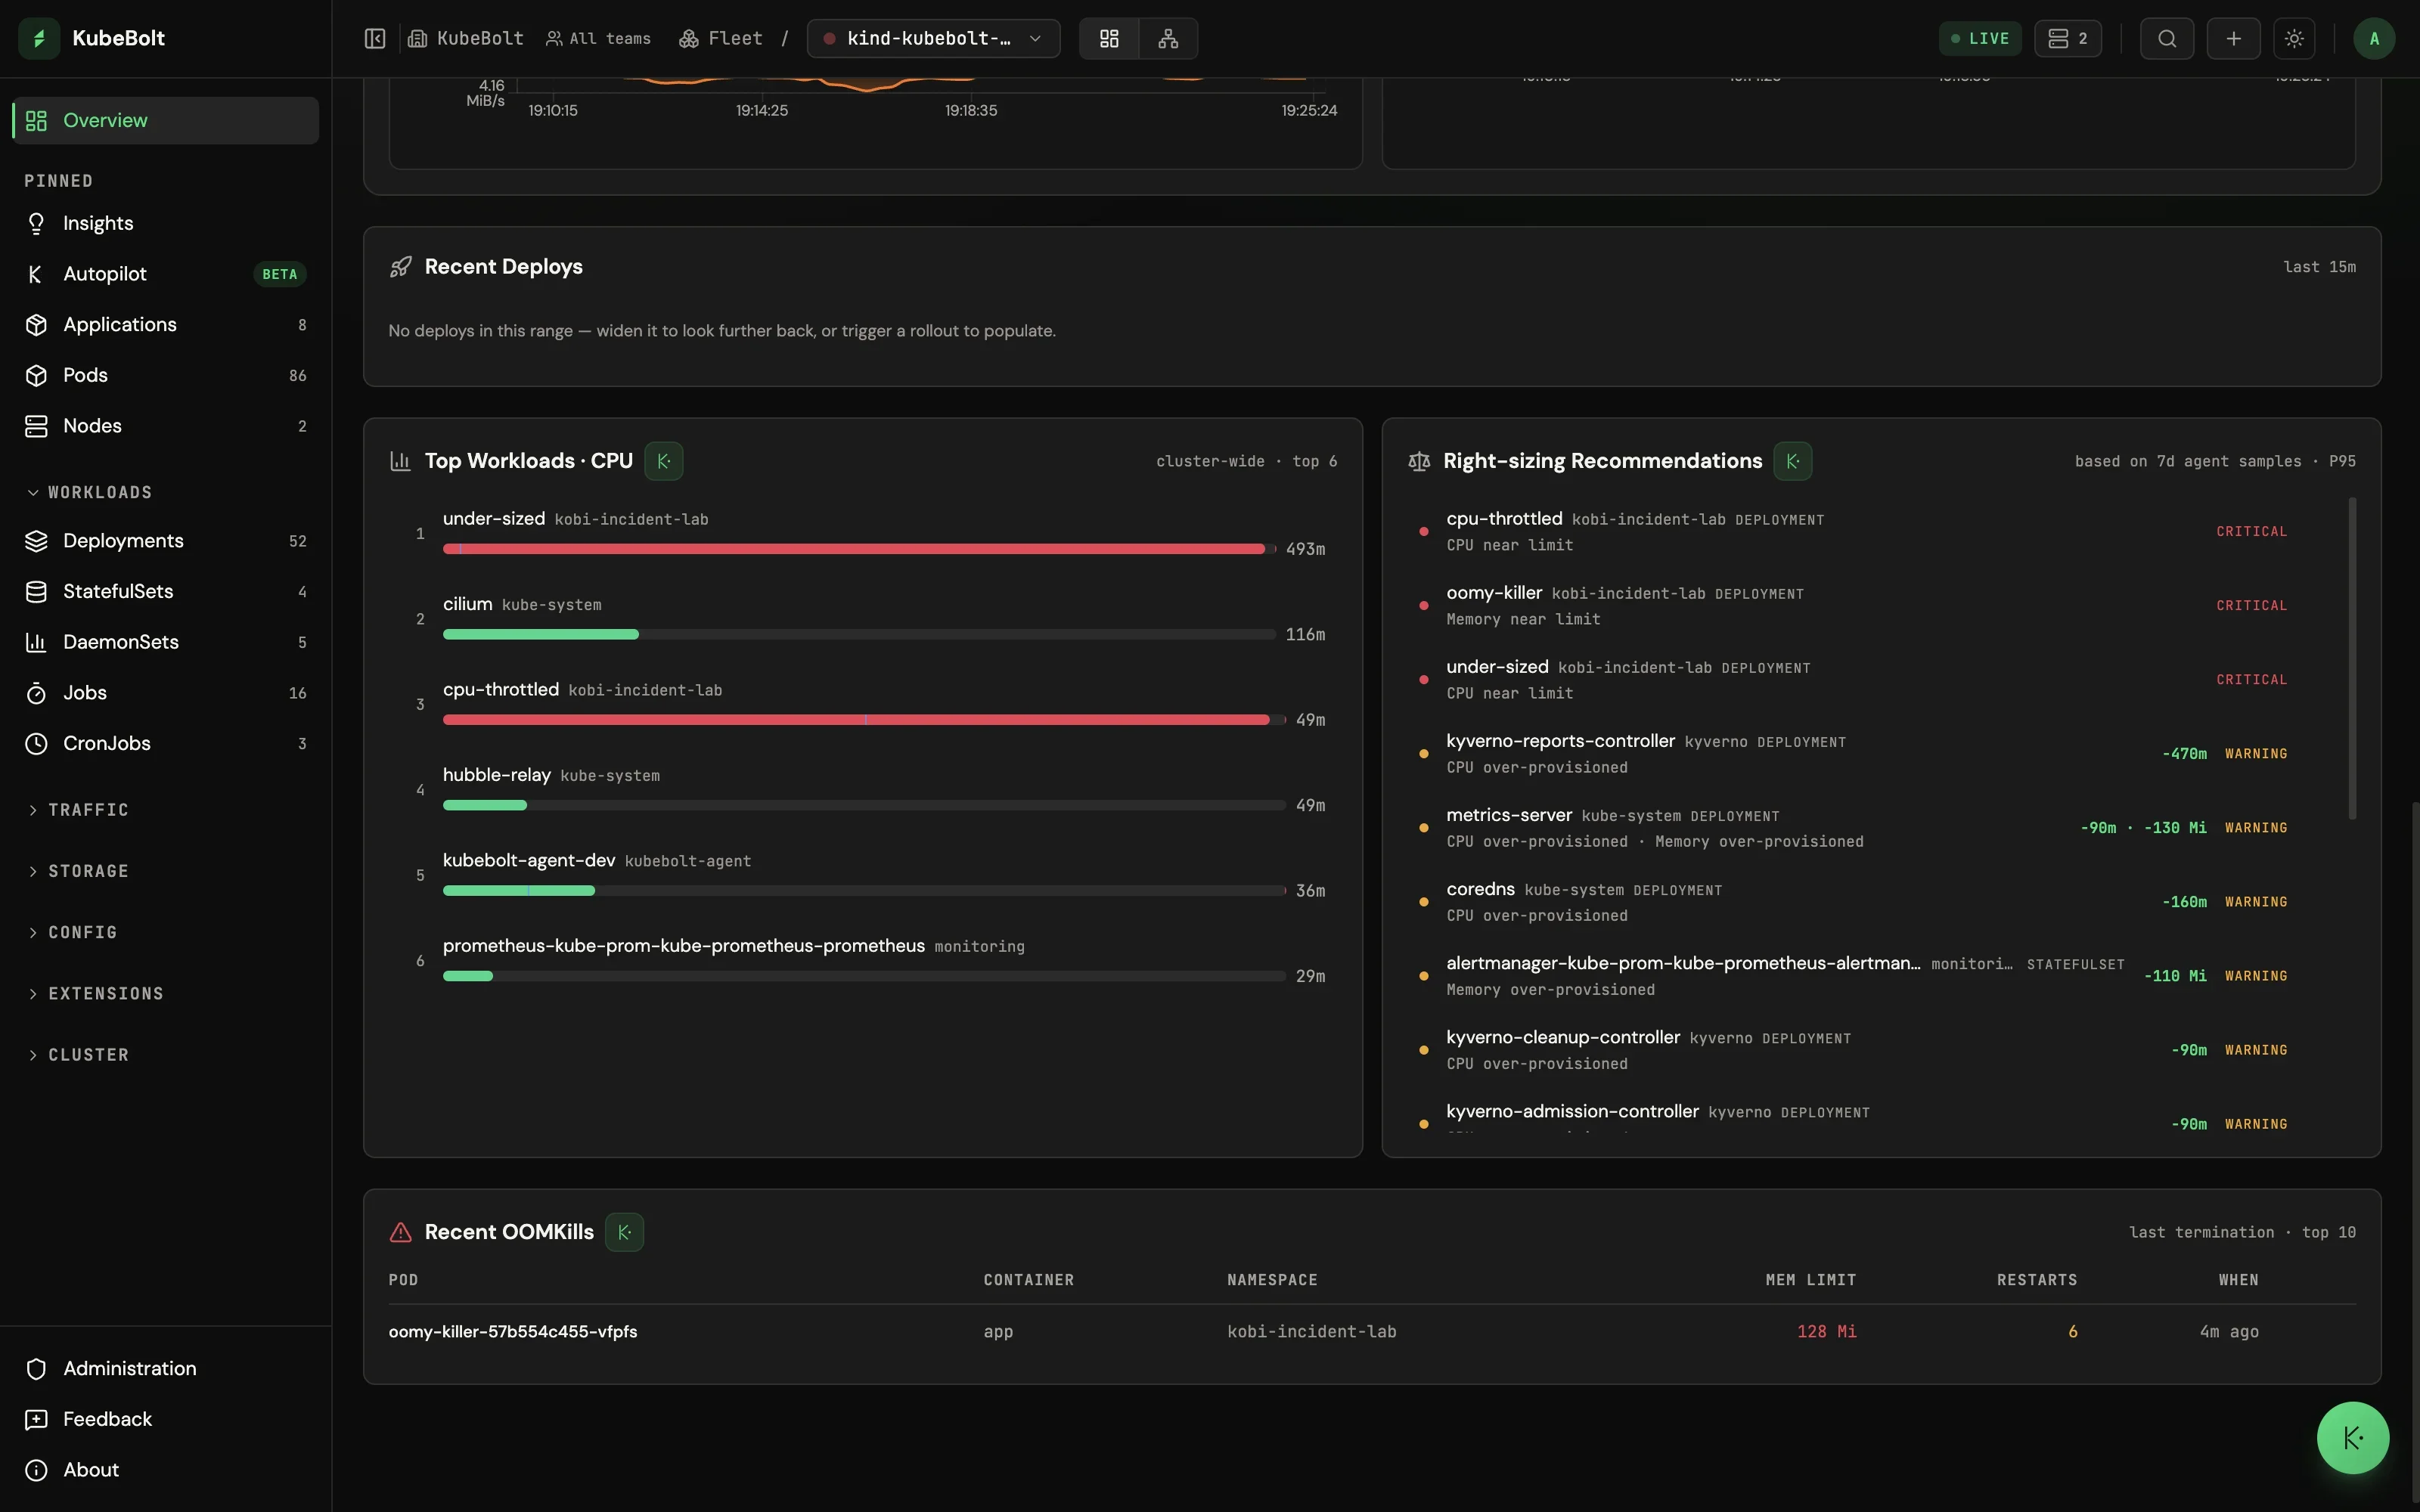
Kobi lee el mismo motor a través de get_right_sizing, así que preguntarle en
el chat y mirar la pantalla Capacity o Cost dan los mismos números. Las
recomendaciones no se recalculan para la conversación.
Cómo se calculan los números
Cada cifra es una consulta sobre las métricas de OpenCost del clúster seleccionado.
| Cifra | Cálculo |
|---|---|
| Ritmo de gasto mensual | sum(node_total_hourly_cost) × 730: el costo por hora actual proyectado a un mes, no lo acumulado en el mes |
| Asignado | La asignación de CPU de cada contenedor (container_cpu_allocation) × el node_cpu_hourly_cost de su nodo, más su asignación de memoria en GiB (container_memory_allocation_bytes) × el node_ram_hourly_cost del nodo |
| Ocioso | Ritmo de gasto menos lo asignado. Incluye la sobrecarga del sistema en los nodos y el margen que mantienes a propósito, así que no todo es recuperable |
| Red | Familias de costo de balanceadores de carga y de egress (kubecost_load_balancer_cost, kubecost_network_*_egress_cost), mostradas aparte del cómputo |
| Almacenamiento | pv_hourly_cost; $0 donde OpenCost no tiene precio de disco |
| Ahorro por rightsizing | Núcleos recuperables × la tarifa media por hora de CPU del clúster, más GiB recuperables × la tarifa media de RAM, × 730 |
| Eficiencia | CPU en uso ÷ CPU solicitada, en todos los namespaces |
Los precios son los precios de lista que OpenCost resuelve para tu proveedor y región, no tu factura: los descuentos por uso comprometido, las reservas y las tarifas negociadas no están incluidos. Cuenta con una diferencia constante respecto a la facturación; el valor está en la imagen relativa. En on-prem, bare metal y kind no hay lista de precios que detectar, y todo marca $0 hasta que le das a OpenCost una lista personalizada.
Cómo decide el rightsizing
El rightsizing son tres reglas fijas, no un modelo, así que los mismos datos siempre dan la misma respuesta. Se aplican a CPU y memoria por separado, sobre el P95 de los últimos 7 días de cada Deployment (con sus ReplicaSets agregados), StatefulSet o DaemonSet, muestreado con resolución de 5 minutos:
| Estado | Cuándo salta | Qué sugiere | Severidad |
|---|---|---|---|
| Cerca del límite | El P95 alcanza el 80 % del límite y queda a menos de 50m de CPU o 100Mi de memoria de él | Un límite de P95 × 1.5 | critical |
| Sobreaprovisionado | El P95 está por debajo de la mitad del request, y la diferencia supera 50m de CPU o 100Mi de memoria | Un request de P95 × 1.2 | warning |
| Sin especificaciones | Ni request ni límite, y el P95 está por encima de 50m de CPU o 100Mi de memoria | Definirlos | info |
Los umbrales absolutos mantienen en silencio a los controladores casi ociosos, donde un porcentaje no significa nada. Las sugerencias se redondean a 10m y 10Mi. El resultado se recalcula como mucho cada 5 minutos por clúster; todas las pantallas y Kobi leen la misma respuesta.
El P95 deja fuera el 5 % más cargado de la semana, unas 8 horas, así que una
subida breve no lo mueve. Úsalo para los requests. Para un límite de memoria,
mira también el max en la pestaña Monitor del workload
(Gráficas de Monitor en rangos largos).
Cuándo aparecen las recomendaciones
El rightsizing espera a tener 2 días de historial de uso por defecto. Por debajo de eso, el P95 no ha visto dos máximos diarios y un tramo tranquilo se lee como el estado estable, así que no hay ninguna recomendación:
- La tarjeta Rightsizing opportunity de Capacity y la tarjeta de ahorro de
Cost muestran un guion,
collecting samples — needs 2 days, y cuánto historial hay hasta ahora, p. ej.14h of 2 days collected. - Las listas de recomendaciones dicen
Collecting samples — right-sizing needs 2 days of usage history. get_right_sizingde Kobi dice que todavía está recopilando datos y no sugiere ningún cambio de tamaño.
A partir de ahí, las recomendaciones se calculan sobre el historial que haya;
el pie de la tarjeta de Capacity dice cuánto (P95 over 2d). Desde los 7 días,
el P95 cubre la semana completa.
En autoalojado, un admin puede cambiar el mínimo en Administration → System → General → Right-sizing → Minimum usage history: de 12 a 168 horas, aplicado a todos los clústeres y a Kobi sin reiniciar. Bájalo para una prueba, de modo que un clúster nuevo muestre recomendaciones el primer día; por debajo de 48 horas se marcan como una estimación temprana. En Cloud el mínimo lo fijamos nosotros; no es un ajuste de la organización.
Tres casos que conviene conocer:
- Un workload que nunca se ha muestreado no recibe recomendación, aunque el resto del clúster ya tenga historial. Un clúster sin el agente de métricas nunca recibe ninguna.
- Un workload que de verdad no usa nada sigue apareciendo como sobreaprovisionado: un cero medido es un dato.
- Si el almacén de métricas no responde, las tarjetas dicen
couldn’t read usage history — tries again in 5 minen lugar de afirmar que el clúster está bien dimensionado.
Requisitos
- El agente de KubeBolt, chart 1.3.0 o más reciente (la obtención de datos de OpenCost llegó en esa línea). El agente es el que envía las muestras de costo, en los tres modos, y el rightsizing lee las muestras de uso que envía. El agente 1.4.10 envía todas las familias de costo por todos los caminos, con las etiquetas correctas: consulta Qué envía cada camino.
- Métricas de OpenCost que lleguen a KubeBolt mediante uno de los tres modos de abajo.
Tres formas de conectar OpenCost
Elige una en Cost monitoring (OpenCost) del asistente Add cluster:
genera los valores finales de Helm. Los flags de abajo van en el
helm upgrade del agente; en una release existente, añade
--reset-then-reuse-values para conservar su URL de backend, la autenticación
y los ajustes del clúster. Consulta
Conectar clústeres.
1. Install OpenCost for me (incluido): el chart del agente instala el
sub-chart oficial de OpenCost y hace scraping de él en
http://<release>-opencost.<namespace>.svc:9003/metrics sin ningún otro
ajuste. Es el camino más sencillo si hoy no ejecutas OpenCost. OpenCost, a su
vez, lee el uso desde un Prometheus para atribuir el costo a los workloads, así
que apunta el sub-chart al tuyo: el asistente pide la URL y rellena estos
valores:
--set opencost.enabled=true \
--set opencost.opencost.prometheus.internal.serviceName=<prometheus-service> \
--set opencost.opencost.prometheus.internal.namespaceName=<prometheus-namespace> \
--set opencost.opencost.prometheus.internal.port=9090
Para un Prometheus fuera del clúster, usa en su lugar
opencost.opencost.prometheus.internal.enabled=false,
opencost.opencost.prometheus.external.enabled=true y
opencost.opencost.prometheus.external.url=<url>. Si el nombre del Service del
sub-chart es distinto (un fullnameOverride), define opencost.exporterUrl.
Sin un Prometheus accesible, el sub-chart usa por defecto
prometheus-server.prometheus-system, y OpenCost no arranca donde ese Service
no existe. Si llega a un Prometheus sin el historial de uso que necesita, los
precios de los nodos siguen llegando, pero el desglose por namespace y por
workload queda parcial: un total que parece correcto sobre un desglose que no
suma lo mismo.
2. Scrape my OpenCost: ya ejecutas OpenCost, y el agente hace scraping de su exportador. Decláralo entre los exportadores del agente:
--set-string collectors.exporters.opencost=http://opencost.opencost.svc.cluster.local:9003/metricsEl scraping se hace con elección de líder: lo hace un solo pod del agente en el clúster, así que el DaemonSet no multiplica las mismas muestras por el número de nodos.
3. Read from my Prometheus: tu Prometheus ya hace scraping de OpenCost, y
el agente lee las familias de métricas de costo a través de la misma conexión
promRead que se usa para las métricas:
--set agent.promRead.enabled=true \
--set agent.promRead.cost.enabled=true \
--set agent.promRead.url=http://prometheus.monitoring:9090
promRead es mutuamente excluyente con el sidecar de scraping, así que el
asistente cambia a él la fuente de métricas del clúster: un solo Prometheus
alimenta las métricas y el costo. En este modo el agente pide las familias de
costo que se listan abajo, que se añaden a las métricas principales de
KubeBolt sin reemplazarlas nunca. Antes del agente 1.4.10 pedía ocho de ellas,
así que los volúmenes, los nodos spot, los balanceadores de carga y el egress
de red nunca llegaban por este camino.
Un Prometheus que hace scraping de OpenCost sin honor_labels (lo que hace por
defecto un ServiceMonitor de kube-prometheus) pone en cada serie de costo los
namespace, pod, container e instance del pod de OpenCost y renombra los
del propio OpenCost a exported_*. Leído tal cual, el costo de cada contenedor
caía en el namespace donde corre OpenCost. Desde el agente 1.4.10, promRead
devuelve a las familias de costo sus etiquetas exported_*; las etiquetas de
clúster y de tenant que añade nunca se sustituyen.
Una sola fuente de costo. Con el exportador (modos 1 y 2) y
agent.promRead.cost.enabled activados a la vez, cada familia de costo se
guardaba dos veces y cada total salía doble. Desde el agente 1.4.10, el chart
rechaza esa combinación: helm upgrade falla con un mensaje que nombra las
dos. Elige una: promRead.cost lee OpenCost desde tu Prometheus, el exportador
lee OpenCost directamente.
Qué envía cada camino
Una sola lista de 13 familias de costo es lo que cada camino envía, pide y conserva:
| Qué tiene precio | Familias |
|---|---|
| Nodos | node_total_hourly_cost, node_cpu_hourly_cost, node_ram_hourly_cost |
| Contenedores | container_cpu_allocation, container_memory_allocation_bytes |
| Volúmenes | pv_hourly_cost, pod_pvc_allocation |
| Nodos spot | kubecost_node_is_spot |
| Red | kubecost_load_balancer_cost, kubecost_network_internet_egress_cost, kubecost_network_nat_gateway_egress_cost, kubecost_network_region_egress_cost, kubecost_network_zone_egress_cost |
- El exportador (modos 1 y 2) reenvía estas y las familias
kube_*de OpenCost, nada más, desde el agente 1.4.10. Desde el backend 2.7.0, el resto (las familias de GPU, las métricas HTTP del propio OpenCost,pod_info, …) se descarta también al llegar de agentes anteriores, y se cuenta enkubebolt_agent_grpc_dropped_series_total{reason="opencost_unread"}. En un clúster de prueba, las series de OpenCost pasaron de 1.213 a unas 500. - promRead (modo 3) pide estas 13.
- La regla de keep por defecto del sidecar de scraping las conserva desde
la 1.4.10. Tu propio
scrape.metricRelabelConfigssustituye esa regla: añádele las familias de costo, o se descartan el costo de volúmenes, spot, balanceadores y egress.
Las familias de GPU se quedan fuera hasta que alguna vista de KubeBolt las lea: en un nodo sin GPU son una serie por contenedor que siempre vale cero. En KubeBolt Cloud las 13 familias cuentan como series principales en todos los planes.
Verificar
# 1. OpenCost está exportando
#    incluido: el Service es <release>-opencost en el namespace del agente
kubectl port-forward -n kubebolt svc/kubebolt-agent-opencost 9003:9003
#    el tuyo: ajusta el namespace y el Service, p. ej. -n opencost svc/opencost
curl -s localhost:9003/metrics | grep node_total_hourly_cost

# 2. El agente hace scraping de él (solo el pod líder)
kubectl logs -n kubebolt -l app.kubernetes.io/name=kubebolt-agent --tail=50 | grep -i exporter
Después, la pestaña Cost aparece en el panel del clúster en un par de minutos. La tarjeta OpenCost en Administration → Agents & Ingest → Integrations informa del mismo estado, para el clúster seleccionado en la barra superior: distingue en ejecución de enviando datos comprobando si las muestras de costo de este clúster llegaron realmente al almacenamiento:
| Síntoma | Causa |
|---|---|
| Tarjeta «installed», con «no cost samples reaching KubeBolt yet» | OpenCost se ejecuta, pero nada envía sus métricas: el exportador no está conectado en el agente |
| Tarjeta «degraded», con «OpenCost pods not fully ready» | A menudo es el sub-chart incluido en crash-loop porque no tiene un Prometheus accesible |
| Tarjeta «not installed» | No hay pods con la etiqueta app.kubernetes.io/name=opencost ni ningún pod llamado opencost* en los namespaces opencost, kubecost o monitoring |
| El total parece correcto, el desglose está vacío o es parcial | Al Prometheus de OpenCost le falta el historial de uso para la asignación |
| Todo a $0 | OpenCost no tiene lista de precios para el proveedor: on-prem y kind necesitan una personalizada |
| Tendencia de red vacía | El modo 3 con un agente anterior a la 1.4.10, que no lee las familias de red, o el clúster no tiene balanceadores de carga ni egress con precio |
| Todos los totales salen más o menos dobles | El exportador y promRead.cost activados a la vez, con un agente anterior a la 1.4.10: desactiva uno |
| El costo de todos los contenedores aparece en el namespace de OpenCost | El modo 3 con un agente anterior a la 1.4.10, leyendo un Prometheus que hace scraping de OpenCost sin honor_labels: actualiza el agente |
El helm upgrade del agente falla nombrando agent.promRead.cost.enabled y el exportador de OpenCost | Dos fuentes de costo: desactiva una. Hasta entonces, la release se queda en su versión anterior |
Las muestras de costo son métricas normales: siguen la retención del almacén
de métricas de KubeBolt (30 días en el VictoriaMetrics incluido,
metrics.storage.embedded.retention en el chart kubebolt), así que el
historial llega hasta ahí.