Seguridad
Seguridad y cumplimiento
Cuatro lentes de hallazgos más un feed de runtime, alimentados por Trivy, Kyverno y Falco. Qué ingiere cada uno, qué se convierte en hallazgo, qué necesita para funcionar y dónde termina la detección.
En esta página
KubeBolt no escanea tu clúster por sí mismo. Lee los escáneres que ya ejecutas (o que instalas con un solo comando), normaliza su salida en una única escala de severidad y le da un ciclo de vida: una identidad estable entre despliegues, un reloj desde la primera detección y la resolución cuando el problema deja de observarse.
El alcance, sin rodeos. Esto es detección y postura, no remediación automática. KubeBolt te dice qué está mal, a qué workload pertenece y cuál es el remedio. No parchea imágenes, no reescribe manifiestos ni hace cumplir políticas: hacerlas cumplir le toca a Kyverno, y los parches, a tu pipeline.
Las cuatro lentes
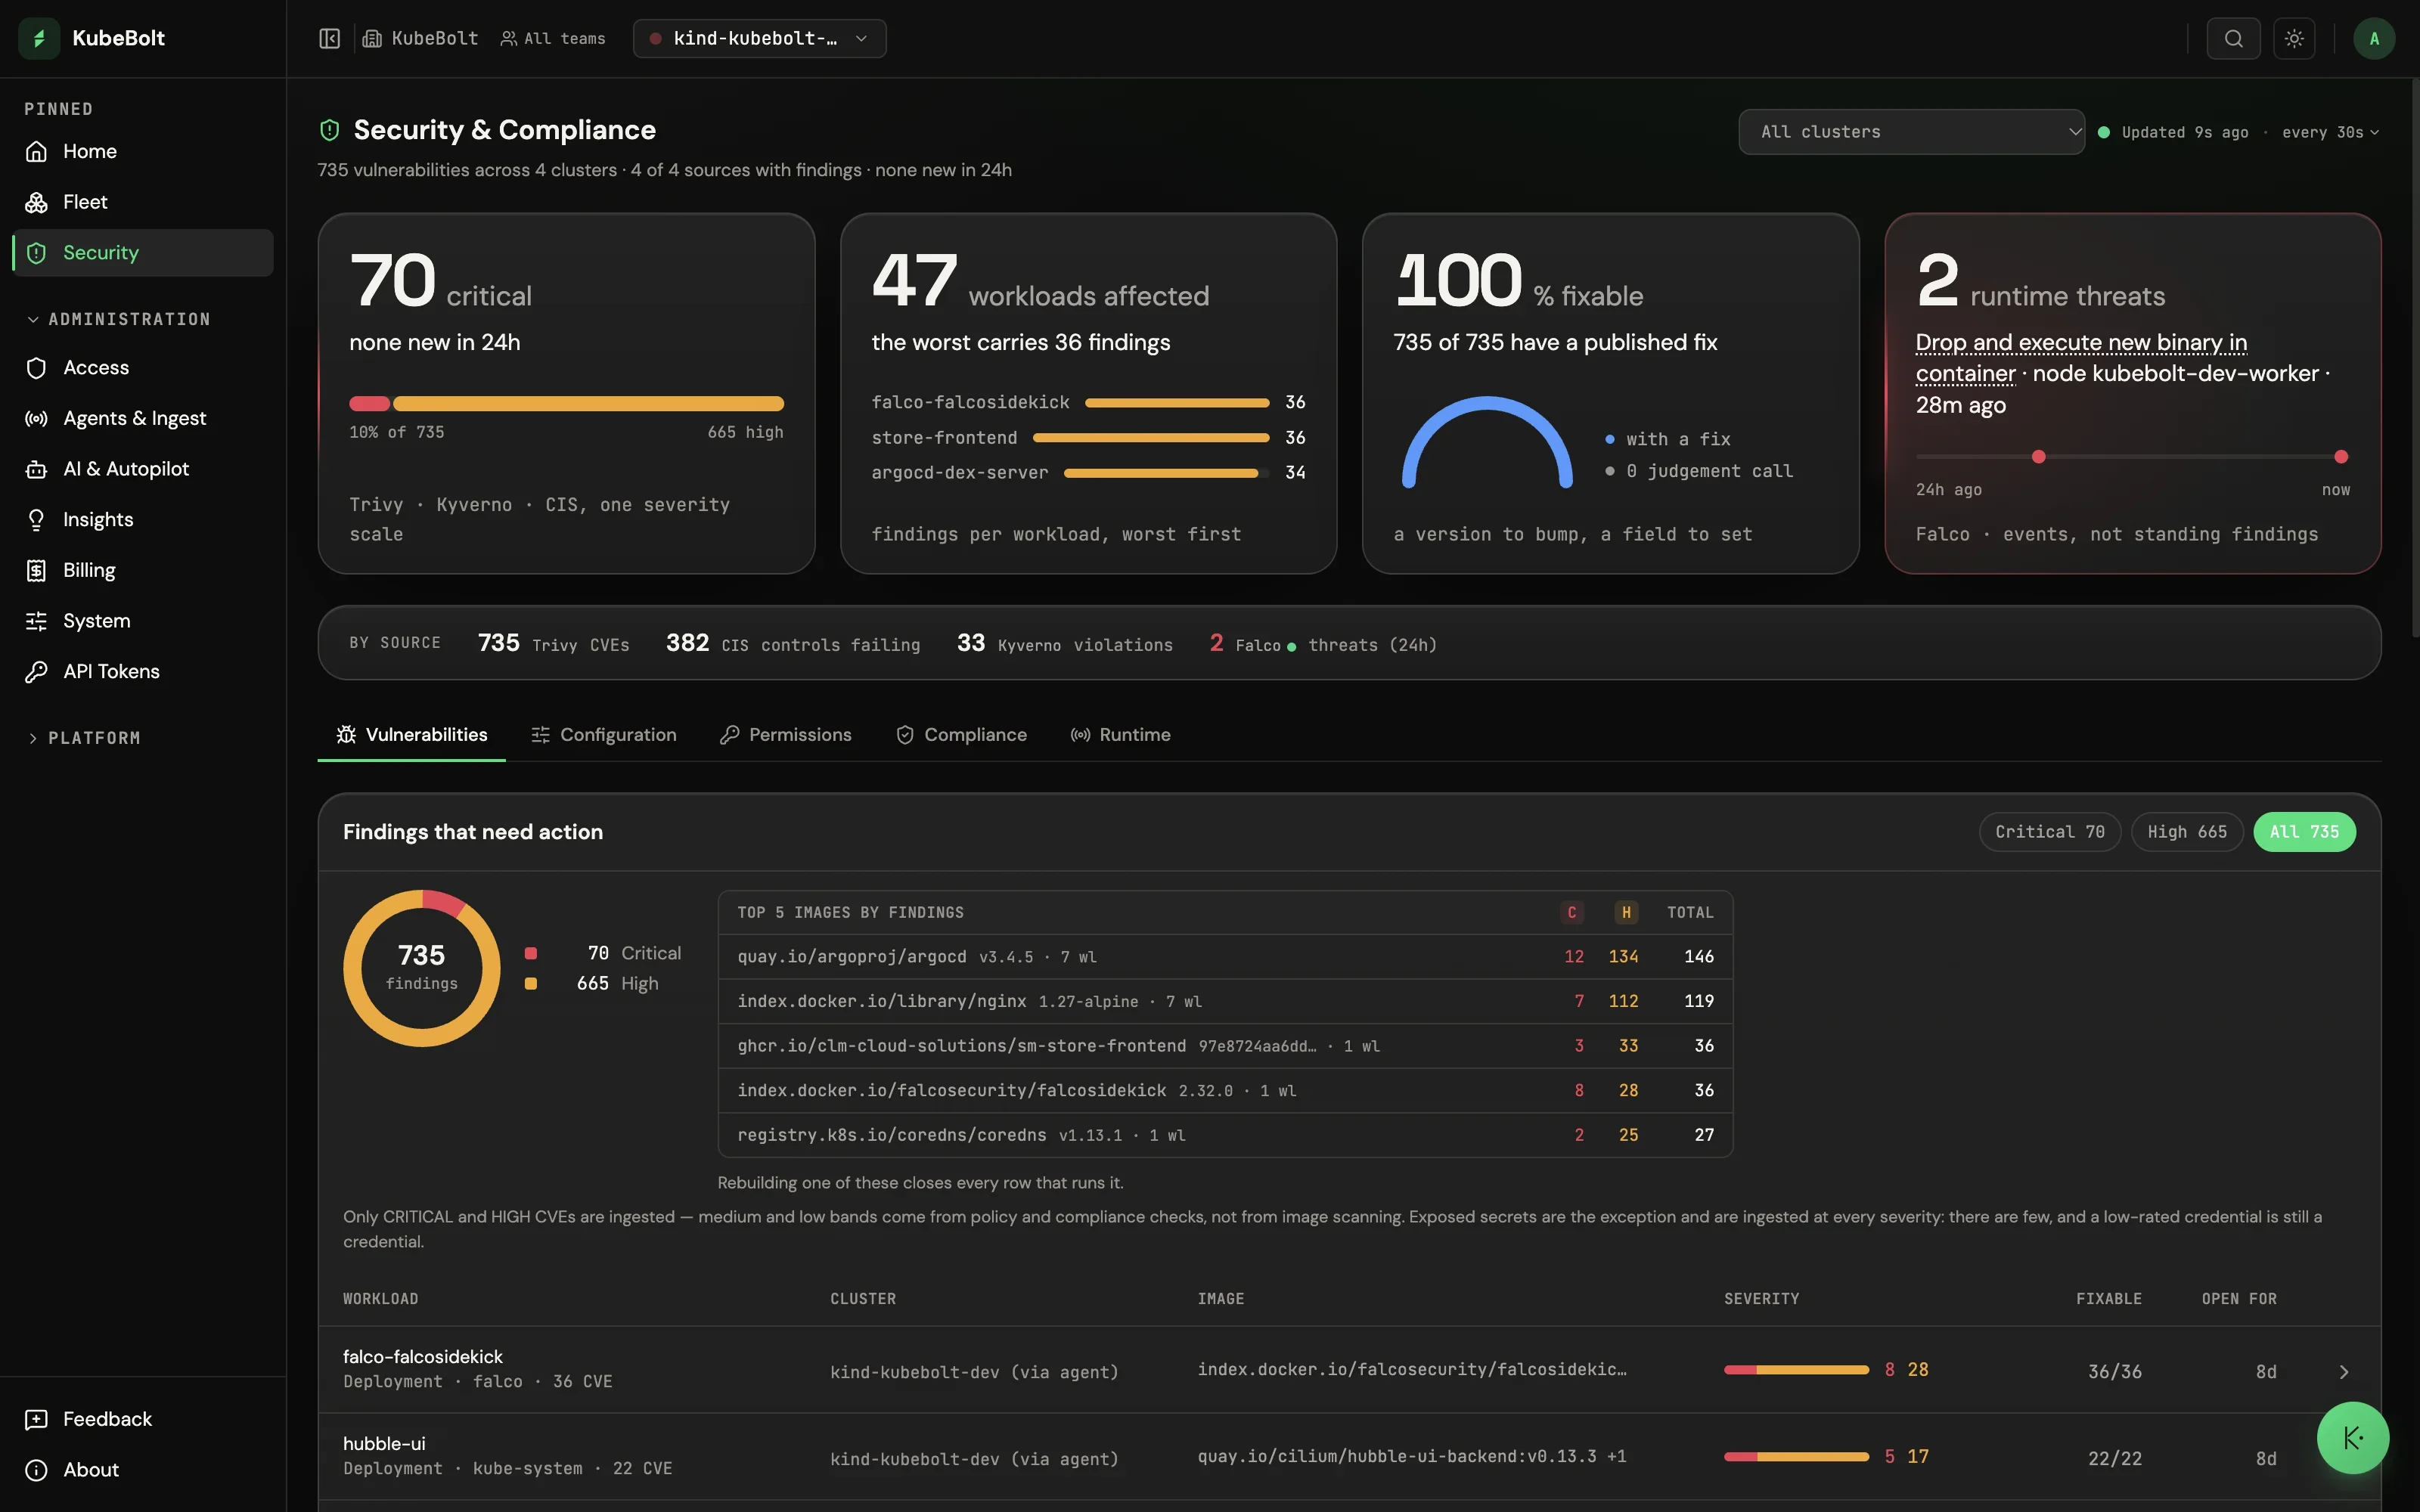
Security en la barra lateral abre Security & Compliance. Divide los hallazgos en cuatro lentes. Cada una es una pregunta distinta con un arreglo distinto, así que nunca se suman en una única lista ordenada.
| Lente | La pregunta | Alimentada por |
|---|---|---|
| Vulnerabilities | ¿Qué CVE y secretos expuestos hay en las imágenes que ejecutamos? | Trivy: VulnerabilityReport, ExposedSecretReport |
| Configuration | ¿Qué está mal configurado o incumple una política? | Trivy: ConfigAuditReport. Kyverno: PolicyReport, ClusterPolicyReport |
| Permissions | ¿Qué Roles y ClusterRoles conceden demasiado? | Trivy: RbacAssessmentReport, ClusterRbacAssessmentReport |
| Compliance | ¿Qué controles de un benchmark están fallando? | Trivy: ClusterComplianceReport (el benchmark CIS y cualquier otra especificación que ejecute el operador) |
La página abarca toda la flota: lee todos los clústeres que puedes ver, no el clúster seleccionado en la barra superior. Con más de un clúster, un selector junto al título la acota a uno.
La lista sobre la que actúas es de workloads, no de hallazgos (Roles en Permissions, controles en Compliance). Cientos de hallazgos suelen reducirse a un par de docenas de workloads, y lo que de verdad se cambia es un workload. Los recuentos de hallazgos se quedan en la fila de tarjetas de arriba: los críticos abiertos, los workloads afectados (roles, en la lente Permissions), la proporción de hallazgos con un arreglo publicado y las amenazas de runtime de las últimas 24 horas. La tarjeta de críticos lleva el veredicto en su color: rojo mientras haya algún crítico abierto, ámbar si solo hay altos, verde si no hay ni unos ni otros. La tarjeta de amenazas de runtime es la que se enciende en rojo, siempre que Falco haya reportado algo en las últimas 24 horas.
Entre las tarjetas y las pestañas, una fila By source dice qué aporta cada
escáner en todas las lentes: CVE de Trivy, controles CIS que fallan,
violaciones de Kyverno y amenazas de Falco en las últimas 24 horas. Está
encima de las pestañas porque «cuáles de mis escáneres están reportando»
no cambia al cambiar de lente. La línea bajo el título lo resume como
N of 4 sources with findings.
El feed de runtime
Runtime es la quinta pestaña y no es una lente. Es un flujo de eventos de Falco, guardado aparte de los hallazgos, y se comporta de otra manera a propósito:
- Los eventos son puntuales en el tiempo. Salen del feed a las 24 horas en lugar de resolverse. En la vista de detalle no hay botón de «resuelto», porque no hay ningún estado que cerrar, y un botón que mintiera sobre eso sería peor que nada.
- Las prioridades son las de Falco (de
EmergencyaDebug). No se mapean a la escala de severidad de los hallazgos. - Falco empuja (push); a Trivy y Kyverno se les consulta (pull). Esa es toda la razón por la que Falco necesita un token y un endpoint y los otros dos no necesitan ninguno de los dos.
La pestaña muestra las últimas 24 horas, hasta los 500 eventos más recientes: un desglose por prioridad, el Top 5 rules by hits y una fila por evento con la regla y el comando, el archivo que tocó, el pod (o el nodo, para una regla a nivel de host), el usuario y la hora.
Kobi también lee todo esto: get_findings para la postura,
get_finding_detail para releer un hallazgo en vivo desde el escáner,
get_finding_workloads para obtenerlos agrupados por workload con los secretos
expuestos primero, y get_runtime_events para lo que Falco vio hacer realmente
a los procesos (24 horas por defecto, hasta 720). Consulta
Kobi Copilot.
Qué se convierte en hallazgo
Todo escáner reporta más de lo que vale la pena atender. Los filtros son deliberados y cambian según la fuente:
| Fuente | Se ingiere | Se descarta |
|---|---|---|
| CVE de Trivy | CRITICAL, HIGH | MEDIUM, LOW, UNKNOWN: miles de filas que nadie termina de leer |
| Auditoría de configuración de Trivy | CRITICAL, HIGH, MEDIUM | LOW: sobre todo «se ejecuta con un UID bajo» y «sin límite de CPU/memoria», que KubeBolt ya señala como insight de capacidad |
| Evaluación RBAC de Trivy | CRITICAL, HIGH, MEDIUM | LOW, y los roles de arranque del propio Kubernetes (system:*, cluster-admin, admin, edit, view), que el plano de control restaura si los editas |
| Secretos expuestos de Trivy | Todas las severidades, sin filtro | Nada. El texto coincidente nunca se guarda: el hallazgo dice dónde, nunca qué |
| Cumplimiento de Trivy | Controles que fallan | Los controles que pasan no producen nada |
| Kyverno (PolicyReports) | result: fail | pass, skip, warn y error (un tropiezo del motor no es culpa del workload) |
Observa la asimetría entre el filtro de CVE y el de políticas. Un CVE sin
etiqueta de severidad se descarta; una violación de política sin etiqueta
de severidad se convierte en un hallazgo medium. Una política no es un hecho
de la naturaleza: alguien la escribió a propósito, así que un fallo importa
aunque nadie haya dicho cuánto. Un control de cumplimiento que falla conserva
su severidad cuando es CRITICAL o HIGH, y se registra como medium en los
demás casos.
Los secretos expuestos se cuentan aparte de los CVE: una credencial incrustada en una imagen no es una dependencia que actualizar.
La identidad de un hallazgo es su fuente, su tipo, su título y su recurso. Trivy reporta sobre el ReplicaSet; KubeBolt registra el hallazgo bajo el Deployment propietario, así que un despliegue nuevo no reinicia su antigüedad. Un hallazgo queda resuelto cuando un barrido completo deja de reportarlo. Si algún tipo de informe no se puede listar en una pasada (falta el CRD, permiso denegado, un tiempo de espera agotado), esa pasada no resuelve nada, porque una vista parcial no puede probar que algo haya desaparecido. Un clúster al que KubeBolt no está conectado conserva sus hallazgos tal como estaban hasta que vuelve.
Qué necesita
- Autoalojado: autenticación activada. Los hallazgos y los eventos de
runtime viven en el mismo almacén que los usuarios y los tokens, así que solo
existen con la autenticación habilitada (
auth.enabled=trueen el chart de Helm, el valor por defecto;KUBEBOLT_AUTH_ENABLED). Sin ella no hay barrido, la página se queda vacía y el endpoint de ingesta de Falco responde503. - Una conexión que pueda listar los CRD de informes. Trivy y Kyverno se
leen a través de la conexión con la API del clúster: una conexión directa o
in-cluster (la ClusterRole del chart
kubeboltya concede lectura sobre los informes deaquasecurity.github.ioywgpolicyk8s.io), o el agente con su proxy activado (rbac.mode=reader, el valor por defecto, uoperator; consulta Modo RBAC). Un agente solo de métricas (rbac.mode=metrics) envía métricas, pero ningún hallazgo de Trivy ni de Kyverno. - Falco no depende de la conexión (empuja sus eventos), pero su token tiene que estar acotado al clúster. Consulta Falco.
En Cloud las dos primeras ya se cumplen: los clústeres se conectan a través del agente, cuyo nivel por defecto cubre el barrido.
Conectar las fuentes
Tres páginas, una por fuente:
- Trivy: CVE, secretos expuestos, errores de configuración, postura RBAC y CIS. Alimenta las cuatro lentes.
- Kyverno: tus propias políticas. KubeBolt lee
PolicyReports
wgpolicyk8s.io/v1alpha2, sea cual sea el motor que los escribió. Las constraints de Gatekeeper no se leen directamente. - Falco: eventos de syscalls en runtime. La única fuente que necesita un token.
Cada escáner se detecta por sus pods, por etiqueta y, si no, por namespace (las etiquetas exactas están en cada página). El resultado es una tarjeta en Administration → Agents & Ingest → Integrations, para el clúster seleccionado en la barra superior: Installed, Degraded (hay pods, pero no todos están Ready), Not installed o Unknown (KubeBolt no pudo listar los pods). La tarjeta dice que el escáner se ejecuta; la fila By source de la página Security dice que reporta. KubeBolt no instala los escáneres: la página Integrations no tiene un botón Install para ellos.
Las fuentes de escáneres se barren cada 10 minutos, y una vez al arrancar, en cuanto se conecta un clúster. Los eventos de Falco llegan a medida que Falco los envía.
Retención
Los hallazgos de seguridad y los eventos de runtime comparten un mismo horizonte. Los hallazgos activos nunca caducan; un hallazgo resuelto se borra cuando lleva resuelto más tiempo que el horizonte, y un evento de runtime, cuando es más antiguo que él. La limpieza va con la pasada de retención de cada hora.
En la edición open source el horizonte es
KUBEBOLT_FINDINGS_RETENTION_HORIZON, por defecto 720h (30 días). El chart
de Helm no tiene un valor dedicado; defínelo mediante extraEnv (consulta
Variables de entorno).
En Cloud la ventana depende del plan:
| Plan | Retención |
|---|---|
| Free | 15 días |
| Team | 30 días |
| Business | 90 días |
| Enterprise | 365 días |
Correo de seguridad en Cloud
En Cloud, los hallazgos también llegan a las personas por correo. La edición open source no envía estos correos.
- Primer escaneo. Un resumen por clúster, una sola vez, cuando llegan sus primeros hallazgos. Espera a que la ingesta lleve 15 minutos en calma (dos horas como máximo), así que los escáneres instalados en una misma sesión producen un solo mensaje, no uno cada uno. Va al equipo dueño del clúster y, desde el plan Team, también a seguridad.
- Postura abierta. Un resumen de lo que sigue abierto: semanal en los planes de pago, mensual en Free. Va a seguridad.
Desde el plan Team, «seguridad» es el destino de seguridad de la organización (Administration → System → Notifications → Security destination, normalmente una lista de distribución) o, mientras no haya ninguno, los administradores de la organización. En Free, el equipo es seguridad. Ambos mensajes respetan los interruptores de notificaciones de la organización (notificaciones activadas, canal de correo activado). Consulta Notificaciones.
Lo que aún no está
- Sin remediación automática. Kobi puede proponer y ejecutar acciones sobre workloads bajo gobernanza, pero nada en la página Security actúa por sí solo sobre un hallazgo.
- Sin silencio por hallazgo. Las excepciones pertenecen al escáner (el archivo de ignorados de Trivy, una PolicyException de Kyverno), así que la fuente sigue siendo la autoridad.
- Los eventos de runtime no se pueden resolver ni reconocer (ver arriba).
- El ajuste de Falco se hace en Falco. Silenciar una regla ruidosa es un
cambio de
customRulesen la fuente, no un ajuste de KubeBolt.