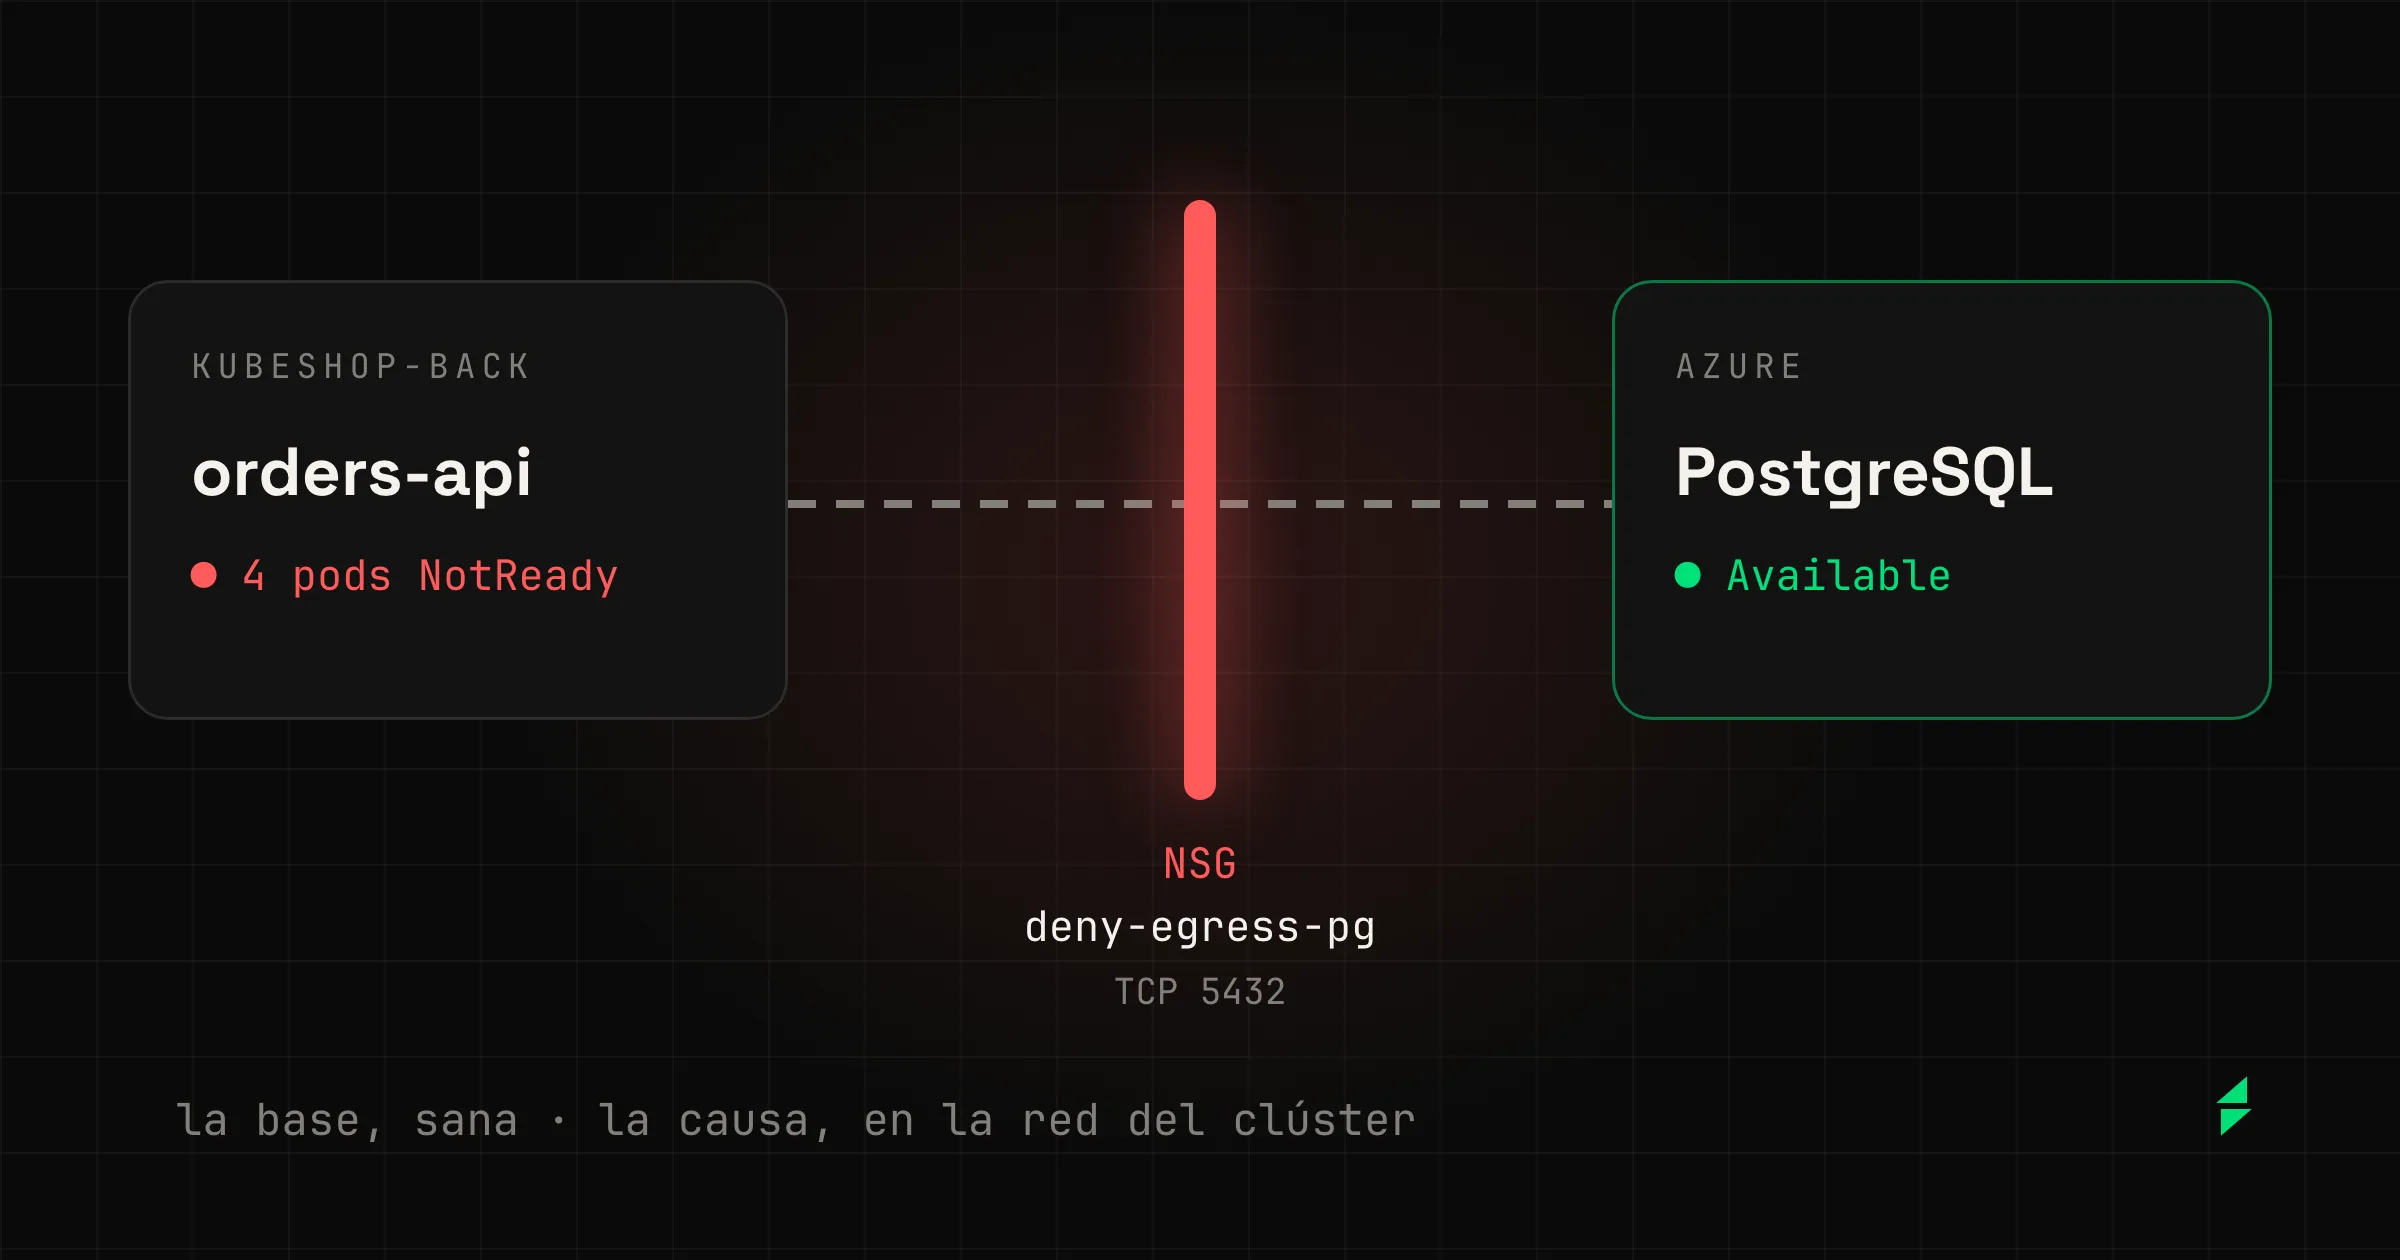
Los incidentes más difíciles de explicar son los que el clúster no ve. Los pods están Ready, la base de datos aparece como Available en Azure y la tienda devuelve 503. La causa está en una regla de red, en un parámetro o en un permiso, y nada de eso vive dentro de Kubernetes.
En la 2.3 conté que estamos conectando Kobi con AWS, Azure y GCP para que pueda seguir la causa fuera del clúster. Antes de dejarle leer la nube de nadie, necesito saber si la encuentra, y para eso uso incidentes concretos y la pregunta que haría alguien a las tres de la mañana.
El método tiene un nombre poco glamuroso: el examen se escribe antes de romper nada. Monto el fallo en un laboratorio de Azure tal como pasaría de verdad. Antes de preguntar, escribo qué tiene que encontrar Kobi y qué trampas tiene que evitar. Después le hago la pregunta del operador, sin pistas, y evalúo la respuesta contra esa lista. Un arreglo solo cuenta cuando la siguiente vuelta lo demuestra en el chat real.
Lo que hay debajo, en cinco líneas:
- El laboratorio rompe Azure como se rompe en la vida real, con pistas falsas del mismo día.
- Lo que Kobi sabe de Azure viaja en cuatro capas, y la que más pesa llega dentro del resultado de una herramienta.
- La pregunta es la del operador, por ejemplo «La tienda no carga, ¿qué pasa?».
- Cada respuesta se evalúa con criterios escritos antes, créditos incluidos.
- El conector solo puede leer, y eso no depende de que el modelo se porte bien.
El laboratorio
Son dos clústeres de AKS que forman una tienda. En kubeshop-front corre la web. En kubeshop-back corren orders-api y catalog-api, que leen de un PostgreSQL flexible de Azure, fuera del clúster y en otra región.
Cada fallo lo inyecta un agente como lo haría una persona: un parámetro del servidor, un ALTER ROLE dentro de la base, una regla en un NSG. Y casi siempre hay ruido alrededor: cambios anteriores en el activity log, un reinicio, un corte que ya se resolvió.
| Lo que se rompe | Lo que ve el clúster | La trampa |
|---|---|---|
statement_timeout = 50: alguien quería 50 segundos y son milisegundos | orders-api da 500, catalog-api sigue en 200 | Reiniciar o inventar el valor anterior |
La contraseña del rol, cambiada con ALTER ROLE dentro de la base | Todo bien hasta el siguiente reinicio | El rollback y los cambios del día |
| Una regla de salida en el NSG de los nodos | Pods NotReady, la base Available | Culpar a la base |
Un permiso revocado con REVOKE | 500 en unos 30 ms | Señalar a alguien sin registro |
| La base en otra región | Unos 150 ms por página | Culpar a la región de toda la diferencia |
| Una regla de entrada en el NSG | Pods Ready sin tráfico | Fiarse de las sondas sanas del balanceador |
Hasta ahora todo se ha probado contra PostgreSQL. Azure SQL y Service Bus tienen escenarios preparados, y el resto de recursos que Kobi reconoce todavía no se ha probado.
El recorrido de una pregunta
Antes de los resultados, el arnés: lo que rodea al modelo para que una pregunta llegue a la causa. Un backend del clúster deja de alcanzar su base de datos en Azure, y el operador pregunta qué pasa. Las flechas son las llamadas de Kobi, en orden.
- Logs del backend.
get_pod_logsdevuelve los tramos de error, con su inicio y su fin. - La dirección. El Service o el entorno del pod dan el host de la base de datos.
- La clasificación.
get_external_connectionsreconoce el recurso por su dominio y devuelve el método. - La herramienta de Azure. Kobi llama a
monitor,postgresoresourcehealth. - El filtro. El gateway comprueba el comando, fija la suscripción y quita lo que no debe salir.
- La lectura. El servidor MCP de Azure consulta con una identidad que solo puede leer.
- La respuesta. Causa, quién y cuándo, y la duración medida en los logs.
Las cuatro capas
La forma obvia de enseñarle a Kobi cada recurso es una skill por recurso. Las pruebas la descartaron: Haiku no siempre carga una skill (una de las nuestras no la cargó ni una vez), pero siempre lee el resultado de una herramienta. Así que lo que Kobi sabe de Azure llega en cuatro momentos distintos, y solo el primero depende del recurso concreto.
La clasificación de la dirección
- Cuándo llega
- Cada vez que Kobi sigue una dirección fuera del clúster, dentro del resultado de get_external_connections.
- Qué lleva
- El tipo de recurso (15 hoy, por su dominio), si la organización tiene el conector, por qué herramientas empezar y cómo investigar ese tipo.
«¿Está caído? Empieza por monitor_activitylog_list con el nombre del servidor y top 20: paradas y arranques, failover, cambios de firewall y red, quién y cuándo. No necesita grupo de recursos.»
La guía de dependencias externas
- Cuándo llega
- Cuando Kobi sospecha de algo fuera del clúster y la carga.
- Qué lleva
- El método general: seguir la clasificación, usar un conector solo si está activo, leer el activity log del recurso correcto.
«Las sondas de un balanceador entran por su propia regla (en Azure, AzureLoadBalancer): unos backends sanos no demuestran que el tráfico del cliente pase.»
La pista del conector
- Cuándo llega
- Solo si la organización tiene el conector activo.
- Qué lleva
- Cómo se llama una herramienta de Azure, que la suscripción la fija KubeBolt y cómo encontrar un grupo de recursos sin adivinarlo.
«Para una base de datos que dejó de responder, empieza por ese activity log. Ningún comando de configuración dice si el servidor está corriendo.»
La descripción de cada comando
- Cuándo llega
- Siempre, en cada herramienta que Kobi ve.
- Qué lleva
- Qué devuelve el comando y qué no, escrito por nosotros en lugar del texto de Microsoft.
«postgres_server_config_get: versión, SKU, región, almacenamiento, retención de backups. No dice si está corriendo, ni su red ni su firewall.»
Las citas son del código, traducidas.
El coste también lo decide el arnés. Kobi trabaja con Haiku 5.5 y pasa a Sonnet 5.5 cuando tiene que salir a la nube. Al principio escalaba con solo cargar la guía, y el lado del front costaba unos 49 créditos por prueba sin tocar Azure. Ahora escala según lo que encuentra la clasificación, y ese lado cuesta 3 o 4.
El examen se escribe antes
Los criterios cambian con cada escenario, pero hay una base común. La causa, con el valor y la hora. Quién hizo el cambio, si hay un registro que lo diga. El remedio en la capa correcta: si la culpa es de una regla del NSG, reiniciar los pods no cuenta. Las trampas del escenario. Nada inventado. Y cuántas llamadas y créditos costó.
Escribirlo antes importa porque una respuesta de Kobi casi siempre suena bien. Con la lista delante se ve lo que le falta.
El primer escenario de la tabla lo pasamos dos veces, con 17 días de diferencia. El 12 de octubre Kobi encontró la causa, el autor y la hora en 57 segundos, siguiendo el error desde el clúster del front hasta el del back y de ahí a Azure. Esta es la comparación con el 25 de septiembre, contando los arreglos de ese mismo día:
| Criterio | 25 sep | 12 oct, con los arreglos |
|---|---|---|
| Causa: parámetro, valor y hora | Sí | Sí, y los tres cambios del día |
| Quién hizo el cambio | No lo nombró | Lo nombra, del activity log |
| Región del servidor | Inventada, la del clúster | No afirma ninguna |
| Valor al que volver | 250–500 ms, como si fuera el anterior | Lo encuentra: «Déjalo en 0» |
La prueba entera costó 100 créditos (unos 0,50 dólares) en la primera vuelta del 12 de octubre, y 90 con los arreglos.
El valor anterior estaba en el activity log de Azure, pero no cabía en lo que una herramienta puede entregar al modelo:
Una respuesta de un agente casi siempre suena bien. Por eso el examen se escribe antes de romper nada.
Un caso entero: la regla que no se ve desde dentro
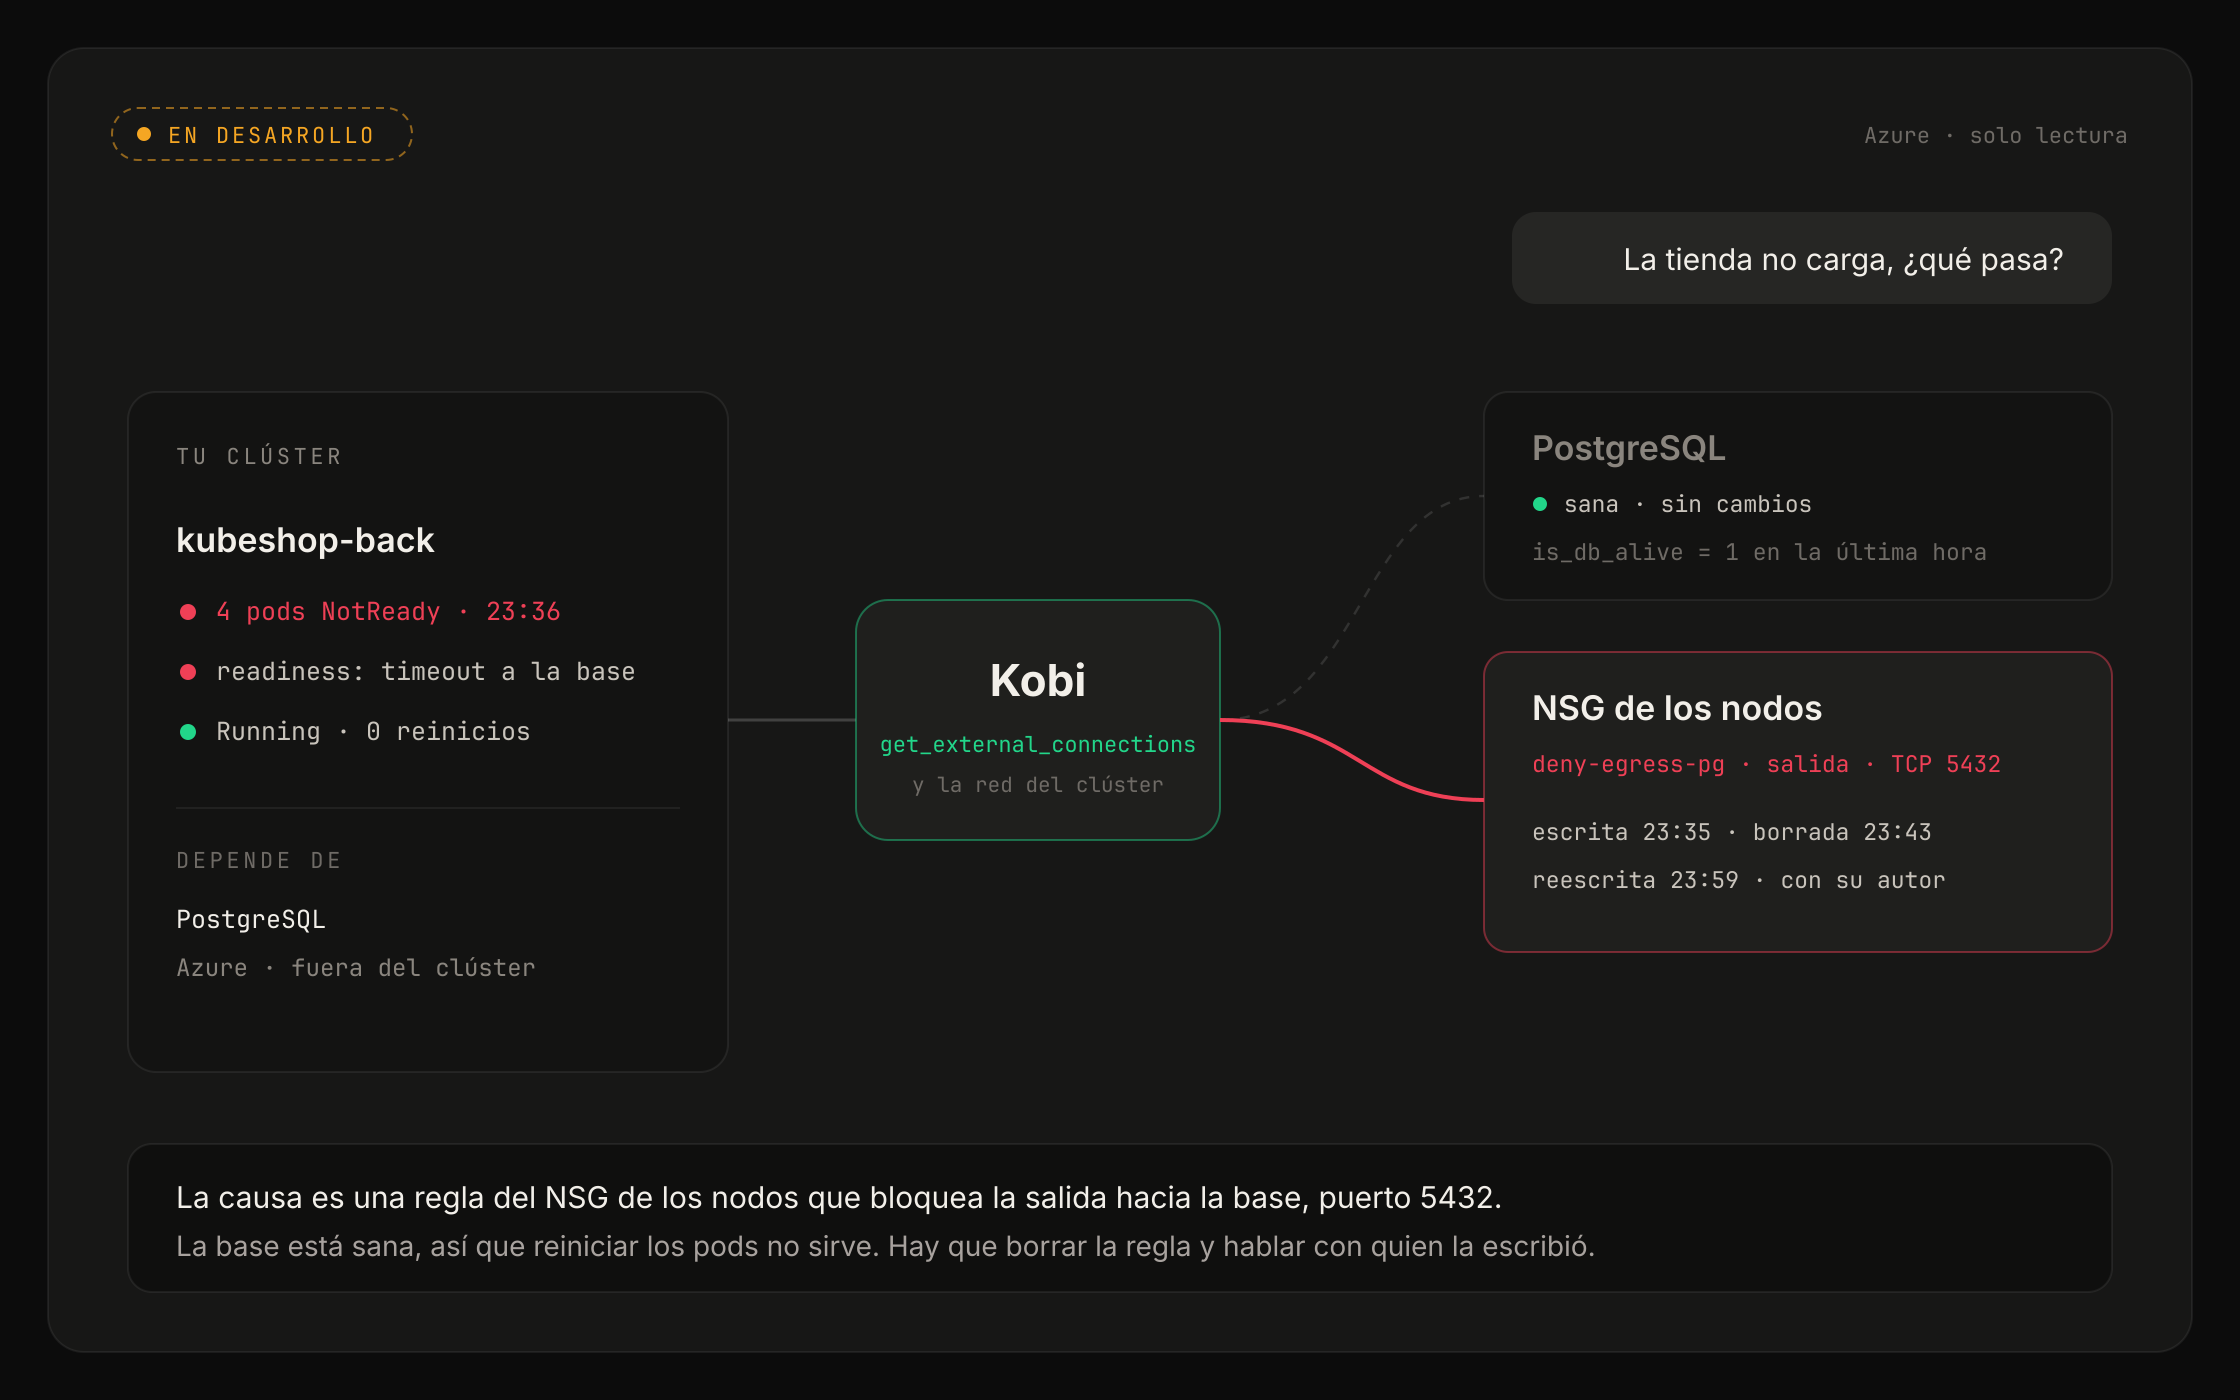
Alguien añade una regla al NSG de la red de los nodos de kubeshop-back: denegar la salida TCP al puerto 5432 de la base. La base sigue Available y su firewall, intacto. La sonda de readiness del backend abre una conexión a la base, expira, y los cuatro pods quedan NotReady. La tienda entera da 503, y desde la base no se ve nada porque el tráfico nunca le llega.
La pregunta fue «La tienda no carga, ¿qué pasa?».
En las dos vueltas, Kobi descartó la base con buen criterio. La diferencia está en cómo gastó sus cinco llamadas a Azure:
- 1 Activity log de la base Vacío: la base no cambió
- 2 Métricas de la base La serie acaba antes del fallo
- 3 Lista de grupos La cuenta entera
- 4 Grupo de la base La base ya era conocida
- 5 Grupo del túnel Una pista falsa
Se queda en «algo en el camino de red». La regla llega con una segunda pregunta.
- 1 Activity log de la base Vacío otra vez
- 2 Métricas de la base Viva en las 13 muestras
- 3 Grupo MC_… de los nodos La red del clúster
- 4 Activity log del NSG La regla, su autor y su hora
- 5 Sin usar
La regla en la primera respuesta, con sus dos escrituras y el borrado entre ellas.
En la primera vuelta, Kobi no sabía dónde está la red de su propio clúster, aunque los nodos lo dicen en sus etiquetas, y listó la cuenta para encontrarla. El arreglo no fue darle más llamadas: la clasificación entrega ahora ese grupo de red cuando Kobi sigue una dirección hacia Azure, y la guía cubre las dos direcciones del tráfico. Con la regla delante, Kobi propuso borrarla y confirmarlo con quien la escribió, y explicó por qué los pods seguían en Running: leyó el código del servidor, donde la readiness toca la base y la liveness no.
El 10 de octubre habíamos probado la otra dirección, una regla que corta la entrada desde Internet hacia el balanceador. Acabó en un ir y venir entre los dos clústeres, con Haiku y con Sonnet, y nadie leyó el log del NSG. Con el mismo arreglo, la regla, su autor y su hora salieron en la primera respuesta.
Ese caso deja una idea que vale fuera del laboratorio: Ready no quiere decir alcanzable. La readiness la hace el kubelet desde el propio nodo, y las sondas del balanceador entran por una regla de Azure reservada para ellas. Ninguna cruza la regla nueva, así que dentro del clúster todo sigue en verde y la única señal es que los logs se callan.
Solo lectura por construcción
La última capa del arnés no le pide nada al modelo. Son reglas que el gateway de KubeBolt aplica antes de que una llamada salga hacia Azure:
- comandos de Azure que el gateway deja pasar
- 48
- que puedan escribir
- 0
- tipos de recurso que Kobi reconoce por su dirección
- 15
- Solo lectura, dos vecesEl servidor de Azure arranca en modo de solo lectura, y el gateway rechaza además cualquier comando cuyo nombre termine en un verbo de escritura.
- La suscripción, fijadaCada llamada va a la suscripción del conector. Un identificador que intente salir de ella se rechaza.
- Ni datos ni secretosValores de secretos, consultas a la base, blobs de Storage e items de Cosmos quedan fuera, aunque Microsoft los marque como lectura.
- Sin entrar en la baseEl usuario y la contraseña de la base se quitan de cada petición. KubeBolt trabaja a nivel de servidor.
- KQL sin saltosUna consulta no puede ir a otro workspace ni al Resource Graph.
- Una identidad que solo leeUn service principal con roles de lectura: Reader, Monitoring Reader y Log Analytics Reader.
- Sin memoriaEl servidor escucha solo en local, no manda telemetría y no guarda caché: «¿ya se recuperó?» nunca lee una respuesta vieja.
- Por organizaciónEl conector se activa por organización, y cada llamada queda en su auditoría.
Cuando la causa está en Azure, Kobi te da el comando para arreglarla, pero no lo ejecuta.
Lo que todavía falla
La lista de huecos que sale de estas pruebas tiene bastantes más entradas de las que cuento aquí, unas resueltas y otras abiertas. Te cuento una de las que menos me preocupan.
Con el permiso revocado, Kobi dijo bien que nadie puede saber quién lo revocó, porque un REVOKE no pasa por Azure y el servidor del laboratorio no guarda sus sentencias. Pero luego propuso como «contacto más probable» al autor de la regla de red de una hora antes, por una coincidencia que además no era cierta. La regla que proponemos es corta: quién hizo un cambio solo se sabe por el registro de ese cambio.
Lo que todavía no es
Los conectores están en desarrollo y no tienen fecha. Azure es donde probamos primero. Hoy el conector funciona como un servidor junto a la API, pensado para instalaciones propias, y el modo para KubeBolt Cloud, con la identidad de cada organización, está diseñado y sin construir.
Lo que queda
Un agente que investiga incidentes es tan bueno como los incidentes que le rompes a propósito. El método es corto de contar: rompo algo como se rompe de verdad y le hago a Kobi la pregunta de un operador. Lo que decide si la respuesta vale es la lista que escribí antes de empezar, con los créditos que costó pasarla.
Cuando los conectores salgan, saldrán con este laboratorio detrás y con cada escenario que añadamos hasta entonces.