Cuando le das documentación a un asistente, el instinto es pegarla entera en el prompt de sistema. Está toda ahí, el modelo no tiene que ir a buscar nada, y no hay una capa de recuperación que pueda equivocarse.
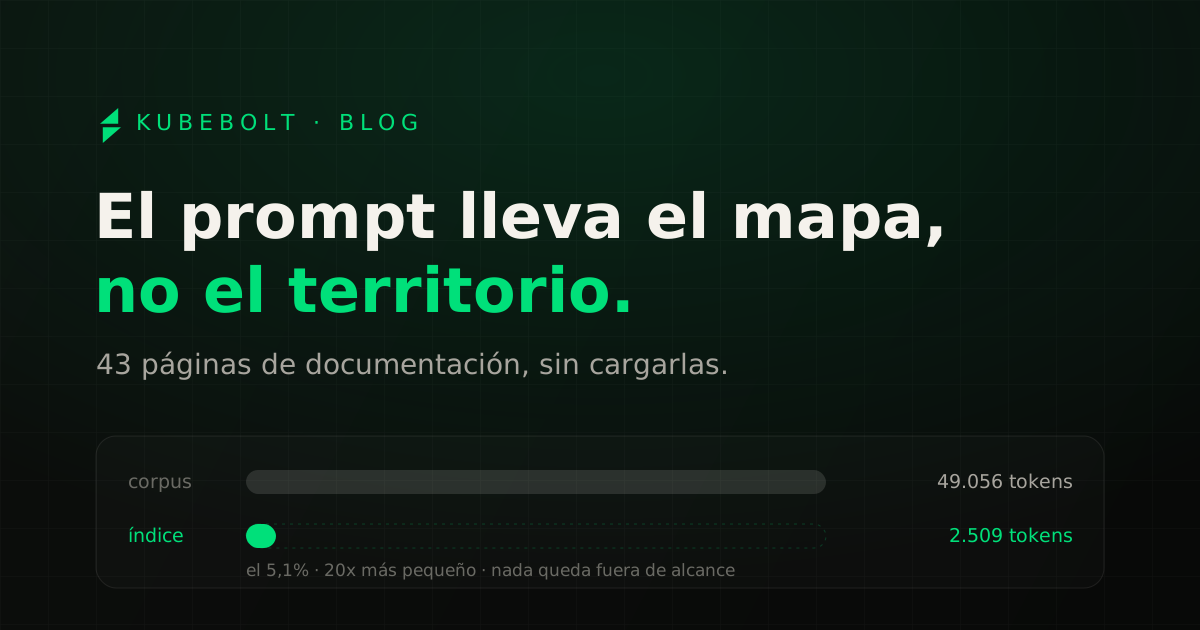
Nuestra documentación son 43 páginas. Medidas: 196.224 caracteres, unos 49.056 tokens. Cabe de sobra en la ventana de contexto de cualquier modelo actual. Así que el instinto parece correcto.
No lo es. Y el motivo no tiene nada que ver con el tamaño del contexto.
Lo que hay debajo, en cinco líneas:
- El corpus son 49.056 tokens. El índice que va en el prompt, 2.509. El 5,1%.
- Lo que se paga no es ocupar contexto: es escribir la caché.
- Los encabezados del índice son la parte que hace que el modelo acierte a la primera.
- La página traída se queda en la conversación: las repreguntas del mismo tema no cuestan nada extra.
- El precio real son 4,6 segundos, y un visitante ya nos lo dijo.
El prompt estable es un activo, y se estropea al engordarlo
El prompt de sistema de Kobi lleva un punto de caché con una hora de vigencia. Eso significa que el prefijo (las instrucciones, el tono, los datos de producto, el índice) se escribe una vez y las conversaciones siguientes lo leen en lugar de reenviarlo.
La diferencia de precio no es menor. Una lectura de caché se factura a 0,1x la tarifa de entrada. Una escritura, a 1,25x. Doce veces y media más cara que leerla.
// tools va ANTES de system: la definición de la herramienta entra en el mismo
// prefijo cacheado y por eso no cuesta nada por turno.
client.messages.stream({
  model: MODEL,
  tools: [READ_DOC],
  system: [{
    type: "text",
    text: system,                                   // instrucciones + producto + el índice
    cache_control: { type: "ephemeral", ttl: "1h" },
  }],
  messages,
});
Ese cache_control es toda la economía del diseño en una línea. Lo que quede por encima de él se escribe una vez y se lee muchas. Lo que metas dentro, lo llevas en cada escritura.
Ahí está el problema de pegar el corpus entero. No es que 49.000 tokens no quepan: es que cada vez que la caché se enfría y hay que reescribir el prefijo, pagas 49.000 tokens a 1,25x para llevar texto que la inmensa mayoría de las conversaciones no van a mirar. Alguien pregunta por el precio, y su conversación paga por la página de RBAC, por la de OpenShift y por la de Falco.
Un prompt estable es un activo. Cada token que le añades para el caso raro lo pagas en el caso común.
El mapa, no el territorio
Lo que va en el prompt es un índice: una línea por página con su identificador, su título, una descripción recortada y sus encabezados de segundo nivel.
| Corpus completo | Índice | |
|---|---|---|
| Caracteres | 196.224 | 10.036 |
| Tokens aproximados | 49.056 | 2.509 |
| Proporción | 100% | 5,1% |
Veinte veces más pequeño. Y con eso el modelo sabe qué hay documentado y dónde, aunque no sepa qué dice exactamente.
Tres entradas reales del índice. En el prompt cada una ocupa una sola línea; aquí van plegadas para que se lean:
quickstart | Quick Start | Get KubeBolt running in under 2 minutes.
  | Fastest: Helm chart · Get the admin password · The first-login Setup
    Wizard · Docker Compose · Prefer the Cloud? · Next

api-tokens | API tokens | kbs_ service tokens and kbk_ API keys — how to
  create them, what scopes they get, and why a service token i...
  | Two kinds · Creating one · Scopes · Cluster targeting · The
    public-edge restriction · Revoking

troubleshooting | Troubleshooting | Symptom, cause, fix — for the failures
  that actually happen: empty dashboards, the limited-access banner, 5...
  | The agent is connected but the dashboards are empty · Amber banner:
    "Limited access…" · 503 "cluster not connected" · The admin password
    is lost · Kobi's panel is missing · Still stuck
Las descripciones se recortan a 110 caracteres y los encabezados a nueve por página. Un visitante que pregunte por qué su panel está vacío tiene la respuesta localizada antes de que se traiga una sola página.
Cuando la pregunta necesita el contenido de una página (un comando de instalación, un valor de Helm, una variable de entorno, un síntoma concreto), llama a una herramienta que le devuelve el texto de la página entera. Como máximo dos páginas por respuesta, y solo identificadores que aparezcan en el índice: el esquema de la herramienta los enumera, así que el modelo no puede inventarse una página que no existe.
const READ_DOC = {
  name: "read_doc",
  input_schema: {
    type: "object" as const,
    properties: {
      slugs: {
        type: "array",
        items: { type: "string", enum: DOC_SLUGS },  // las 43, y solo esas
        minItems: 1,
        maxItems: 2,                                 // dos páginas por respuesta
        description: "Doc slugs from the index, without the /docs/ prefix.",
      },
    },
    required: ["slugs"],
  },
};
El enum es la parte importante y no es una comodidad de tipos: es lo que hace imposible una alucinación de ruta. El modelo no puede pedir una página que no exista, porque el esquema no se lo permite.
Y aquí está la parte que hace que el diseño se sostenga: la página traída se queda en el historial de mensajes de esa conversación. Si el visitante repregunta sobre el mismo tema, el texto ya está delante. La recuperación se paga una vez por conversación, no una vez por pregunta.
Los encabezados son la parte que paga
Un índice con solo el título y la descripción de cada página también cabe, y es más corto. Pero produce un comportamiento peor, y merece la pena entender por qué.
Nuestro índice incluye los encabezados de segundo nivel de cada página: 220 en total a lo largo de las 43 páginas. Son el 40% de su tamaño, y hacen dos cosas.
La primera es que muchas preguntas se responden sin traer nada. Alguien pregunta dónde se documenta la rotación de tokens y el índice ya contiene esa sección por su nombre: la respuesta correcta es enlazar la página, no leerla entera. Sin los encabezados, el modelo tendría que traérsela para averiguar si está ahí.
La segunda es que, cuando sí hay que traer, acierta a la primera. Un índice de títulos genéricos obliga a elegir entre candidatas parecidas, y ante la duda el modelo trae dos páginas para asegurarse. Eso duplica el coste de la recuperación y añade texto irrelevante al contexto.
Dicho de otro modo: los encabezados son el 40% del índice y evitan una parte de las llamadas y casi todos los fallos de puntería.
La factura: 4,6 segundos y un pulgar abajo
Aquí es donde este artículo se separa de la mayoría de los que cuentan una optimización. El diseño tiene un precio, es medible, y lo hemos medido.
Traer una página exige una segunda vuelta al modelo. La primera decide qué traer, la segunda responde con el texto delante. En producción, sobre nuestros propios turnos:
| Primer token | Respuesta completa | |
|---|---|---|
| Sin recuperación | 1.213 ms | 4.129 ms |
| Con recuperación | 2.628 ms | 8.767 ms |
Se duplica. Y no es una cifra teórica: uno de los primeros visitantes valoró una respuesta con el pulgar hacia abajo y el motivo too_slow. La tabla de métricas nos dijo, sin guardar ni una sola palabra de su pregunta, que ese turno había traído documentación.
Es un intercambio, no una victoria limpia. Lo aceptamos porque el 100% de las conversaciones pagarían la escritura de caché del corpus, mientras que solo el 40% de los turnos acaban trayendo una página. Pero si esos siete u ocho segundos se vuelven un problema, la palanca es bajar el tope de caracteres por página, no quitar la ida y vuelta.
Dos cosas que hoy son ciertas por muy poco
Cuando decimos que este diseño no deja nada fuera, conviene decir hasta dónde llega esa afirmación. Son dos matices, y los dos están a punto de dejar de ser ciertos.
El tope por página son 12.000 caracteres. Existe para que una página desbocada no reviente el contexto ni la factura. Hoy no se activa nunca: la página más larga tiene 11.861 caracteres. Un margen de 139 caracteres, el 1,2%. Un párrafo más en esa página y empezamos a cortar contenido sin que nada avise.
El índice recorta los encabezados a nueve por página. De las 43 páginas, exactamente una los supera hoy: la referencia de la API. Sus secciones a partir de la novena no aparecen en el mapa, así que una pregunta sobre una de ellas depende de que el modelo traiga la página por el título, no por la sección.
Ninguno de los dos es un fallo ahora mismo. Los dos son ciertos por poco margen, y ninguno de los dos se queja cuando deja de serlo. Es exactamente la tercera casilla de la que hablábamos en el artículo sobre auditar un sitio contra su propio código: no un error, sino una afirmación correcta hoy que nadie está vigilando.
Lo que hicimos con eso fue lo mínimo honesto: escribirlos aquí, y dejar los dos números medibles con un comando.
Lo que queda
El siguiente paso evidente sería recuperar por secciones en vez de por páginas: si el índice ya conoce los encabezados, traer solo la sección relevante recortaría tanto el texto añadido como el segundo de latencia que cuesta procesarlo.
No lo hemos hecho, y el motivo es que todavía no tenemos datos que lo justifiquen. Con la mediana de página en 4.013 caracteres, traer la página entera cuesta poco y da al modelo el contexto de alrededor, que a veces es justo lo que hacía falta. Cuando las métricas digan que estamos trayendo páginas grandes para responder preguntas pequeñas, será el momento.
Mientras tanto, el diseño se puede resumir en una frase: el prompt lleva el mapa y el modelo pide el territorio cuando lo necesita. Y la parte que no aparece en ningún diagrama es que sabemos lo que cuesta, porque lo medimos.