Blog
Del blog
Guías prácticas de Kubernetes, operaciones a escala y notas desde la construcción de KubeBolt.
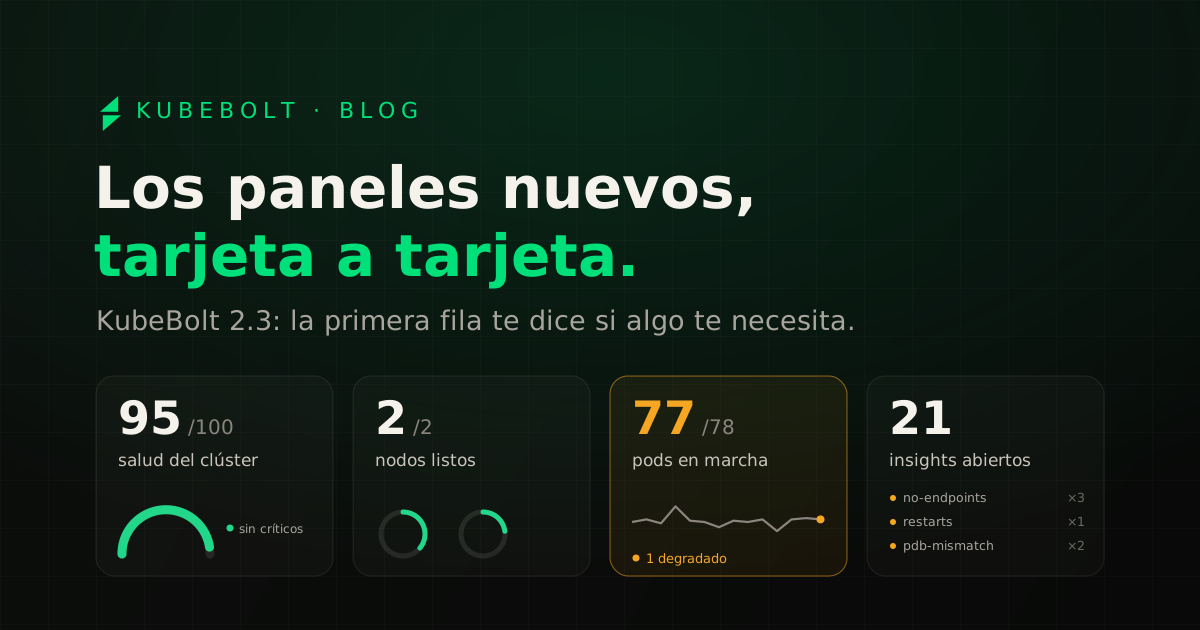
Los paneles nuevos de KubeBolt 2.3, tarjeta a tarjeta
En la 2.3 rehicimos casi todos los paneles de KubeBolt. Cada uno empieza con una fila de tarjetas con su cifra y su gráfica. Te explico qué dice cada tarjeta de Overview, Fleet y Home, cuándo cambia de color y qué conviene mirar después.
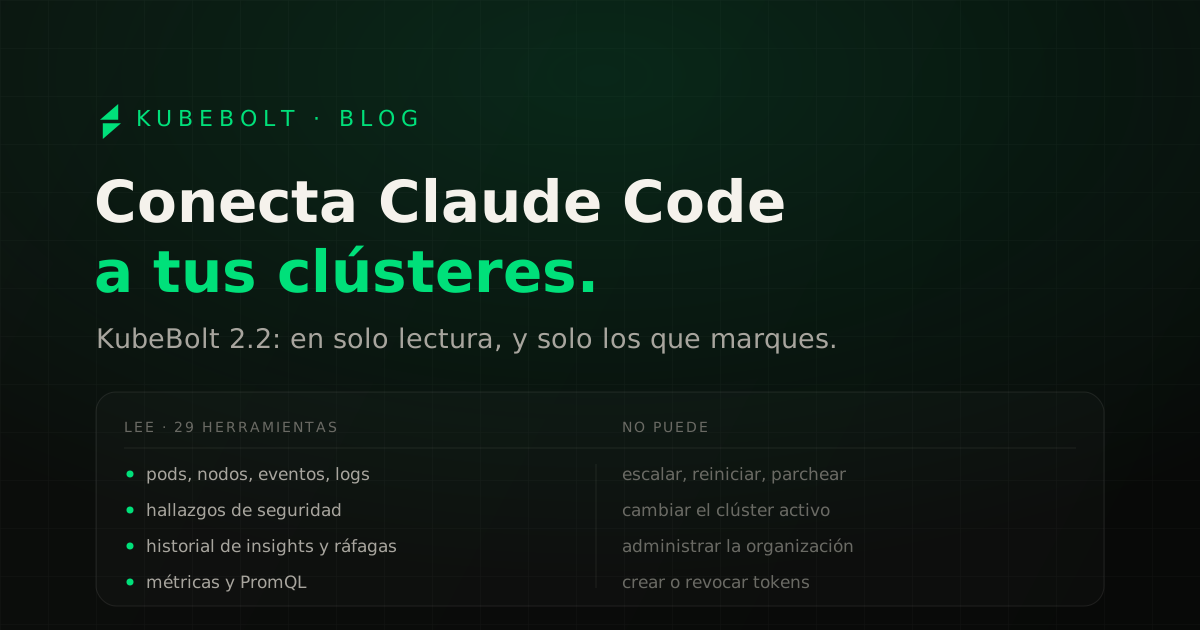
Conecta Claude Code a tus clústeres, en solo lectura
KubeBolt 2.2 estrena claves «MCP only»: llegan al servidor MCP y a nada más, con el rol fijado a lector y la lista de clústeres que tú marques. Veintinueve herramientas de lectura para el agente que ya tienes abierto, y trece de ellas son nuevas.
Una afirmación sin fuente no está bien: está sin comprobar
Tu código tiene pruebas. Tu infraestructura tiene detección de deriva. La frase de tu sitio que promete dónde viven los datos de tu cliente no tiene nada. Cotejamos nuestro propio sitio contra nuestro propio código fuente y no salió indemne. Este es el método, y por qué el hallazgo más peligroso no es el que te contradice.
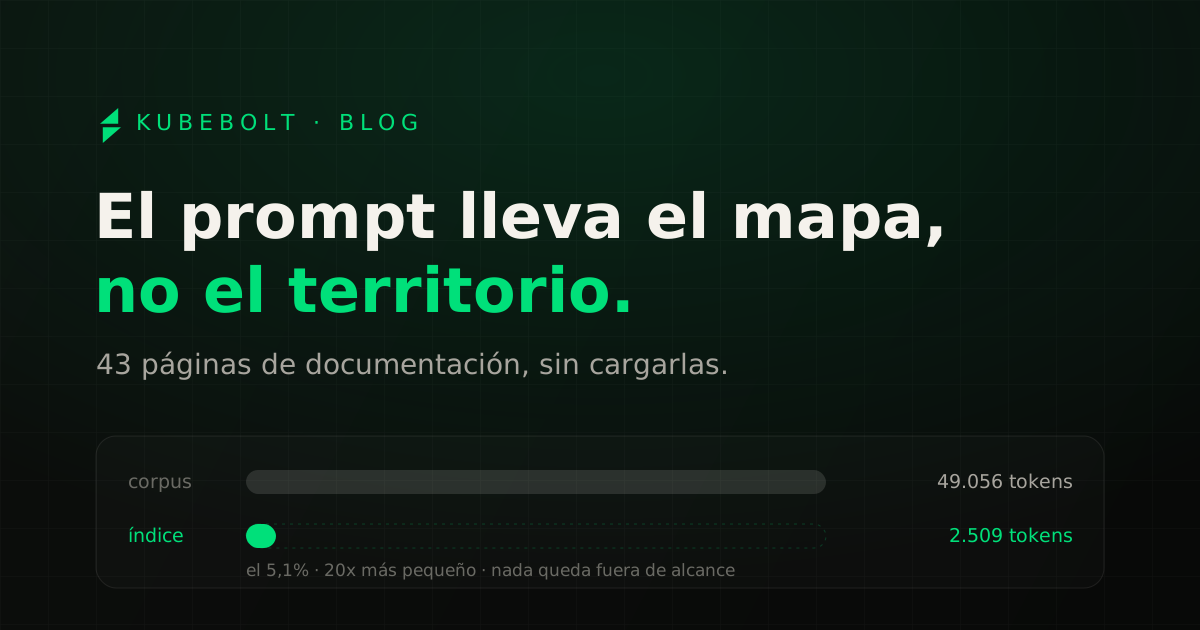
El prompt lleva el mapa, no el territorio: 49.000 tokens de documentación en 2.500
Cuando le das documentación a un asistente, el instinto es pegarla entera. El instinto es malo, y el motivo no es el tamaño del contexto: es la caché. Kobi lleva un índice del 5% del corpus y trae la página entera solo cuando la pregunta la necesita. Esto es lo que costó, con la factura de latencia incluida.
Detectar sin recordar es solo ruido: KubeBolt 2.1 le da memoria a los insights
Un insight que se enciende y se apaga no te dice si es un incidente o un patrón. En 2.1 cada detección abre un episodio durable con su línea de tiempo, su recurrencia contada y su política por entorno. Y el producto avisa cuando su propia voz está apagada.

Tres LLMs son mejor que uno: optimización de costo en AI Ops
Usar un solo modelo grande para cada incidente quema dinero. Así enruta KubeBolt entre una capa determinística, Haiku, Sonnet y Opus para resolver incidentes de punta a punta por menos de $1 cada uno.

El costo oculto de los precios por usuario en observabilidad
La mayoría de las herramientas de observabilidad cobran por usuario activo y por host. El resultado: tu factura escala con el headcount, no con el sistema que de verdad operas. Aquí está la matemática, y por qué el precio por recurso lo cambia.

Un motor de operaciones autónomas para Kubernetes: la arquitectura de 6 capas
La mayoría de las herramientas de AI Ops son cajas negras que devuelven respuestas mágicas. Así construimos lo contrario: un motor de seis capas donde una Capa 1 determinística resuelve la mayoría de los incidentes sin una sola llamada al LLM, y el LLM nunca toca tu cluster directamente.

Por qué construimos otra herramienta de Kubernetes en 2026
El mercado de observabilidad parece saturado (Datadog, Grafana, New Relic). ¿Entonces por qué construir KubeBolt? Porque hay un hueco que ningún incumbente puede llenar sin reescribir su producto.

Errores comunes de Kubernetes y cómo solucionarlos
Guía práctica de los errores más comunes de Kubernetes (CrashLoopBackOff, ImagePullBackOff, OOMKilled, pods en Pending y fallos de probes) con los comandos kubectl para diagnosticar y resolver cada uno.

Construimos KubeBolt open source primero
El open source no es solo un go-to-market para herramientas de infraestructura: es un pacto con tus usuarios. Por qué sacamos KubeBolt como Apache 2.0 y qué prometemos que seguirá así.

Cómo automatizar la resolución de incidentes en Kubernetes
Las alertas te dicen que algo se rompió, no lo arreglan. Un repaso práctico de los niveles de automatización de incidentes en Kubernetes, de los runbooks a la remediación autónoma, y cómo hacerlo de forma segura.