Hay una diferencia enorme entre un producto que detecta y un producto que recuerda, y casi nadie la nota hasta que lleva unos meses conviviendo con el primero.
Un detector te enseña una luz. El pod entra en crash loop, la luz se enciende. El pod se recupera, la luz se apaga. A las tres semanas alguien pregunta en la reunión si eso de payments-api es normal, y la respuesta honesta es que nadie lo sabe. Puede que haya pasado una vez. Puede que lleve pasando todos los martes desde el despliegue de junio. La luz no guarda nada, así que la memoria del sistema es la memoria de quien estaba mirando.
KubeBolt 2.1 es el release donde eso deja de ser así. Siete versiones separan este trabajo del anterior, y la mayoría fueron afinado y endurecimiento. El salto está en una idea sencilla: una detección no es un evento, es el principio de una historia.
Lo que eso trae, en cinco líneas:
- Cada detección abre un episodio durable, con su línea de tiempo y su recurrencia contada.
- El Home te da un parte de turno de lo que pasó mientras no estabas.
- Las reglas se ajustan por clase de entorno, y lo que apagas se sigue contando.
- Los silencios llevan expiración y razón escrita, y quedan en la auditoría.
- El producto declara sus propias lagunas cuando estuvo mudo.
Y una mejora que probablemente pague el mes de alguien: el agente 1.4.0 baja las series activas de un clúster real de 437.000 a 145.000.
La luz que parpadea no es una señal
El problema de la detección sin memoria no es filosófico, es operativo, y se manifiesta en tres momentos concretos.
- La guardia. Entras a las nueve de la mañana después de una noche que no viste y el panel está en verde. ¿Significa que no pasó nada, o que pasó algo y se recuperó solo? Un panel de estado no distingue esos dos casos, porque solo sabe describir el ahora.
- La revisión. Quieres decidir si merece la pena invertir dos días en arreglar la causa raíz de algo, y para eso necesitas saber cuántas veces ha ocurrido. Sin historial, esa conversación se resuelve con anécdotas: “a mí me pasó el otro día”, “yo creo que va a más”. No es una base para priorizar.
- El ruido. Cuando una regla te molesta, la única herramienta que suele haber es apagarla. Y al apagarla pierdes también la información de cuántas veces se habría disparado, con lo cual nunca sabes si la apagaste con razón o si acabas de dejar de mirar algo que empeoró.
Los tres se arreglan con lo mismo: darle a cada detección una identidad que sobreviva al parpadeo.
Un episodio, no una luz
En 2.1 cada insight abre un episodio: una fila durable con su línea de tiempo completa, en lugar de un booleano que cambia de valor.
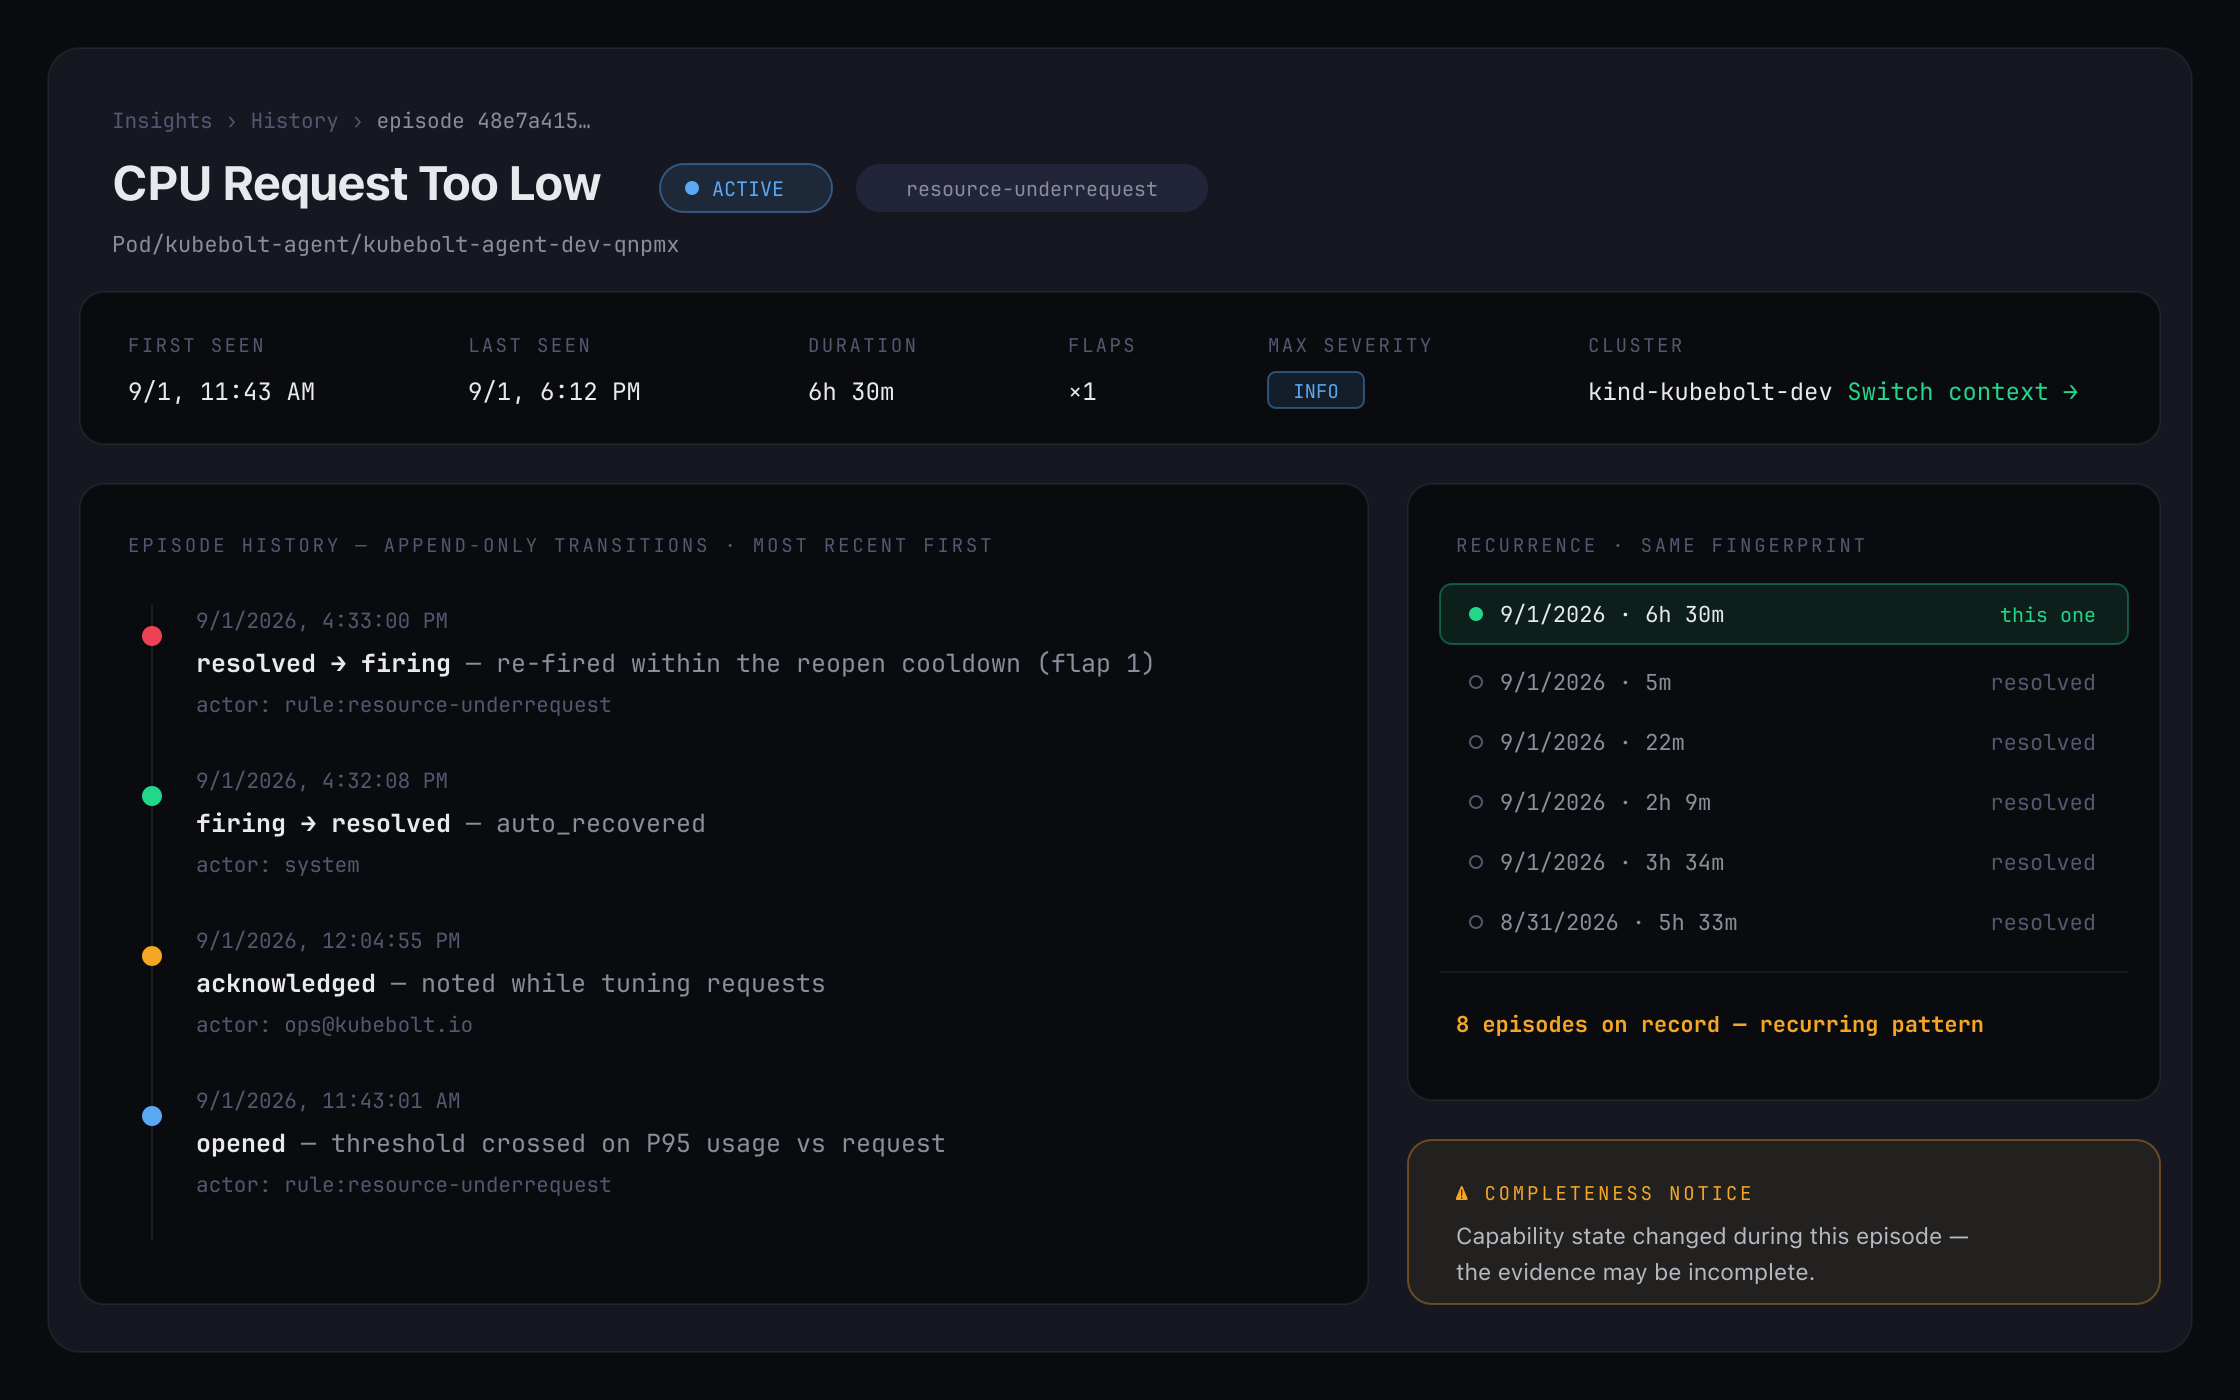
La línea de tiempo es de solo añadir. Abierto, reconocido, silenciado, resuelto, expirado. Cada transición queda escrita con su hora y no se sobrescribe, así que el episodio se puede leer entero después, no solo mientras está vivo. Hay amortiguación de rebotes para que un pod que oscila no genere cuarenta episodios, y un vigilante que cierra por expiración lo que dejó de tener sentido.
Encima de eso va lo que de verdad cambia las conversaciones: la recurrencia por huella. Cuando el mismo problema vuelve, no abre un episodio huérfano; se cuenta contra los anteriores. La vista lo dice con todas las letras: “8 episodios registrados: patrón recurrente”. Eso convierte una sospecha en un dato, y la pregunta de la reunión pasa de “¿esto es normal?” a “¿arreglamos la causa o seguimos absorbiéndolo?”.
El histórico tiene su propia pestaña, con filtros y paginación en servidor, y la retención que corresponda a tu plan. Y hay un detalle del que estamos particularmente satisfechos: si durante un episodio cambió alguna capacidad del producto, la evidencia lo declara. Un aviso de completitud te dice que ese tramo puede estar incompleto, en vez de presentarte un relato con agujeros como si fuera entero.
Entras y el producto te cuenta tu ausencia
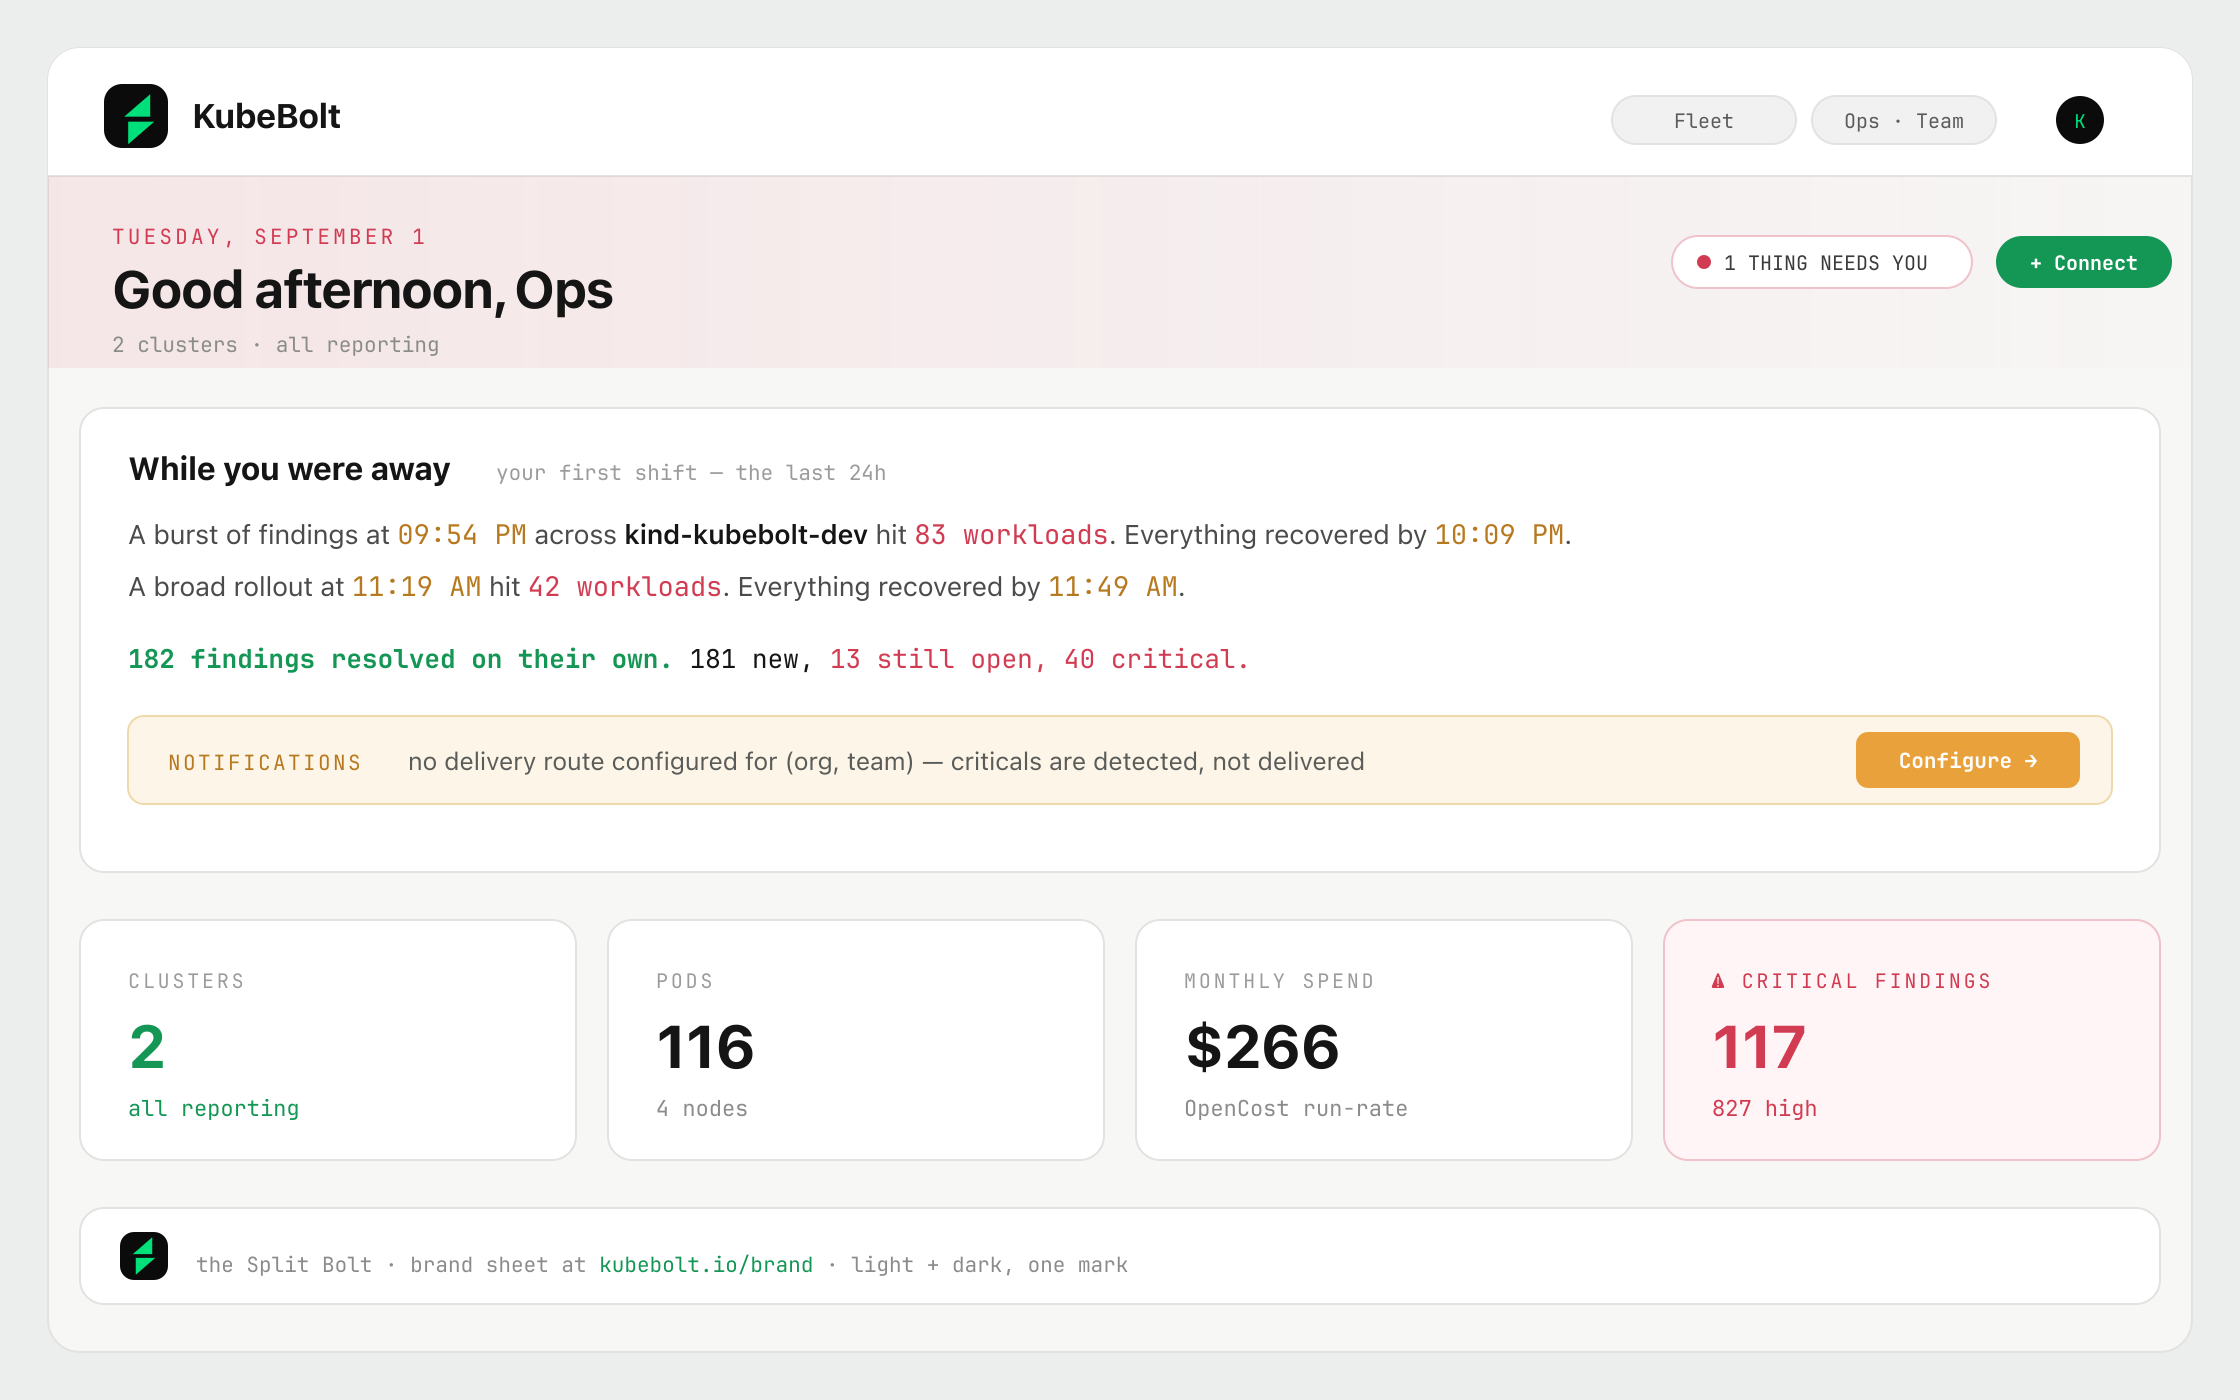
El saludo del Home dejó de ser decorativo. Ahora es un parte de turno de lo que pasó mientras no estabas.
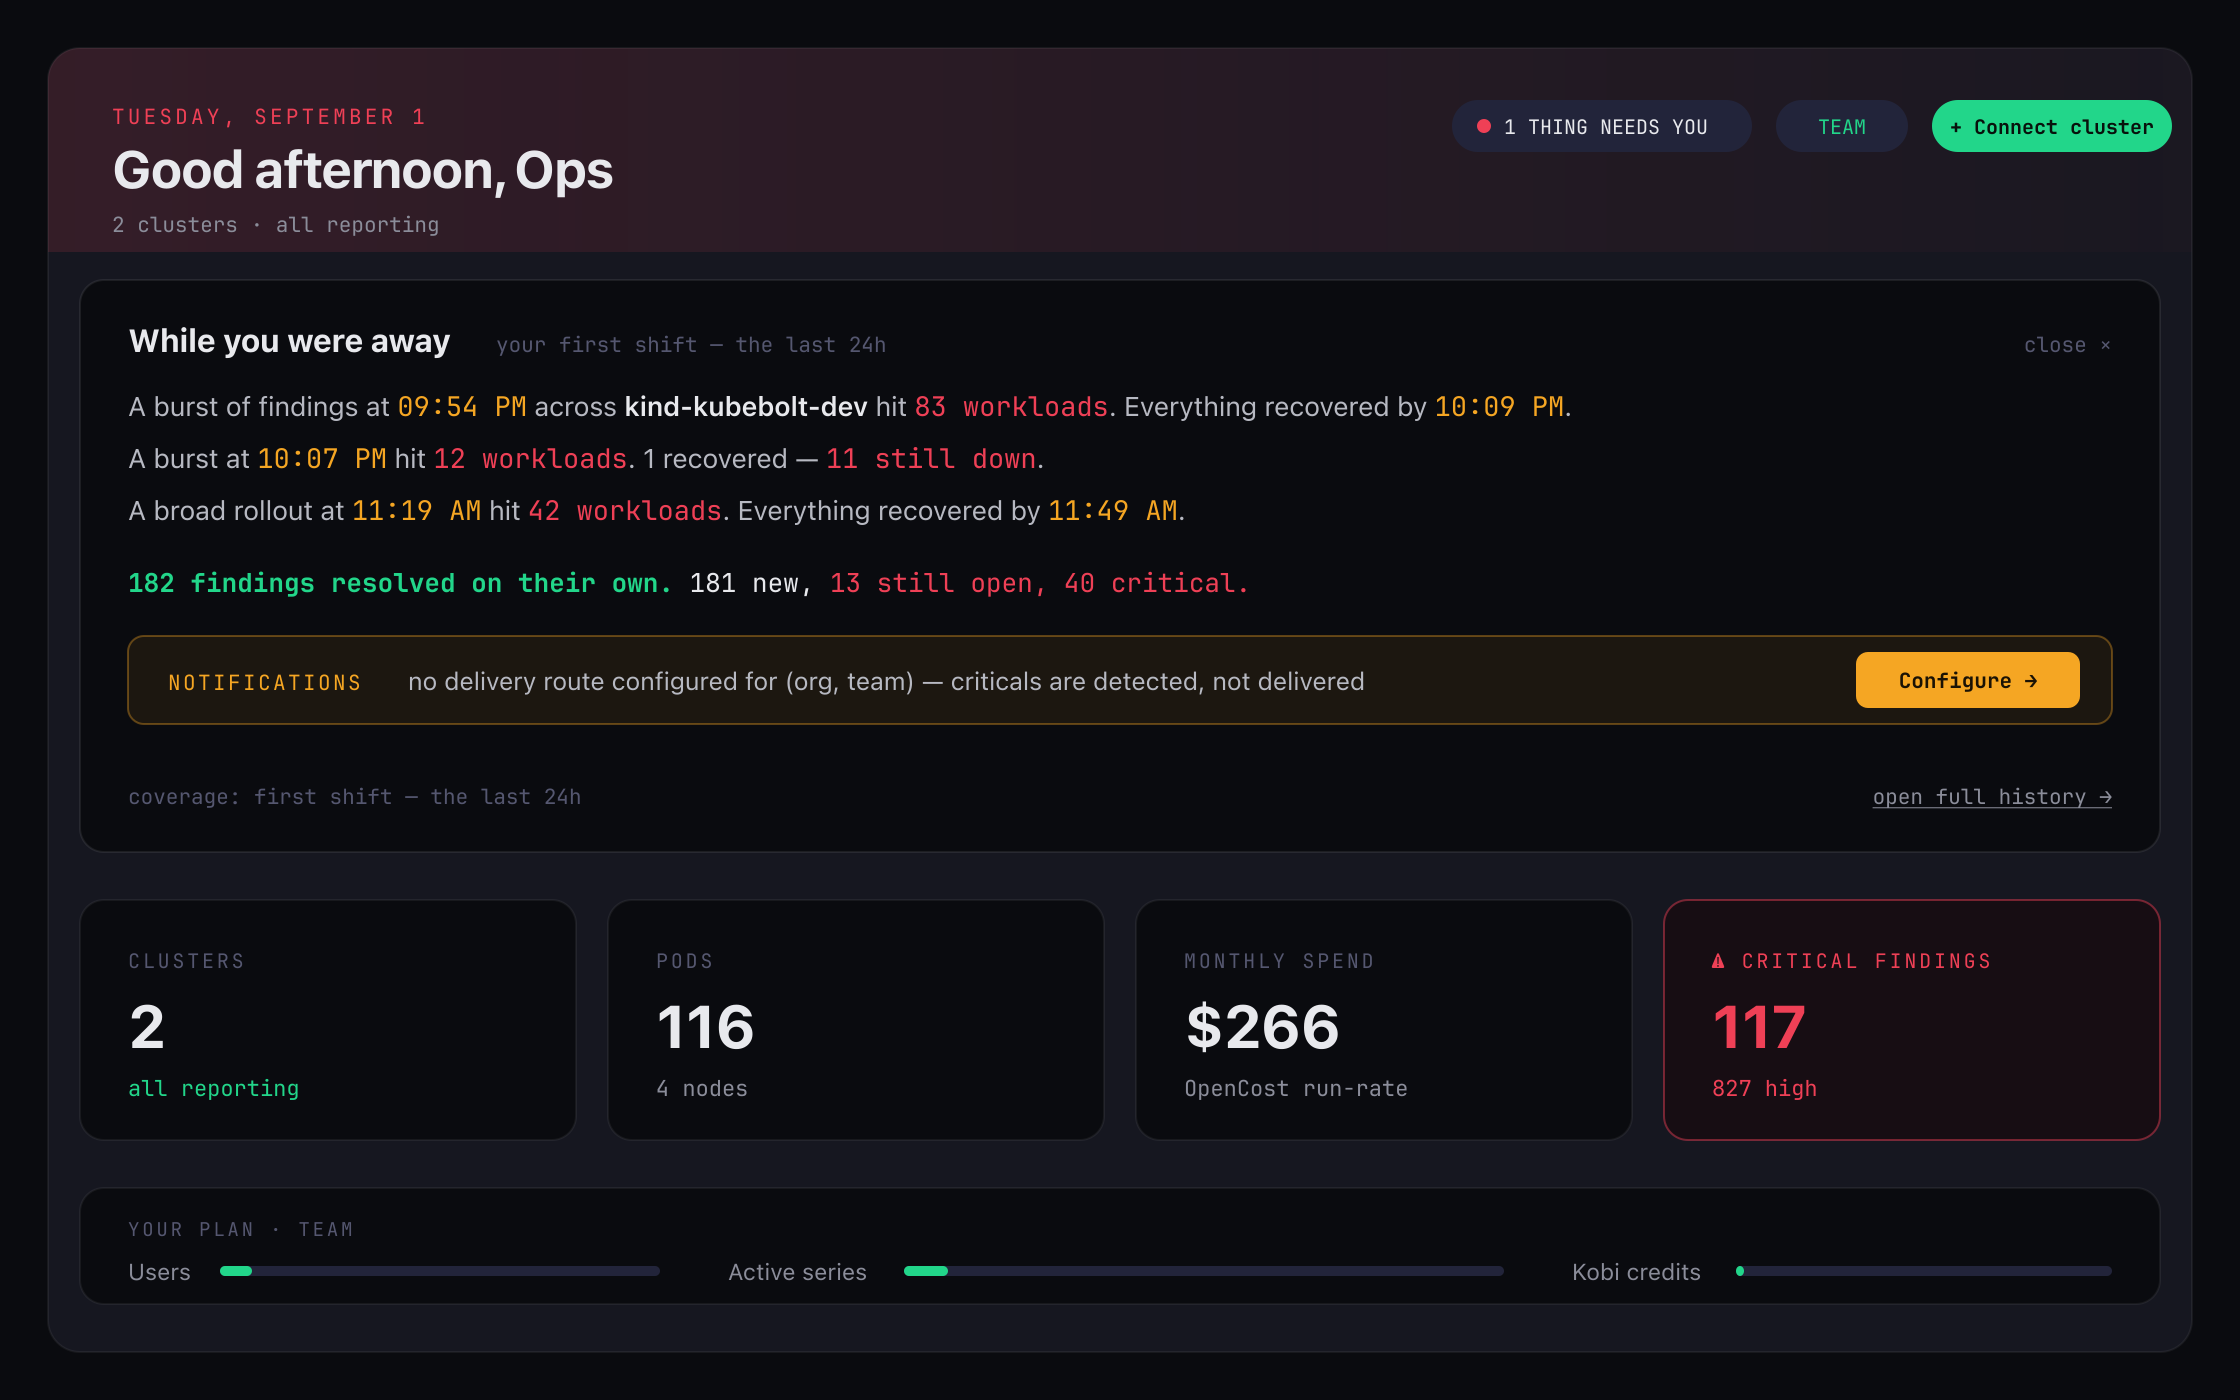
No es una lista de findings. Es una narración: qué golpeó, a cuántos workloads, a qué hora, qué se recuperó solo y qué sigue caído, con el peor episodio enlazado para que puedas entrar directamente. El agrupado es determinista, así que la misma ventana de tiempo produce siempre el mismo relato; no depende de cuándo abras la página.
Lo que más nos gusta de esta pieza es lo que hace cuando no hay nada que contar: se calla. Si en tu ausencia no pasó nada, no rellena el hueco con métricas de estado. Un parte que siempre dice algo deja de leerse a la semana.
Ajusta la expectativa, no el volumen
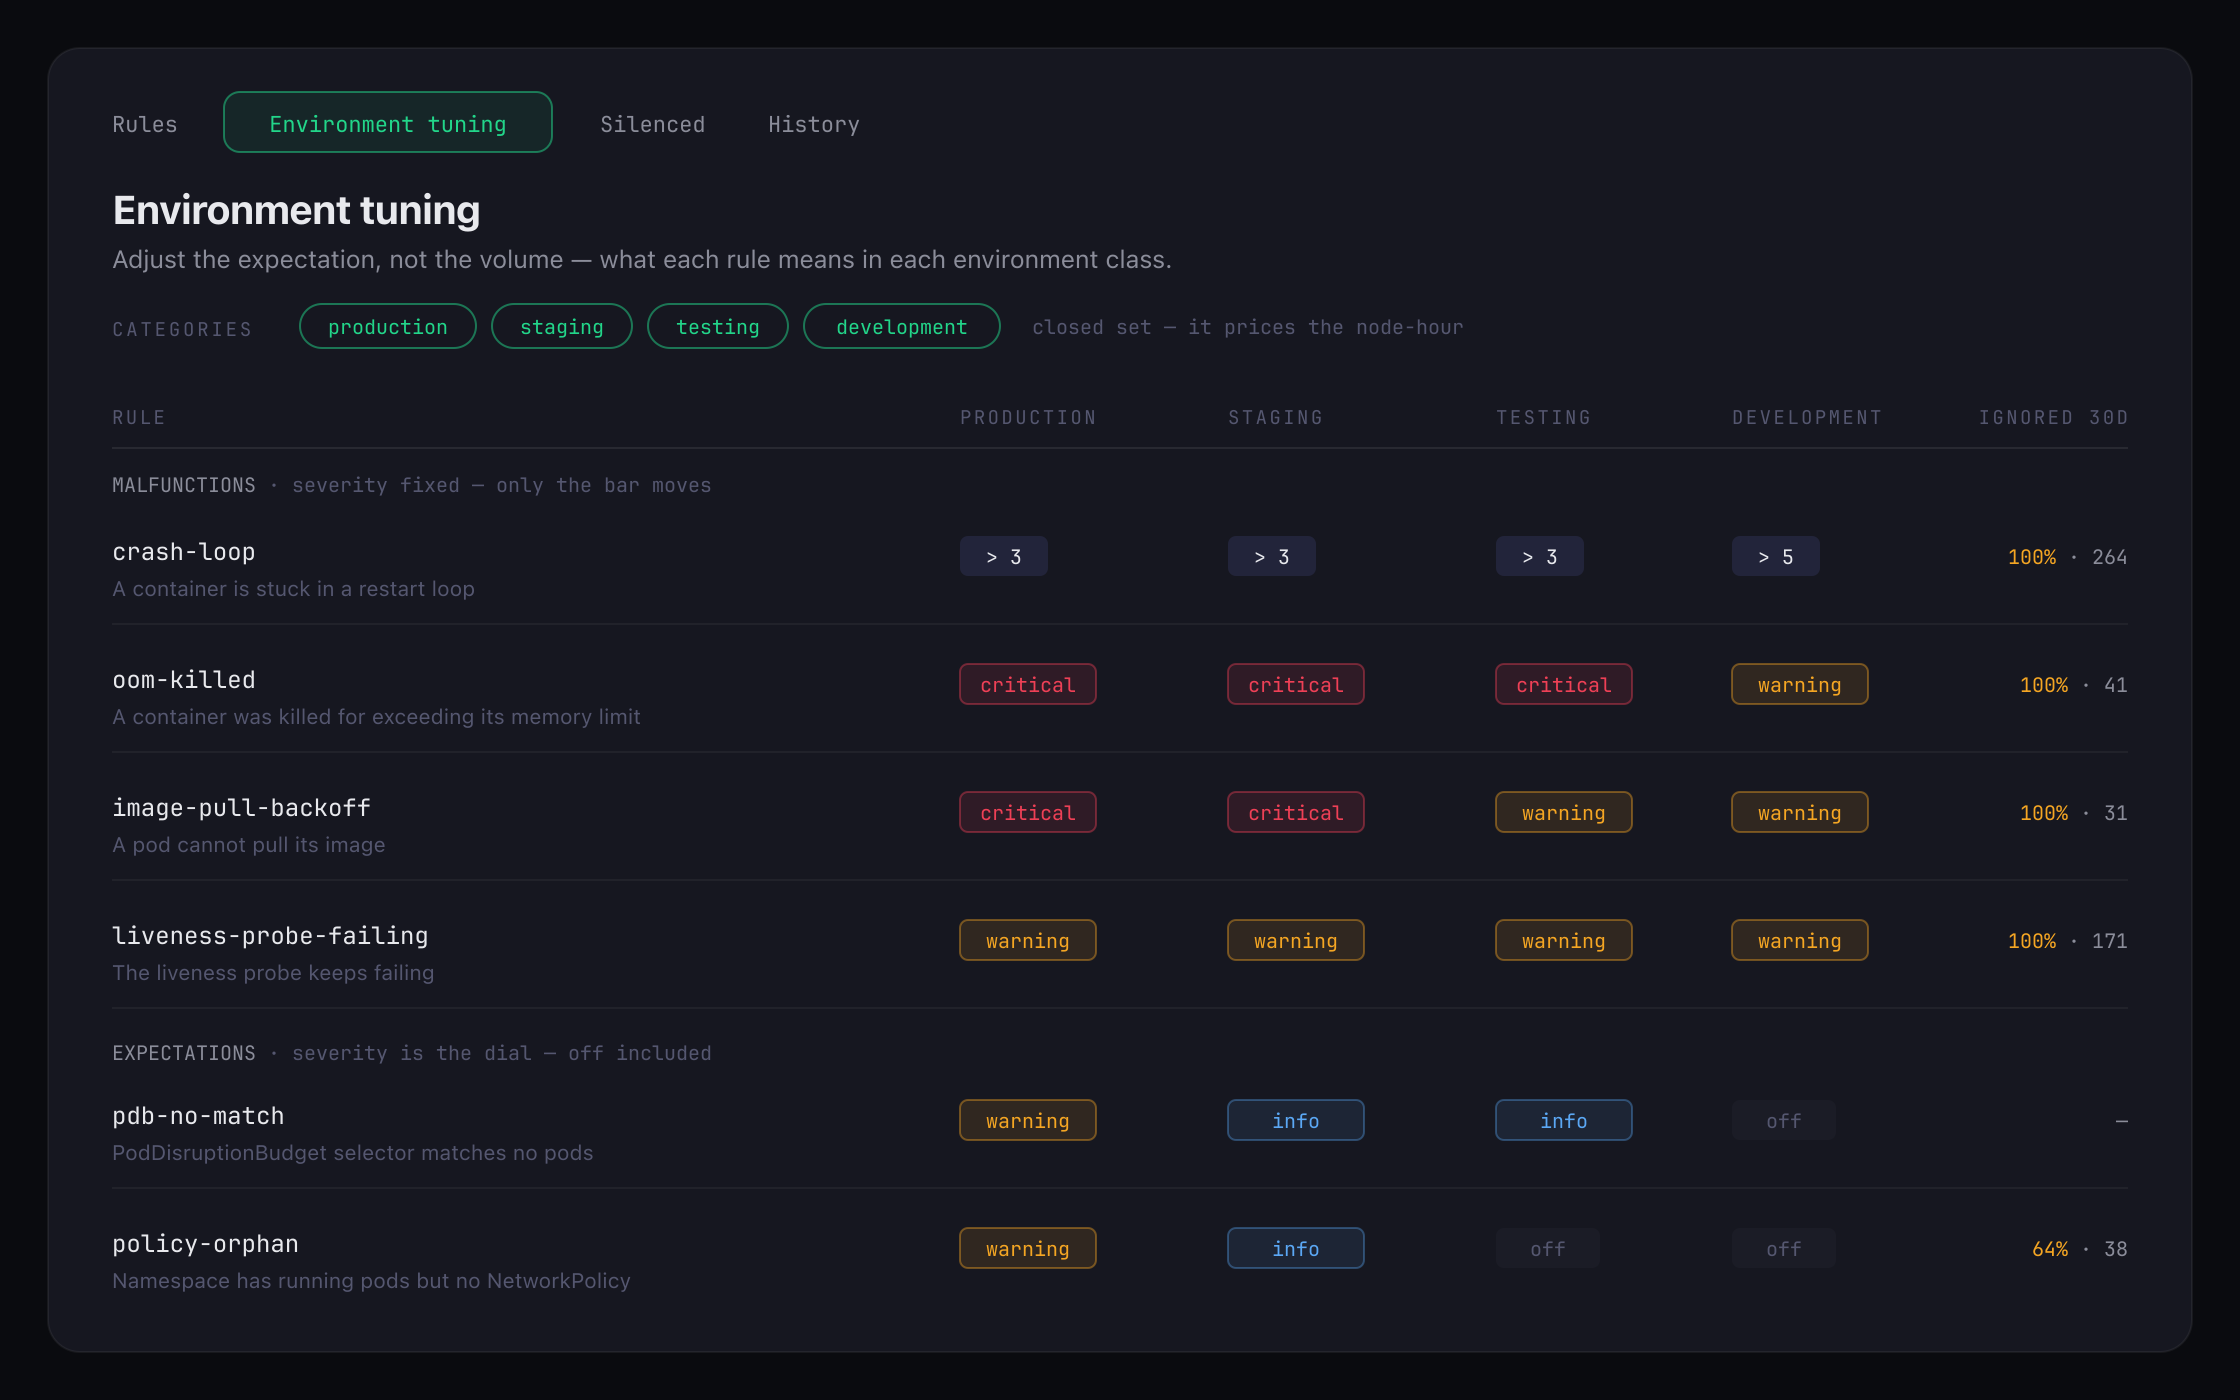
Aquí es donde 2.1 se pone opinionada. Las reglas se parten en dos familias que se gobiernan distinto, porque no significan lo mismo.
| Malfunción | Expectativa | |
|---|---|---|
| Qué es | Algo roto: un crash loop, una imagen que no baja | Algo que tú defines: cuántas réplicas, qué latencia |
| Severidad | Fija | Es el dial |
| Lo que ajustas | El umbral | La severidad, apagar incluido |
| ¿Se puede apagar? | No | Sí |
Un crash loop no deja de ser un problema porque tú lo decidas, y por eso su severidad no se toca. Una expectativa la pones tú, y por eso apagarla es una opción legítima.
Sobre esa distinción va la matriz de entornos. Las capas se resuelven por clúster: la clase de entorno manda sobre el ajuste global, y el ajuste global manda sobre el valor de fábrica. Producción, staging, testing y desarrollo pueden tener expectativas distintas para la misma regla, que es exactamente como funciona la cabeza de quien opera.
Y luego está la columna que más nos costó decidir y de la que estamos más contentos: “Ignored 30d”. Lo que apagas se sigue evaluando y contando. La vista te dice cuántos insights está ocultando ese ajuste, con el botón para revertirlo al lado. Apagar deja de ser un salto al vacío y pasa a ser una decisión con retroalimentación.
Los silencios son de primera clase: por clúster, regla y recurso, siempre con expiración o hasta que se resuelva. El silencio permanente exige una razón escrita, lo crítico los atraviesa, y todo queda en la línea de tiempo y en la auditoría con nombre y apellidos.
Un silencio anónimo y eterno es una deuda que alguien pagará a las 3am.
El producto avisa cuando su propia voz está apagada
La pregunta más incómoda que puede hacerte un cliente es “¿por qué no me enteré de esto?”. Casi siempre la respuesta es aburrida: las notificaciones no tenían ruta configurada, Autopilot estaba apagado, o la organización llevaba dos semanas por encima de un tope.
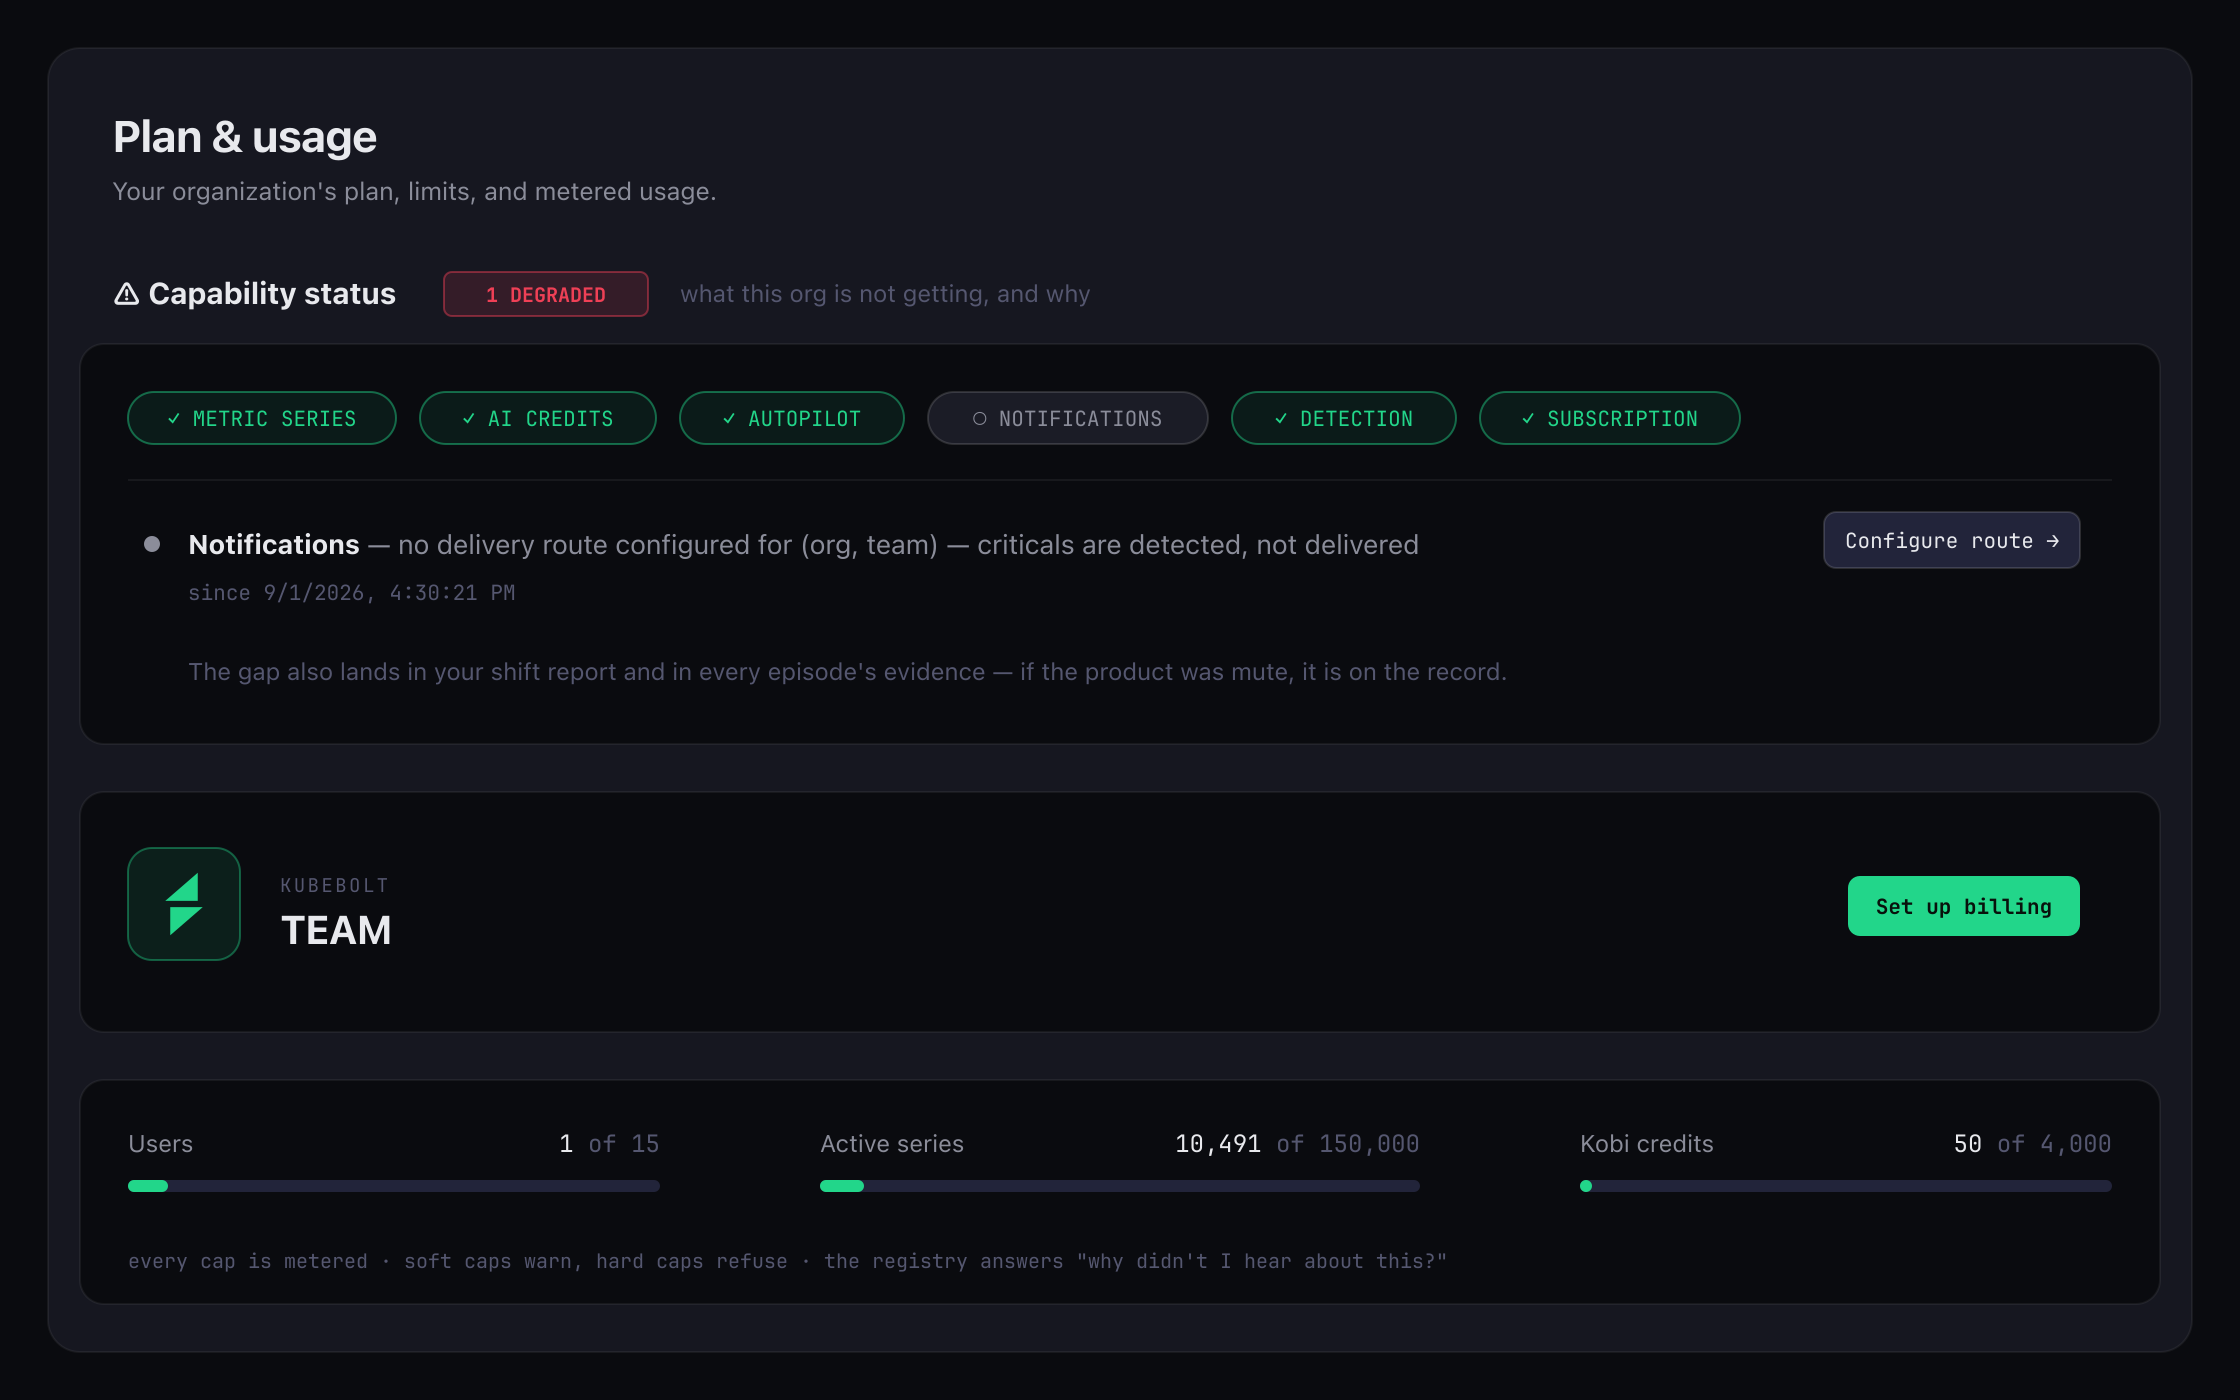
En 2.1 esa respuesta vive dentro del producto. Hay un registro de capacidades consultable por organización, con Autopilot, notificaciones, topes del plan y presupuesto de créditos, cada uno con su estado y desde cuándo lo tiene.
Y está pintado donde duele. Si no hay ruta de notificaciones, lo ves en el acto, con la frase que corresponde: los críticos se detectan, pero no se entregan. Con el botón para arreglarlo al lado. Esos huecos además viajan al parte de turno y a la evidencia de los episodios, así que si el producto estuvo mudo durante un tramo, queda escrito que lo estuvo.
Es la misma disciplina que aplicamos al postmortem y al registro de acciones de Autopilot: preferimos un sistema que admita sus lagunas a uno que presente un relato liso.
Lo que más se nota bajo el capó
De las siete versiones, hay una mejora que probablemente pagará el mes de alguien.
El agente 1.4.0 descarta de fábrica las interfaces veth que crean los CNI en la nube. En un AKS real de 2.183 pods eso era alrededor del 85 % de las series activas: de unas 437.000 a unas 145.000. En el plan Team, cuyo tope incluido son 150.000 series, es la diferencia entre un solo clúster comiéndose la cuota entera y que quepan tres o cuatro. Si operas KubeBolt, actualizar el agente es lo primero que haríamos.
El resto del trabajo fino se repartió entre Autopilot, Copilot y seguridad:
- Autopilot distingue lo externo por su dirección. Una base de datos Azure Postgres caída se nombra como dependencia externa y se escala a una persona, en vez de proponer recrearla dentro del clúster, que era una acción sin sentido. Y el diagnóstico ahora nombra el clúster cuando trabajas con una flota.
- El modo “solo sugerir” termina honesto. Un diagnóstico correcto cierra como recomendación lista a la vista, no como un fallo. Había un sesgo feo ahí: el modo más conservador era el que peor se veía en las métricas. Un backfill reclasificó el histórico.
- El postmortem exportado va firmado, con las fuentes tipográficas embebidas, así que se ve idéntico sin conexión. Y los créditos de Autopilot cuadran a la unidad en todas las vistas.
- Los PVC ganaron pestaña de monitorización, con espacio e inodos y umbrales en 85 y 95 %. Un volumen al 3 % de uso puede estar fallando cada escritura por agotamiento de inodos, y antes no había ninguna vista que te lo enseñara.
- Higiene de seguridad continua: el escaneo de imágenes corre antes de cada etiqueta, las oleadas de vulnerabilidades de la biblioteca estándar de Go se cerraron en el acto, y las exenciones de terceros llevan fecha de caducidad para que nadie herede una excepción eterna.
De paso estrenamos isotipo. El Split Bolt vive ya en la aplicación, el sitio, los favicons y el membrete del postmortem que exportas. La hoja de marca es pública en kubebolt.io/brand.
Lo que queda
La memoria abre puertas que todavía no hemos cruzado. Un episodio con recurrencia contada es la materia prima de una recomendación del tipo “esto te ha pasado ocho veces, el arreglo es este y cuesta un PullRequest”, y ahí es donde queremos llevar la remediación duradera.
Por ahora, lo que hay es más modesto y más útil: cuando entras por la mañana, el producto te cuenta lo que se perdió, con horas, con historia y sin fingir que lo vio todo.
Si operas KubeBolt Cloud, tu parte de turno ya te está esperando en el Home. Si todavía no, empieza gratis: dos clústeres, sin límite de tiempo.