Ya tienes un agente abierto todo el día. Lo que no tiene es contexto de tu producción.
Así que haces de puente tú: le pegas un YAML, le describes de memoria lo que acabas de ver en un panel, copias media pantalla de kubectl describe y le pides que razone sobre un clúster que no puede mirar. Funciona a ratos, y falla justo cuando importa, porque lo que le llega es lo que a ti se te ocurrió copiar.
Desde la 2.2 puede mirarlo. Creas una clave MCP only, marcas los clústeres a los que llega, la pegas en tu cliente, y tu agente lee tu flota con las mismas veintinueve herramientas de lectura que usa Kobi. No puede tocar nada: el rol va fijado a lector en el servidor, pida lo que pida la petición.
Cinco minutos: crear la clave y conectarla
En Administration → API tokens, al crear la clave, hay una opción nueva de alcance.
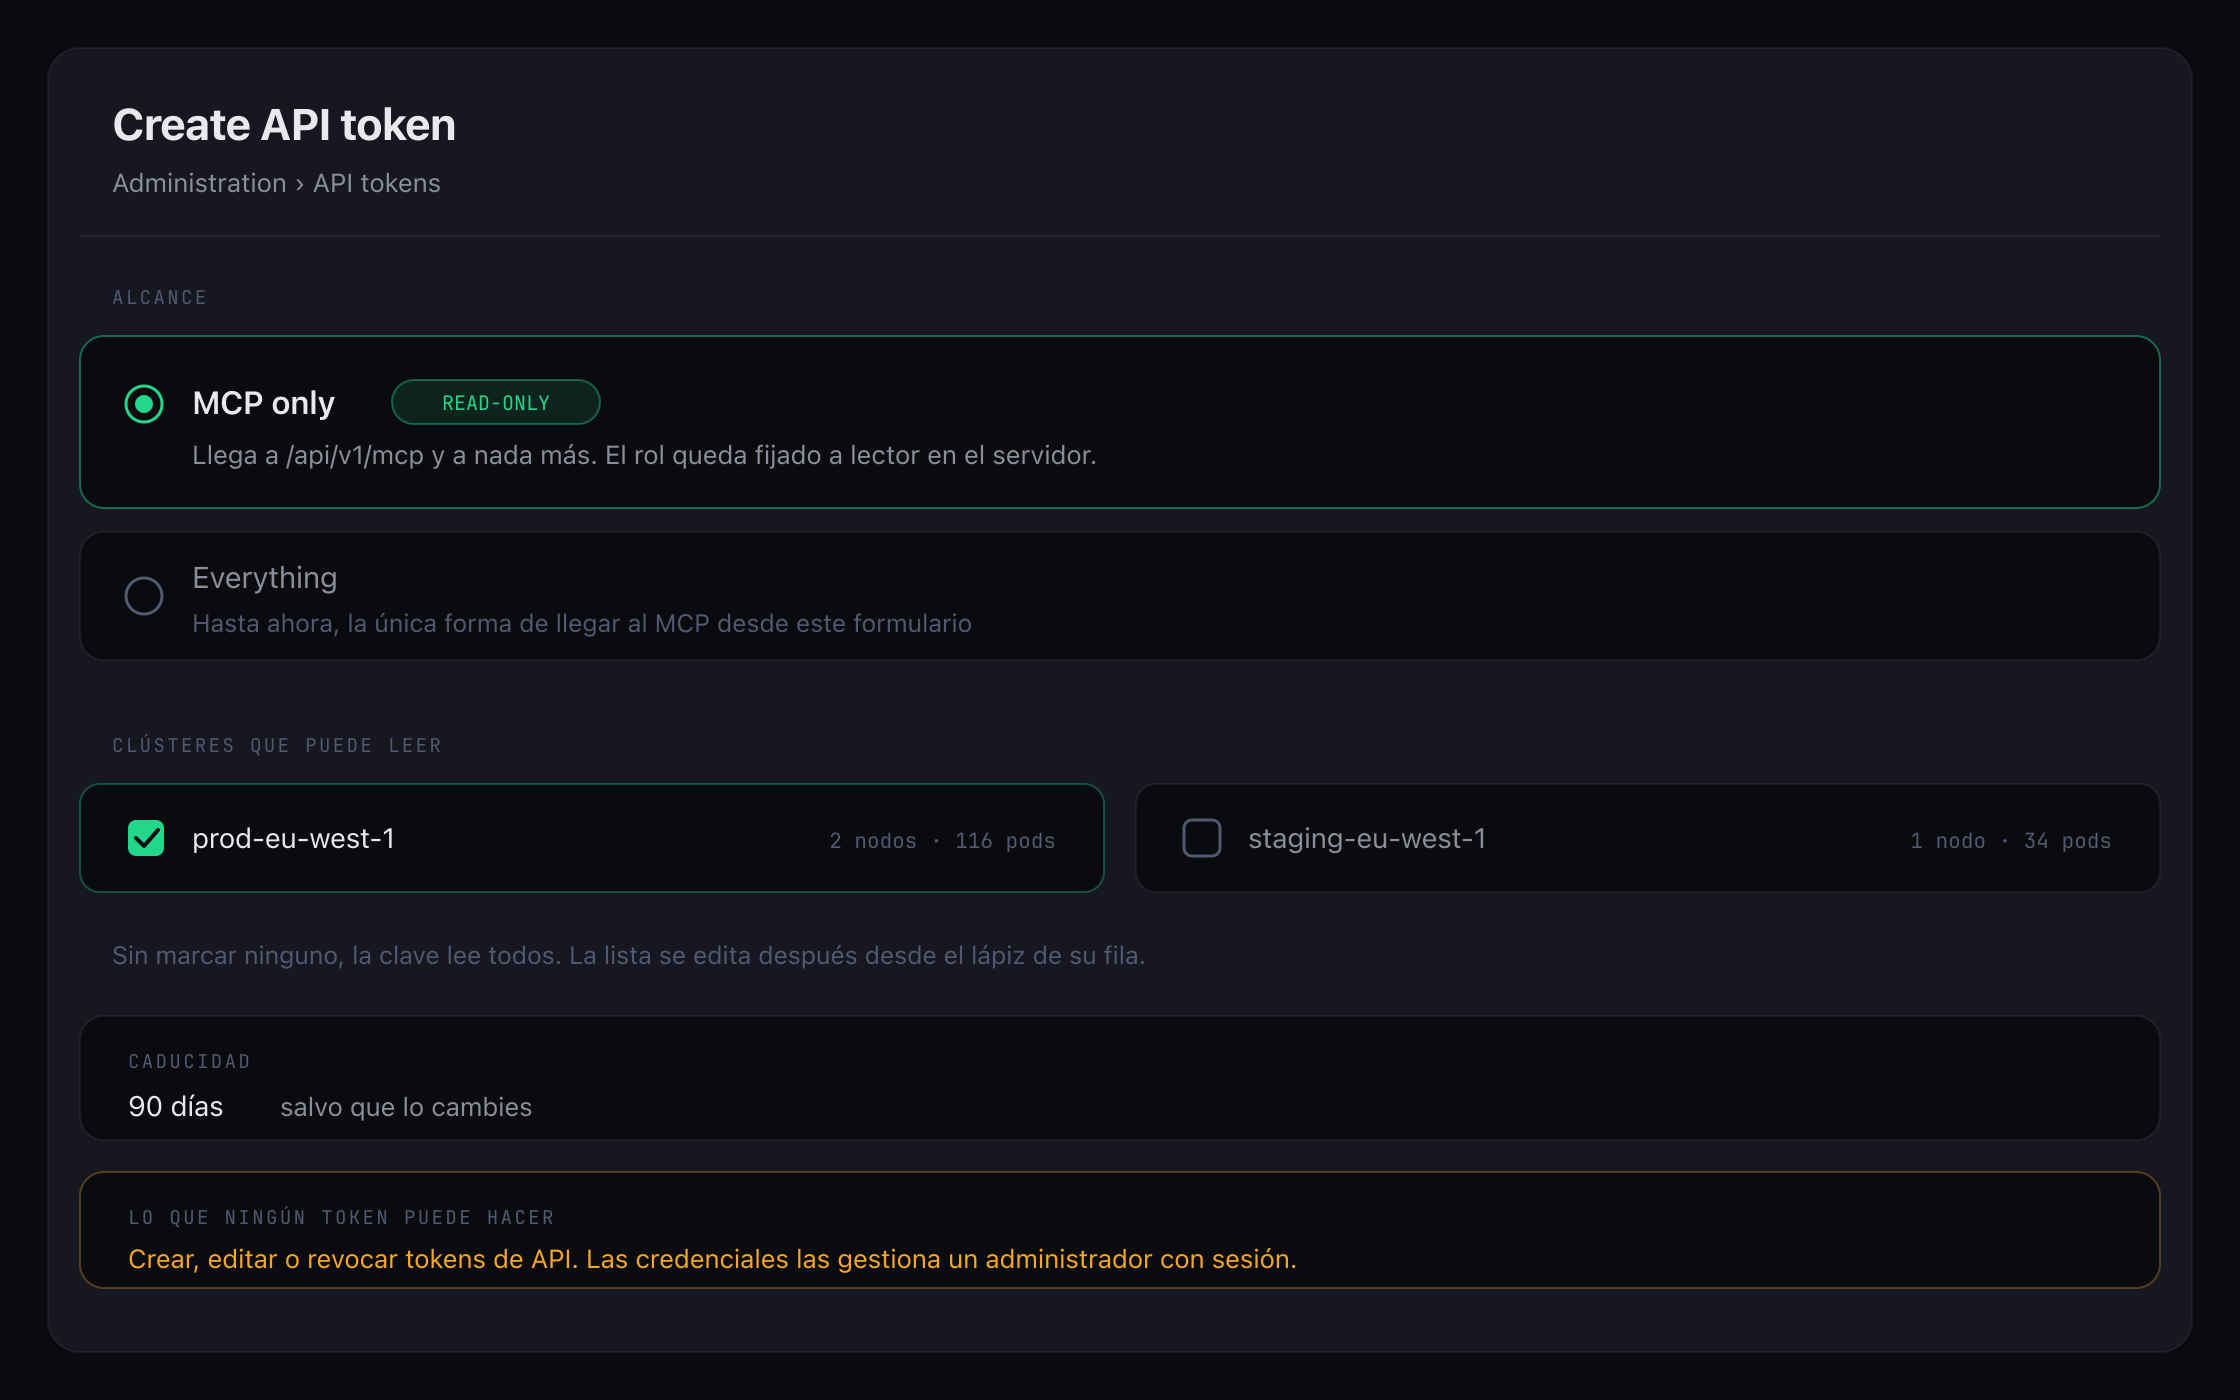
MCP only (read-only tools) hace tres cosas a la vez: la clave llega a /api/v1/mcp y a ninguna otra ruta, su rol queda fijado a lector en el servidor (no en el formulario, en el servidor), y caduca a los noventa días salvo que lo cambies. Debajo marcas los clústeres a los que puede llegar; si no marcas ninguno, llega a todos los de tu organización.
Hasta ahora la única forma de alcanzar el servidor MCP desde ese formulario era la opción Everything, que entrega la API entera a una clave que solo necesitaba leer. Si montaste un cliente así, vale la pena cambiarla.
Luego, en tu cliente. El servidor habla Streamable HTTP en POST /api/v1/mcp, así que la configuración es la de cualquier servidor MCP remoto:
{
  "mcpServers": {
    "kubebolt": {
      "type": "http",
      "url": "https://tu-kubebolt/api/v1/mcp",
      "headers": { "Authorization": "Bearer kbk_…" }
    }
  }
}
En Claude Code es una línea:
claude mcp add --transport http kubebolt https://tu-kubebolt/api/v1/mcp \
  --header "Authorization: Bearer kbk_…"
Y si trabajas con varios clústeres, añade X-KubeBolt-Cluster: <nombre-de-contexto> para fijar uno. Sin esa cabecera contesta el clúster activo, que dentro de la lista del token no se mueve a mitad de conversación.
Hay un detalle que cuesta un rato descubrir por las malas, así que va en tabla:
| Tu cliente llega a KubeBolt por… | Token | Por qué |
|---|---|---|
| La URL de la interfaz (el nginx que trae el chart o el Compose) | Clave de API kbk_ con MCP only | El nginx marca toda petición como pública, y ahí los tokens de servicio se rechazan por diseño |
| La API directamente, desde dentro de tu red | kbk_ o token de servicio kbs_ | Un kbs_ ya trae /api/v1/mcp en sus scopes por defecto |
Que un token de servicio filtrado no sirva desde internet es deliberado. Si tu agente corre en tu portátil, la clave que quieres es la kbk_.
Y existe una tercera vía sin servidor de por medio: el binario kubebolt-mcp habla MCP por entrada y salida estándar contra tu kubeconfig, sin autenticación y sin backend. Para una exploración local, es lo más corto.
Qué ve tu agente ahí dentro
Veintinueve herramientas de lectura, y trece son nuevas en esta versión. Esa es la otra mitad del release: hasta la 2.2, tanto Kobi como un cliente externo leían los objetos vivos del clúster y poco más. El producto ya sabía el resto y no lo dejaba preguntar.
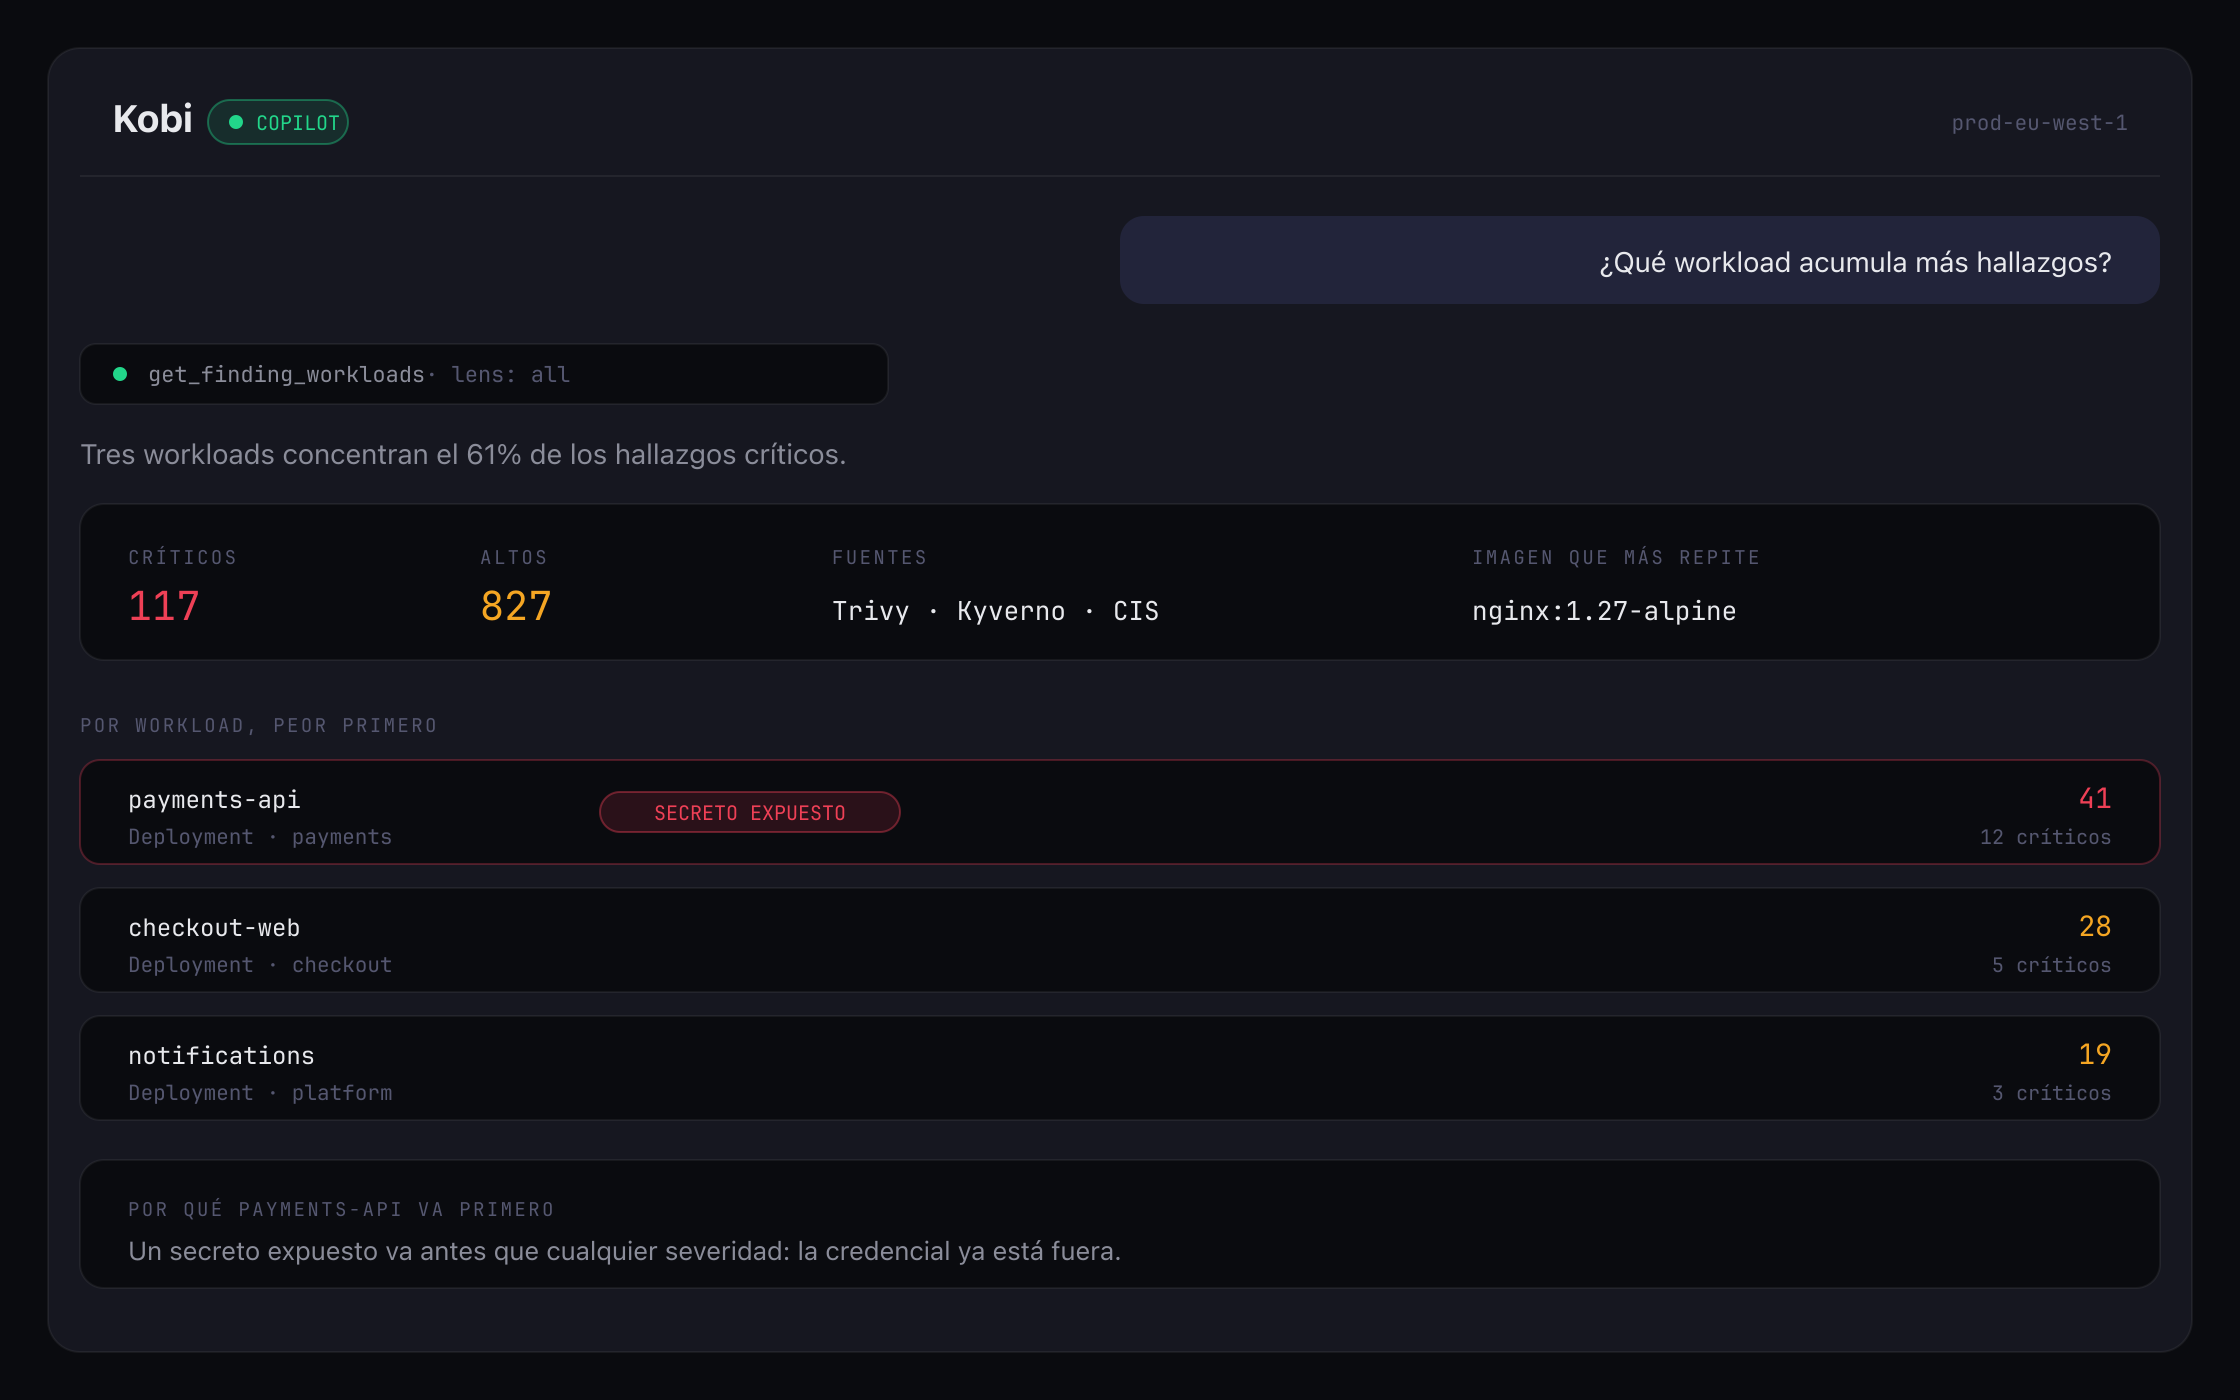
- Seguridad: la postura entera del clúster (Trivy, Kyverno, CIS), los hallazgos ordenados por workload según la lente que mires, un hallazgo concreto releído en vivo de su escáner, y los eventos de Falco. El filtro por imagen acepta la forma corta,
nginx:1.27-alpine, contra la referencia completa que guarda el escáner: la coincidencia exacta no encontraba nada, y «nada» se lee como imagen limpia, que es justo la pregunta que se hace antes de un rollback. - Historial: los episodios de insight que estrenó la 2.1, y las ráfagas. Un agente que pregunta por un pod caído puede preguntar antes si media docena de cosas se cayeron con él.
- Qué cambió justo antes: los rollouts de las últimas horas, con imagen y edad. Y declara lo que no alcanza a ver, para que una lista vacía no se lea como «no cambió nada».
- Métricas y capacidad: PromQL instantáneo o por rango, el rightsizing que hay detrás de la pantalla de Capacity, el sistema de ficheros del nodo, y la cobertura.
Esa última merece su línea. get_coverage cuenta qué puede y qué no puede ver KubeBolt en ese clúster: qué fuentes de métricas están activas, qué agentes están conectados y por dónde, y dónde están los huecos. Existe para que «no veo datos» nunca se confunda con «no hay nada», que es la diferencia entre un agente prudente y uno que te da una conclusión con el mismo aplomo tenga datos o no.
Todas contestan desde donde está guardado el dato, no desde el clúster, así que un clúster caído sigue teniendo historia. Y mientras la conexión viva está momentáneamente ida, initialize y tools/list siguen respondiendo: la sesión de tu cliente no se cae, solo te dice que para esa llamada concreta necesita el clúster en línea.
Qué no puede hacer, y por qué es un alivio
La mitad que convence de todo esto no es el alcance, es el límite. Una clave que solo lee es la única que puedes pegar sin pensarlo en un cliente cuyo bucle de decisión no controlas del todo.
Las nueve herramientas que proponen cambios (escalar, reiniciar, parchear recursos o sondas) no están en el catálogo ni se pueden invocar por nombre. No es una comprobación de permisos que podría fallar abierta: sencillamente no existen en esa superficie.
Un agente que no puede escribir no necesita que confíes en su criterio, solo en su lectura.
Encima de eso van cuatro cosas más, y todas se comprueban en el servidor:
- La lista de clústeres del token se mira antes que cualquier atajo y en todos los caminos de lectura, incluidos los que no nombran clúster y las propias listas:
GET /api/v1/clustersylist_clustersnombran solo lo que esa clave puede leer. - Ningún token puede tocar los tokens.
/api/v1/admin/api-tokensestá cerrado a cualquier clave, diga lo que diga su alcance. Las credenciales las gestiona un administrador con sesión, así que una clave filtrada no puede fabricarse otra más ancha. - El PromQL que escribe quien llama se queda en su clúster, y ahora lo acota el propio almacén de métricas sobre la consulta ya interpretada. Antes lo hacía un reescritor de texto, y se le colaban tres formas: los nombres de métrica desnudos como
up, los selectores con una etiqueta señuelo que contenía el nombre reservado, y los or-filters de MetricsQL, donde el anclaje ataba solo la primera rama. Sobre un VictoriaMetrics compartido, esas tres leían series de otros clústeres. - Los resultados van redactados. Los secretos que aparecen en logs, variables de entorno, líneas de comando, salidas de
describey eventos se enmascaran antes de llegar al modelo, con los mismos detectores tanto si quien pregunta es el chat como si es tu cliente. Las tiras hexadecimales puras, como un identificador de traza, se dejan en paz.
El mismo catálogo alimenta a Kobi y a Autopilot
Lo que hace que esto no sea una integración más es de dónde sale. No hay un catálogo para el chat, otro para MCP y otro para Autopilot: hay uno, y cada consumidor tiene su perfil sobre él.
Los agentes de Autopilot tenían diez herramientas de lectura propias, envoltorios finos sobre endpoints que el ejecutor ya servía. Han desaparecido. Ahora cada agente lee del MCP de KubeBolt con su propio perfil, detrás de una puerta que solo admite tokens de servicio: un usuario con sesión en el navegador es rechazado sea cual sea su rol, y una clave de API se rechaza por tipo. Un perfil que nombre una herramienta que no existe no arranca, en vez de servir menos en silencio.
La consecuencia práctica es que una lectura escrita para Kobi llega a Autopilot el mismo día. Se ve en lo que ganaron los agentes:
- El investigador gana ráfagas, historial y métricas de workload. Una ráfaga de nodo explica a su víctima, una recurrencia dice que el último reinicio solo aplazó el problema, y el uso medido decide entre un OOM y un estrangulamiento en vez de adivinarlo.
- El planificador dimensiona un parche de recursos con uso real, no repite un reinicio que ya falló, y dice si un rollback aterriza en una imagen con un CVE crítico. Lo dice; no lo bloquea.
- Las acciones se quedan donde estaban, en el servidor propio de Autopilot, junto a las aprobaciones, los namespaces bloqueados y la puerta de lo destructivo. Nunca en el
/mcppúblico. Y como solo el agente que actúa lo monta, los otros cuatro han dejado de pagar unos 34.000 tokens por incidente en esquemas que tenían denegados.
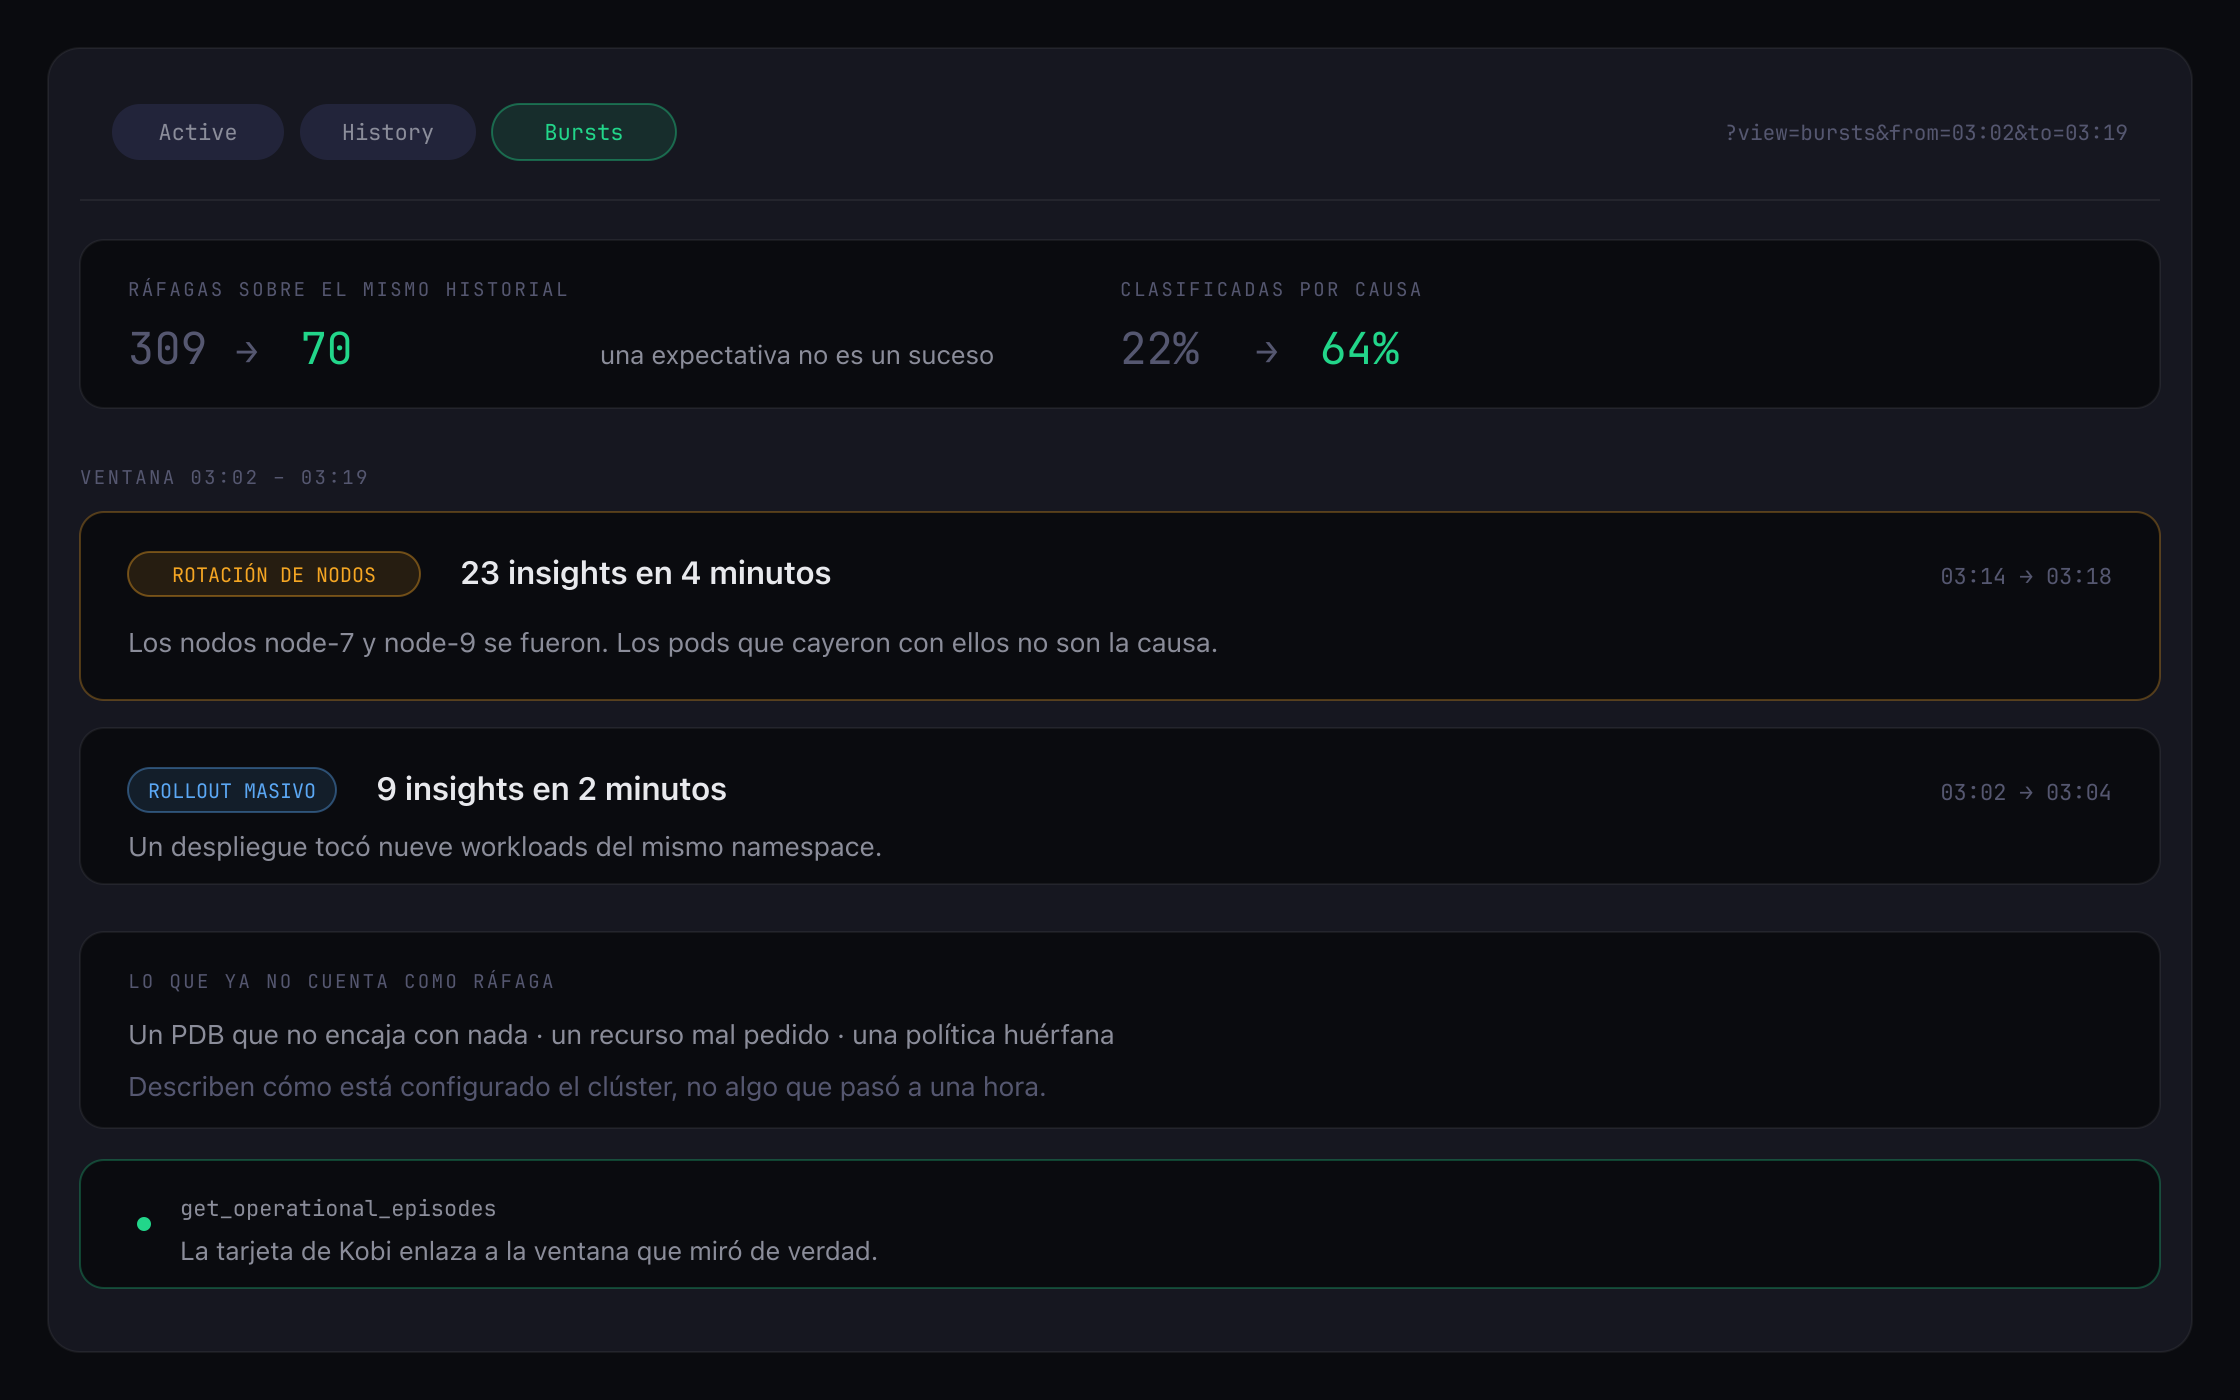
Las ráfagas de la figura también mejoraron por su cuenta. Solo las malfunciones forman ráfaga: una expectativa, como una política huérfana o un PDB que no encaja con nada, describe cómo está configurado el clúster, no algo que pasó a una hora, y el tic de evaluación las sellaba todas con la misma marca de tiempo. Reproducido sobre un historial real, de 309 ráfagas a 70, y la proporción clasificada por tipo del 22 % al 64 %. Ahora tienen su propio segmento en /insights?view=bursts, con la ventana en la URL, así que una ráfaga se puede enlazar y la tarjeta que dibuja Kobi apunta exactamente a lo que miró.
Lo que hizo falta para que las respuestas quepan
Dar más herramientas a un agente no sirve de nada si las respuestas se cortan. Y se estaban cortando.
list_resources y get_cluster_overview devolvían lo que dibuja la pantalla. Catorce pods de kube-system ocupaban 41 KB entre anotaciones, volúmenes, entorno, la especificación entera de cada contenedor y todas las condiciones. El tope de una respuesta de herramienta son 32 KB. La respuesta se cortaba por la mitad y nadie se enteraba, porque truncar no es un error: el modelo recibía algo con la forma correcta y contaba dieciocho pods donde había catorce.
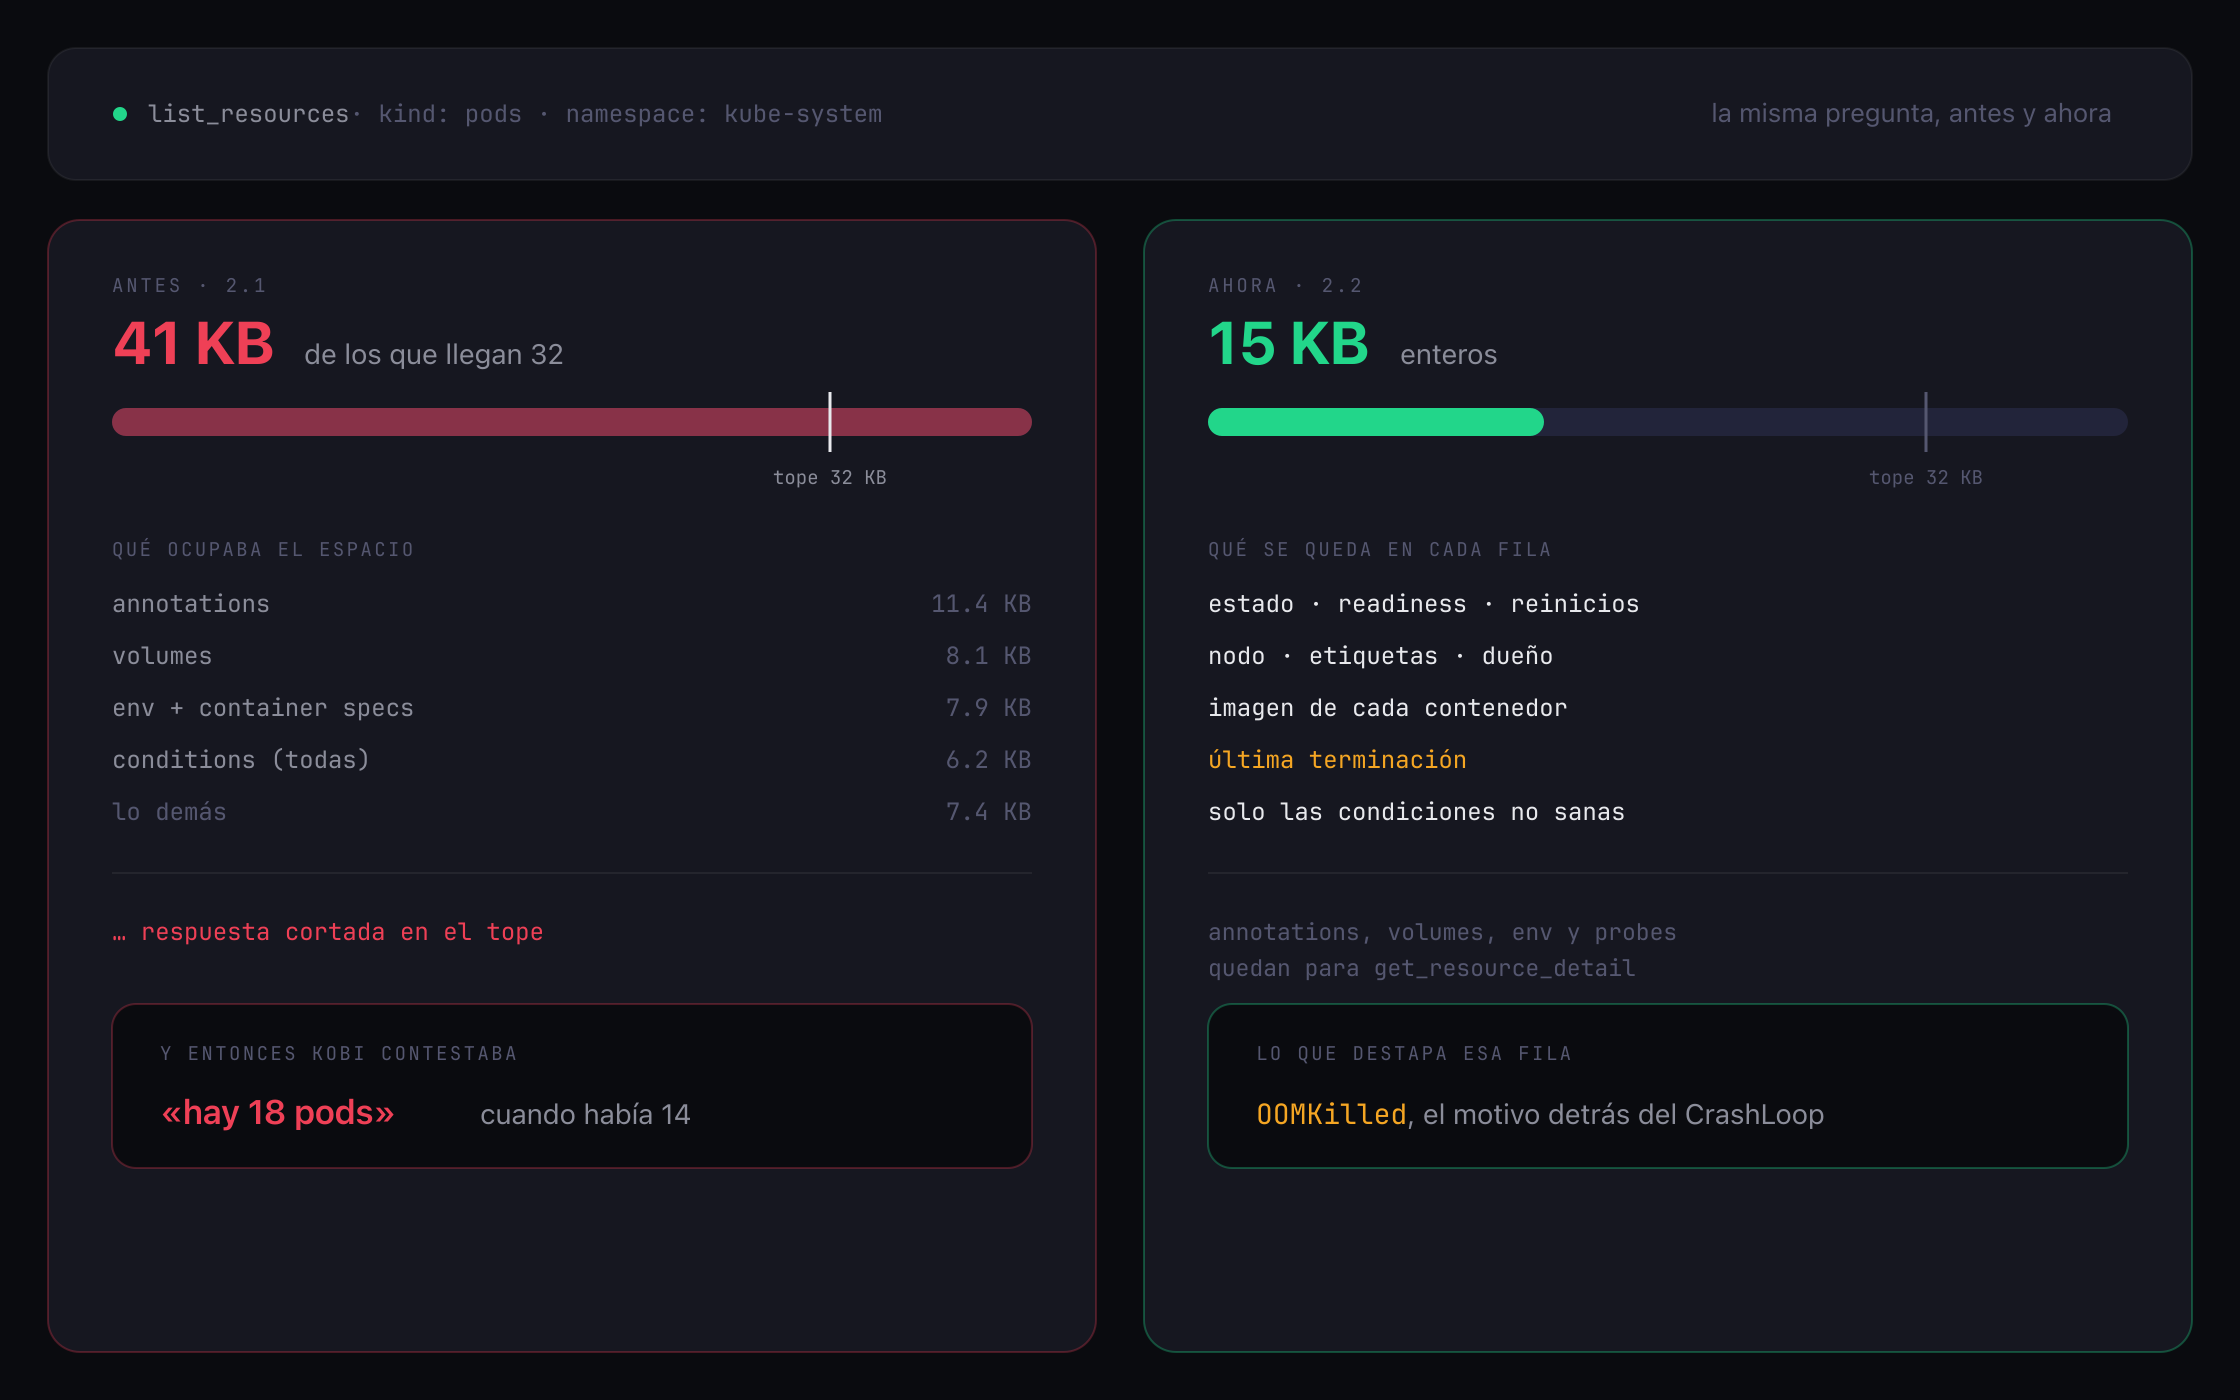
Ahora cada fila se queda con lo que se usa para diagnosticar: estado, disponibilidad, reinicios, nodo, etiquetas, el dueño como Kind/nombre, la imagen de cada contenedor, sus recursos y la última terminación, que es el OOMKilled que hay detrás de un CrashLoop. De las condiciones solo viajan las que no están sanas. Lo demás se queda para get_resource_detail, y la respuesta lo dice, que es la parte que importa: el agente sabe que hay más y sabe dónde pedirlo. De 41 KB a 15, y la vista de clúster de 38 a 10.
La API REST y la interfaz no cambian. Esto es lo que leen los modelos.
En la misma línea van dos arreglos pequeños que quitan mucha fricción a un cliente externo. Los tipos de recurso se aceptan como los nombra Kubernetes, en singular o plural y con cualquier caja: antes solo entraba la clave plural, los modelos escriben pod y Pod, y casi todas las llamadas a describe fallaban por eso. Y un list_resources sobre un CRD que no está instalado contesta «no instalado» en vez de «prohibido», que mandaba a la gente a pelear un permiso de RBAC para una API que no existía.
Empieza por aquí
Si ya operas KubeBolt: actualiza a 2.2.0 y el agente a 1.4.1, que es un parche de seguridad con el mismo esquema de métricas y entra sin tocar nada más. Luego crea una clave MCP only, márcale un clúster de pruebas, y pégala en el cliente que ya tengas abierto.
Si todavía no, empieza gratis: dos clústeres, sin límite de tiempo, y el servidor MCP incluido desde el primer día.
La primera pregunta que merece la pena hacer es una que antes no tenía respuesta. Qué se desplegó en la última hora, o qué workload acumula más hallazgos.