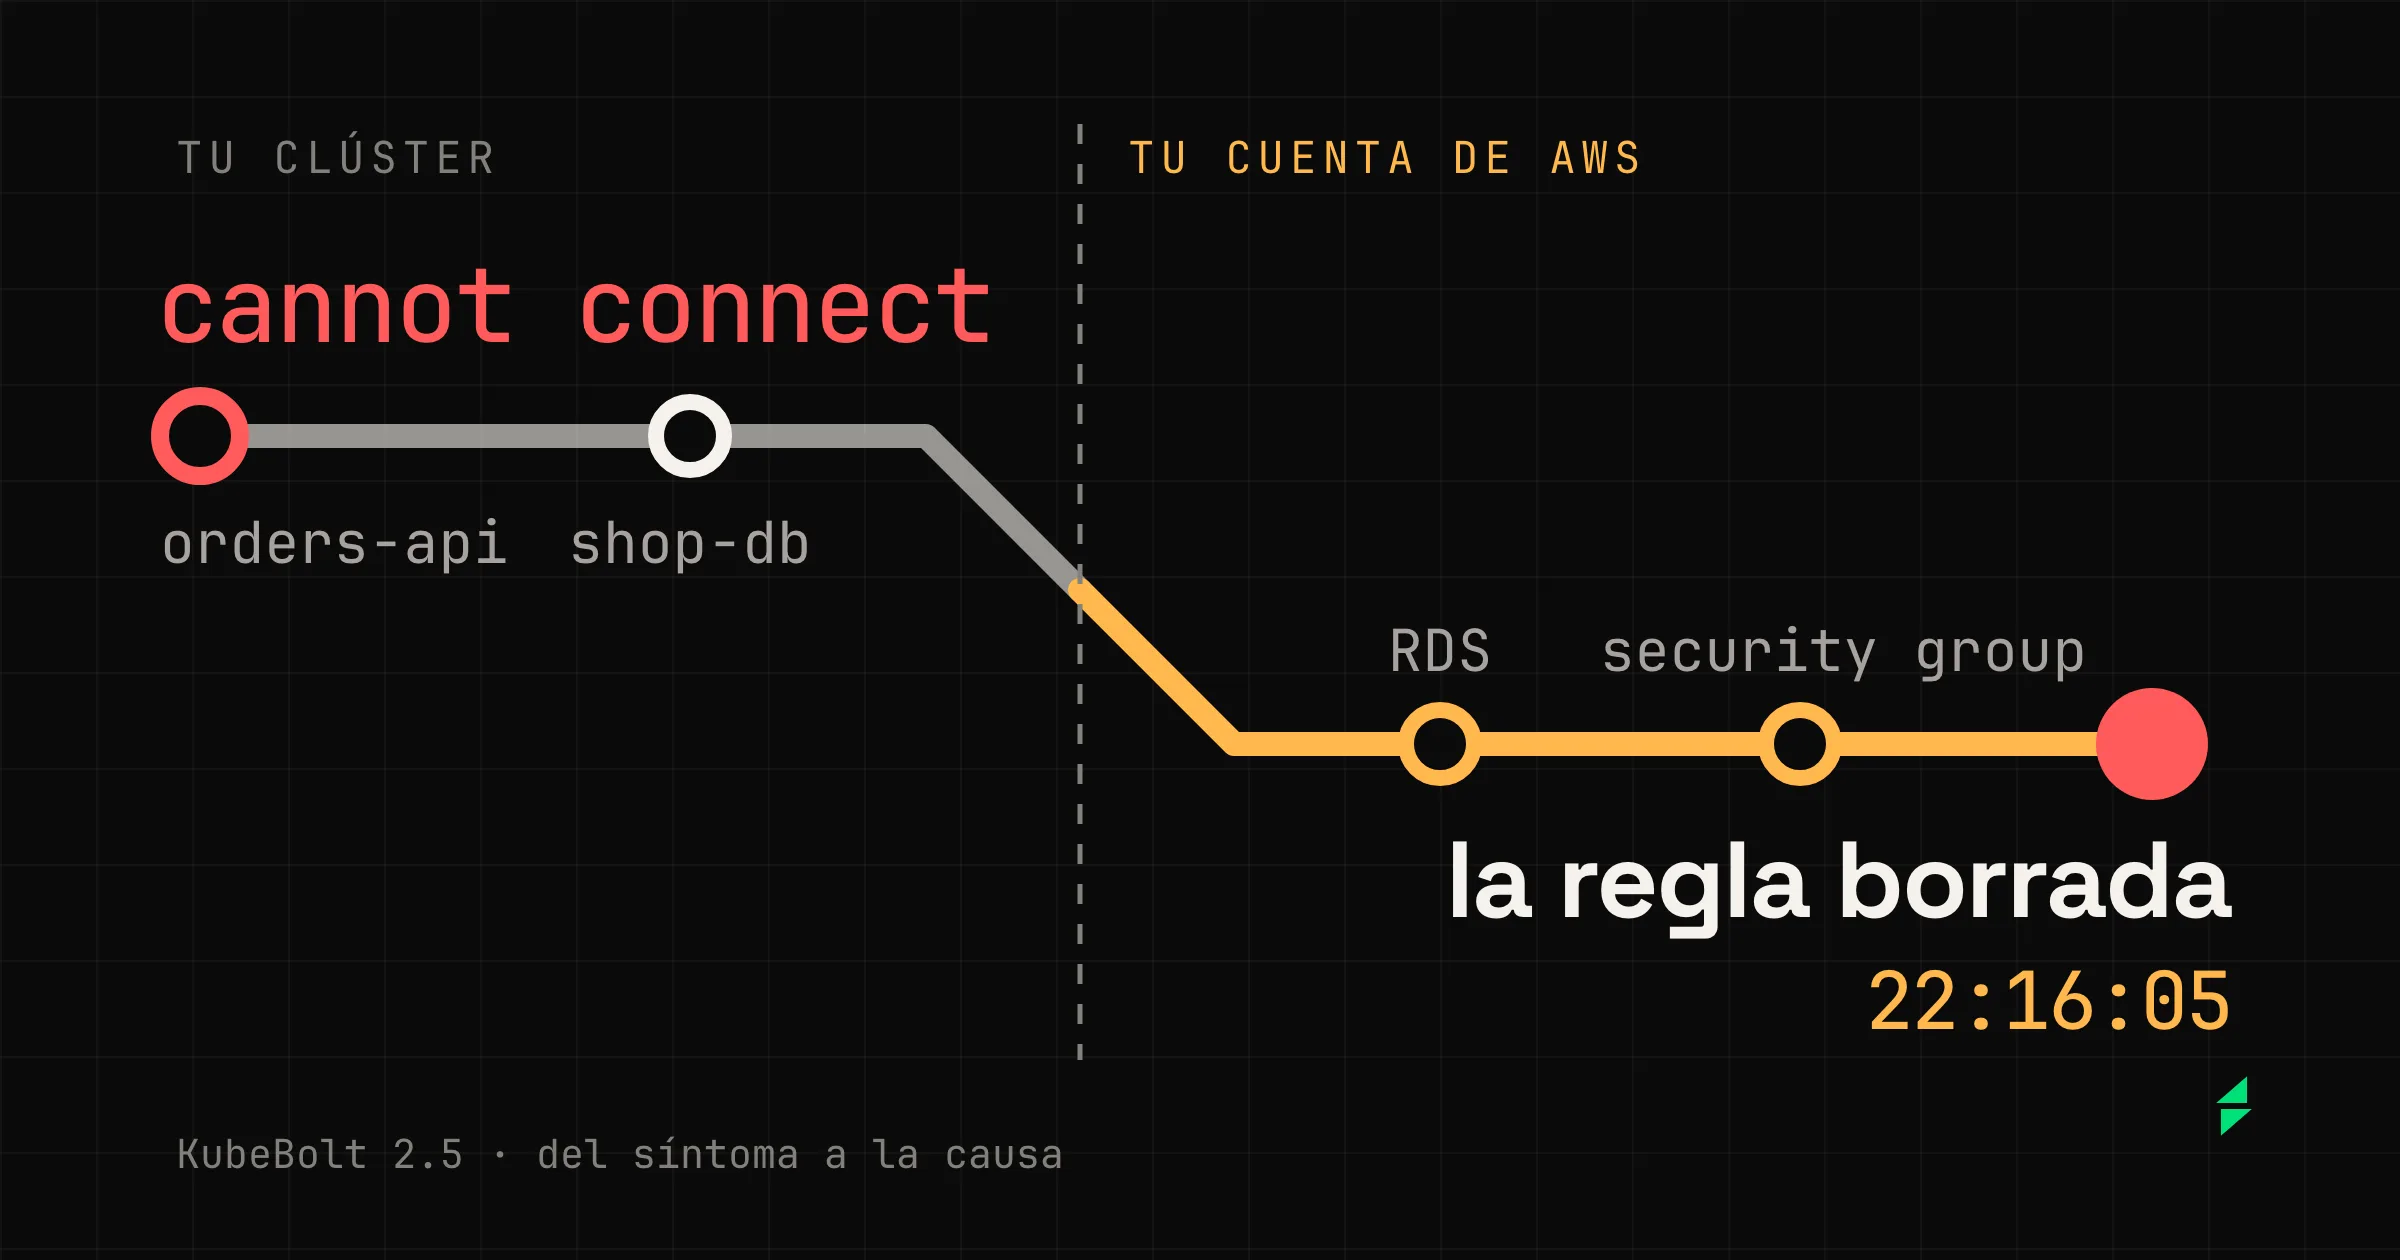
Hasta la 2.4, cuando una aplicación no llegaba a su base de datos, la evidencia de Kobi se acababa en cannot connect. Podía decirte que la dependencia no respondía, pero no por qué: la causa estaba en una cuenta de nube que no podía leer.
En la 2.5, Kobi y Autopilot siguen la investigación hasta tu cuenta de AWS. Eso nos dejó una regla para el resto de la versión: cuanto más lejos llega Kobi, más tiene que enseñarte. Si va a leer tu cuenta, tienes que ver qué lee, con qué modelo y cuánto cuesta.
Aquí repaso esas tres cosas con una investigación real de nuestro laboratorio, y al final resumo el resto. Si solo quieres saber qué trae la 2.5:
- Kobi y Autopilot leen tu cuenta de AWS, solo lectura. En KubeBolt Cloud, desde el plan Team. En la versión open source, también Azure.
- Kobi sabe qué es cada dirección que llama un workload: algo del clúster, otro de tus clústeres, un servicio de la nube o algo de fuera.
- Cada paso de una investigación dice qué leyó y qué volvió, y una marca señala dónde sale del clúster.
- Kobi puede empezar con un modelo pequeño y pasar a uno más fuerte al salir del clúster, y cada modelo se cobra a su precio.
- Una ejecución de Autopilot se lee de arriba abajo, igual en vivo que después de recargar la página.
Antes de salir, saber qué es cada dirección
Una dirección en una variable de entorno puede ser un Service del clúster, el balanceador de otro de tus clústeres o un RDS. Hasta ahora Kobi lo deducía. La herramienta nueva, get_external_connections, lee los flujos de Hubble, o la configuración del workload si no tienes Hubble, y clasifica cada dirección:
| Lo que encuentra | Lo que Kobi puede hacer |
|---|---|
| Algo dentro del clúster | Seguir con sus lecturas de siempre |
| Un servicio de la nube: un endpoint de RDS, una zona privada de Route 53 en un clúster de AWS, un bucket en una variable de entorno | Leerlo con el conector, si tienes uno activo |
| El balanceador de otro clúster que tienes en KubeBolt | Ofrecerte cambiar a ese clúster |
| Algo de fuera | Decirte que está fuera de tu infraestructura |
La entrada también cuenta. Una lectura de un Ingress o de un Service LoadBalancer dice ahora cómo llegan las peticiones de fuera, con los target groups en EKS. Por eso un pod sano detrás de un balanceador enfermo ya no se lee como «funciona».
Cómo se lee una investigación
Hasta la 2.4, una investigación era una pared de tarjetas con el nombre de cada herramienta, y nada resumía lo leído. Para saber qué había mirado Kobi tenías que abrirlas una a una.
Esta es una de las del laboratorio. Alguien borró del security group de la base de datos la regla que dejaba entrar a los pods, y le preguntamos a Kobi por qué fallaba la tienda. El incidente entero está en la comparación con AWS DevOps Agent:
1El resumen: cuánto tardó, qué leyó y qué no pudo leer. Al terminar, los pasos se pliegan debajo.
2Cada paso dice qué leyó y, debajo, qué volvió. Esa línea cuenta y lista, nunca interpreta.
3Los logs ya traen cuánto duró: aquí, la ráfaga de errores de 22:16 a 22:27.
4Quién escribió el recurso, cómo y cuándo. Kobi ya no tiene que deducirlo.
5Dónde sale del clúster, y con qué permiso: solo lectura.
6Una negativa de AWS se queda a la vista y sube al resumen como «1 could not be read».
Mientras Kobi trabaja, una barra encima del cuadro de texto lleva el tiempo, las lecturas, una marca por cada nube y el botón de parar. Si leyó una nube, la respuesta termina con una nota que lo dice, aunque tengas las tarjetas ocultas.
La lectura de Route 53 es la que más me importa de esta vista. El rol del laboratorio la negaba, así que Kobi escribió en su respuesta que no había podido verificar ese nombre.
Con la negativa a la vista, sabes qué parte de la conclusión tienes que comprobar tú.
El modelo sigue al trabajo
La mayoría de las preguntas no salen del clúster, y para esas basta un modelo pequeño. Con un modelo de escalada, Kobi empieza con el que tienes configurado y pasa a uno más fuerte, para el resto de la conversación, la primera vez que sale del clúster seleccionado: un conector de nube, get_external_connections o un cambio de clúster.
Lo medimos con Haiku 5.5 y Sonnet 5.5 en nuestros casos de evaluación. Dentro de un clúster costó lo que cuesta Haiku, con los mismos resultados: escaló 1 conversación de 57. Cuando la investigación sale del clúster cuesta lo que cuesta Sonnet y lee la nube como Sonnet, salvo los primeros pasos, que son de Haiku.
Esta es la conversación de arriba, con su precio:
Las 7 rondas
Lo que mostraba el panel de la 2.5.0, todo a precio de Sonnet
Lo que costó, cada modelo a su precio
- 5 rondas de Haiku0,014
- 2 rondas de Sonnet0,039
- Escribir la conversación en la caché de Sonnet0,165
Dos cosas de esta figura:
- La mayor parte del coste es el cambio. Cada modelo tiene su propia caché de prompt, y al pasar a Sonnet hay que escribir en ella la conversación entera: 0,165 de los 0,218 USD. Escalar tiene un precio, y conviene saberlo antes de activarlo.
- El primer panel lo contaba mal. La 2.5.0 open source ponía todo el turno al precio del modelo con el que acababa, y esta conversación salía a 0,456 USD. La 2.5.1 lo corrige, y la 2.5.0-e2 de Cloud y Enterprise ya salió con el arreglo. El detalle de la sesión nombra los dos modelos, por qué cambió y qué costó cada uno. En Cloud, Usage & Credits enseña los mismos créditos que se cobran.
El tope de respuesta también sigue al modelo: 16384 tokens donde el razonamiento cuenta contra él y 4096 en el resto. Haiku 5.5 ya no se corta a media respuesta.
Una ejecución de Autopilot, de arriba abajo
El investigador, el planificador y el postmortem de Autopilot leen la nube con el mismo conector. Hasta la 2.4, una ejecución era una línea de fases que se veía distinta en vivo y después de recargar. Ahora es un hilo que cuenta las cosas en el orden en que pasaron, igual en los dos casos:
1La cabecera dice cómo acabó, no solo que acabó.
2Cada etapa se pliega en lo que concluyó. En una ejecución real también lleva su tiempo y su gasto.
3Cada lectura dice qué volvió, y la marca de nube aparece antes de la primera.
4Si la causa está donde Autopilot no puede actuar, lo dice y te pasa el caso.
Mientras corre, el hilo enseña:
- Antes de empezar: si está en cola,
Queued · 6:30y el motivo. - Cada etapa: su capa, su modelo, o «2 attempts» si hubo reintento, su tiempo y su gasto. La barra del límite de tiempo se pausa mientras alguien decide una aprobación.
- Cada aprobación: qué se pide, cuánto lleva esperando y quién decidió.
- Cada cambio: qué le hizo al clúster.
Cuando termina, cada etapa se pliega en lo que concluyó y la cabecera dice cómo acabó: Resolved · verified · 0:33, o Needs a human · 4:05.
Y cambian dos cosas en lo que se cobra, que prefiero contar aquí. Una etapa que falla ahora registra y cobra lo que gastó, y antes no dejaba rastro. Cada intento se cobra a su modelo, y antes los tokens de un intento fallido se sumaban a los del modelo de reserva y salían a su precio.
Lo que Kobi ya no tiene que deducir
Buena parte de una investigación era deducir cosas que el clúster ya guarda. Ahora las lee:
- Qué cambió en cada revisión, y a cuál volvería un rollback.
- Quién escribió un recurso, cómo y cuándo, por sus field managers. Las escrituras de KubeBolt llevan ahora el suyo,
kubebolt. - Cuánto duró un error. Los logs traen las ráfagas con su inicio y su fin, y una línea que se repite sale una vez, con su cuenta. En un error de autorización de AWS, además, cada acción y recurso denegados.
- Las credenciales se quedan fuera. Una credencial escrita como valor de una variable de entorno ya no entra en las lecturas de Kobi.
Además, 17 procedimientos de KubeBolt, de un crash loop a un rollback, van incluidos, y Kobi los carga cuando los necesita. No cuestan nada en los turnos que no los usan.
Si instalas KubeBolt tú mismo
- Actualizar: en open source, la 2.5.1 con el agente 1.4.6, sin migración. Si tu fichero de valores fija
copilot.maxTokens: 4096, quítalo para usar el tope por modelo. - El modelo de escalada: se elige en Escalation model, en la tarjeta del proveedor principal, o con
KUBEBOLT_AI_ESCALATION_MODEL. - Azure: en open source, el conector funciona con un sidecar junto a la API.
- Cualquier endpoint compatible con OpenAI, en Enterprise: el motor gateway de Autopilot habla con OpenRouter, LiteLLM, vLLM o un servidor local, y lleva modelos como GLM o Kimi por el mismo proceso. Es opcional.
- Planes sin modelo, en Enterprise:
autopilot.executor: codeejecuta un plan aprobado sin modelo, con las mismas barreras, y comprueba antes de actuar que el problema sigue ahí. - Una ServiceAccount por producto, en Enterprise: la web y Autopilot dejan de llevar la identidad de la API.
Lo que todavía no es
En Cloud y en Enterprise solo está disponible AWS. Azure aparece como «Soon»: funciona, pero firma con una identidad por instancia, y en Cloud cada organización necesita la suya. Google Cloud aparece como «Soon» en todas las ediciones.
Y el conector solo lee. Si la causa está en tu cuenta, Kobi te da el comando para arreglarla, pero no lo ejecuta.
Lo que queda
Conectar Kobi a tu cuenta era la mitad del trabajo. La otra mitad era que puedas seguirlo: qué lee paso a paso, con qué modelo y cuánto cuesta cada parte. Cuanto más lejos llega, más tiene que enseñarte.
Las pruebas que hicimos antes de soltarlo están en Kobi en AWS: diez incidentes y dónde fue cada arreglo.